用看板治理AI上下文膨胀:并行Agent实战方案
用看板系统为AI Agent构建结构化外部记忆,解决上下文膨胀痛点
随着AI编程助手深度介入开发,上下文膨胀成为关键瓶颈——模型的注意力衰减、成本飙升、记忆丢失。一位开发者提出用看板(Kanban)作为AI Agent的结构化外部记忆层,将任务状态从对话窗口转移到持久化的任务板上,并结合git worktree实现多Agent并行隔离工作,通过脚本化生命周期管理控制成本。这代表了AI Agent记忆管理从"更大窗口"转向"更聪明组织"的工程趋势。
AI上下文膨胀,为什么成了绕不开的痛点
随着大模型编程助手深度介入日常开发,一个越来越普遍的困扰浮出水面:上下文膨胀(context bloat)。当项目变得复杂、对话变长,AI助手需要在有限的上下文窗口里塞进越来越多的历史信息、代码片段和任务状态,结果往往是效率骤降、记忆丢失、前后逻辑不一致。
要理解这个问题的根源,需要了解大语言模型的上下文窗口(context window)机制。上下文窗口是模型在单次推理中能够"看到"的全部文本长度,以token为单位计量。这里的token并非直观的字符或单词——对于英文文本,1个token大约对应4个字符或0.75个单词;中文则通常1-2个字符对应1个token。以GPT-4为例,其上下文窗口从早期的8K token扩展到128K token(大约能容纳一本300页的书),Claude 3系列则支持200K token。但token数量的增长并不能根本解决问题:一方面,Transformer架构的自注意力机制需要计算序列中每个token与其他所有token的关联权重,形成一个n×n的注意力矩阵,计算复杂度为O(n²)。当n从8K增长到128K时,理论计算量增长256倍。虽然FlashAttention等优化技术大幅提升了实际计算效率,但随着上下文变长,模型容易出现"中间遗忘"现象——对上下文头部和尾部信息保持较好的注意力,但对中间段落的召回率显著下降。斯坦福大学和UC Berkeley的研究(2023年)通过实验证实,当关键信息被放置在长上下文的中间位置时,模型的提取准确率可下降超过20个百分点,研究者将此称为"Lost in the Middle"效应。这一发现对AI编程助手的影响尤为显著——开发者在长对话中间提出的需求变更,很可能被模型"遗忘"。
另一方面,更长的上下文意味着更高的API调用成本和推理延迟。以2024年的API定价为参考,GPT-4的输入token价格约为每百万token 30美元,输出约60美元,一次塞满128K上下文的调用仅输入成本就接近4美元。对于频繁交互的编程助手场景,上下文膨胀直接转化为账单膨胀,这使得上下文管理不仅是技术问题,更是经济问题。因此,即便上下文窗口不断扩大,合理的上下文管理策略仍然是工程实践中的刚需。
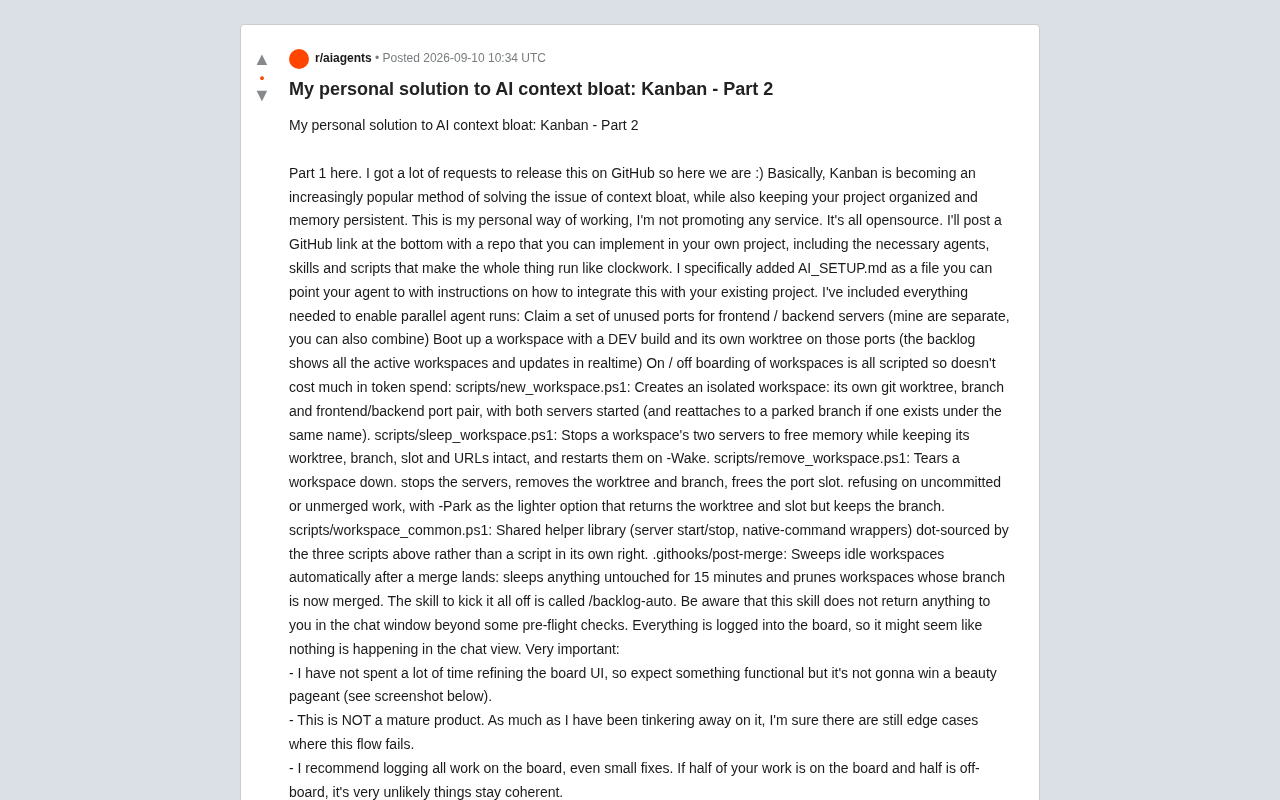
一位Reddit开发者在其分享的"Kanban治理方案"第二部分中,给出了自己的解法:用看板(Kanban)来组织项目、持久化记忆,并把上下文压力从对话窗口转移到结构化的任务板上。他强调这套方案完全开源、不推销任何服务,纯粹是个人工作流的沉淀,并应社区要求把它从自己的项目里"抽离"出来放到了GitHub上。
这个思路的价值在于:与其把所有状态都堆在一次次对话里,不如让AI把工作项写进看板,需要时再按需读取。看板成了一个共享的、可持久化的外部记忆层,从根本上缓解了单次对话的上下文负担。
核心设计:让AI Agent与看板协同工作
看板方法论:从制造业到AI Agent协作
在深入技术细节之前,值得回顾看板(Kanban)方法论的渊源。看板最初源自丰田生产系统(TPS),由大野耐一在1940年代末提出,用于实现准时制生产(JIT)。"看板"在日语中意为"信号卡"或"视觉板",其核心理念是通过可视化工作流、限制在制品数量(WIP limit)、以拉动方式驱动任务流转。2004年,David J. Anderson将其引入软件开发领域,形成了"看板方法"。
在AI Agent工程中借用看板,本质上是将看板从人与人之间的协作工具,扩展为人与AI Agent之间的状态同步机制——看板上的每张卡片既是对人类可见的任务状态,也是Agent可以程序化读写的结构化数据。看板方法中的WIP(Work In Progress)限制在这一场景下获得了新的含义:它不仅约束任务数量,还间接约束了Agent在单次推理中需要加载的上下文量。每张卡片承载的信息量是有界的,Agent只需读取当前WIP范围内的卡片即可获得足够的工作上下文,而非加载整个项目历史。
一个可被Agent直接读取的项目入口
作者特意设计了一份 AI_SETUP.md 文件,作用是让你把AI助手"指向"它,AI就能读懂如何把这套看板系统集成进现有项目。这是一个很实用的工程细节——与其口头向AI解释一堆规则,不如给它一份结构化的接入说明文档,让集成过程标准化、可复用。
这一设计反映了一种正在兴起的工程实践:为AI编写专门的机器可读文档。与传统的README面向人类阅读不同,AI引导文档需要遵循特定的设计原则——使用明确的指令语气而非描述语气,提供具体的文件路径和操作步骤而非概念性说明,避免歧义和隐含假设。Anthropic在其官方文档中推荐的CLAUDE.md、Cursor的.cursorrules文件、以及社区中流行的.clinerules等,都属于这一范式。这些文件本质上是对AI Agent的"入职培训手册",其质量直接影响Agent的工作效果。
配套的 README.md 则包含了更完整的系统说明。整套方案把"AI如何使用看板"这件事,做成了可以被机器直接消费的说明书,而不仅仅是给人看的文档。
所有工作都必须记录在看板上
作者反复强调一个原则:所有工作都应该记录在看板上,哪怕是很小的修复。他的原话是——如果一半工作在板上、一半在板外,那么整个系统几乎不可能保持连贯(coherent)。
这其实点出了外部记忆方案的关键约束:记忆的完整性依赖于纪律性。看板作为AI的持久化记忆,只有当所有状态变更都被如实登记时,它才能真正替代不断膨胀的对话上下文。任何"漏记"都会让AI的世界观出现盲区。
并行Agent运行:这套方案最硬核的部分
这套方案真正有工程含量的地方,在于它支持并行Agent运行——多个AI工作流可以同时在不同的隔离环境里推进任务,互不干扰。作者用一整套PowerShell脚本实现了工作区(workspace)的完整生命周期管理。
这也呼应了AI Agent并发执行领域更广泛的行业探索。2024-2025年间,Anthropic的Claude Code、OpenAI的Codex Agent、以及Devin等AI编程助手都在探索多Agent协作模式。业界主要有几种路线:长上下文方案依赖不断扩大的上下文窗口;RAG(检索增强生成)方案通过向量数据库按需检索信息片段;而本文展示的结构化外部记忆方案,则用显式的任务管理系统作为Agent的"工作记忆"。微软的AutoGen框架、LangChain的LangGraph等也在探索多Agent编排。这些方案的共同挑战在于:如何在保持Agent自主性的同时,确保状态一致性和人类的可观测性。看板方案在可观测性上有天然优势——看板本身就是一个可视化的状态管理界面。
基于git worktree的工作区隔离机制
git worktree是Git 2.5(2015年发布)引入的一项重要功能,允许在同一个仓库下同时检出多个工作目录,每个目录对应不同的分支。传统做法中,开发者如果需要同时处理多个分支,要么频繁切换分支(导致未提交的改动冲突),要么克隆多份仓库(浪费磁盘空间且.git历史不共享)。git worktree的优势在于:所有worktree共享同一个.git对象库,因此磁盘开销极小;各worktree之间文件系统完全隔离,不会互相干扰;分支锁定机制还能防止两个worktree意外检出同一分支。
在本方案中,每个AI Agent任务被分配独立的worktree,每个工作区都拥有:
- 独立的git worktree和分支:不同任务在物理上隔离,避免代码互相污染。多个Agent可以同时修改不同分支的代码,编译和运行各自的开发服务器,而不会产生任何文件冲突。
- 独立的前后端端口对:作者的前后端服务是分离的(也支持合并),系统会自动为每个工作区认领一组未被占用的端口。在前后端分离架构中,前端开发服务器(如Vite默认监听5173端口)和后端API服务器需要各自占据独立端口,并通过CORS或代理配置相互通信。当多个Agent同时运行时,若不做端口隔离,会出现端口冲突(EADDRINUSE错误)。本方案通过脚本自动扫描可用端口并分配,类似于Docker Compose中的端口映射机制,但更轻量——不需要容器化的开销,同时保留了直接调试的便利性。
- 独立的DEV构建和服务实例:工作区启动后即在专属端口上运行开发构建,看板会实时显示所有活跃工作区的状态。
脚本化的上下线,控制Token开销
作者特别提到,工作区的上下线全部脚本化,因此几乎不消耗Token——这是一个很务实的成本考量,因为如果这些管理动作都交给AI来做,会白白烧掉大量额度。核心脚本包括:
scripts/new_workspace.ps1:创建隔离工作区,包含worktree、分支、端口对,并启动两个服务;若存在同名的"停靠"分支则自动重新挂载。scripts/sleep_workspace.ps1:停掉工作区的两个服务以释放内存,但保留worktree、分支、端口槽位和URL,可用-Wake参数重启。scripts/remove_workspace.ps1:彻底拆除工作区,停服、删worktree和分支、释放端口槽位;若存在未提交或未合并的工作会拒绝执行,-Park是更轻量的选项,归还worktree和槽位但保留分支。scripts/workspace_common.ps1:共享辅助库,被上述三个脚本以dot-source方式引用。
关于dot-source(点源引用),这是PowerShell中的一种脚本加载方式,语法为 . .\\\\script.ps1(注意前面的点和空格)。与普通的脚本调用不同,dot-source会将被引用脚本中定义的函数、变量和别名直接注入到当前作用域中,而非在子作用域中执行后丢弃。这类似于Bash中的 source 命令或C语言中的 #include。在本方案中,workspace_common.ps1 作为共享辅助库被dot-source引用,确保端口管理、路径解析、状态检查等公共逻辑只需维护一份代码,同时这些公共函数可以直接在调用脚本的上下文中执行。
自动化的"垃圾回收"机制
更值得称道的是自动化清理机制。.githooks/post-merge 这个git钩子会在每次合并落地后自动清扫闲置工作区:把闲置超过15分钟的工作区休眠,并清理掉分支已合并的工作区。
git hooks是Git内置的事件驱动脚本机制,在特定的Git操作前后自动触发。Git支持约20种hooks,分为客户端hooks(如pre-commit、post-merge、prepare-commit-msg)和服务端hooks(如pre-receive、post-receive)。本方案使用的post-merge hook在每次 git merge 成功完成后触发。值得注意的是,git hooks默认不会随仓库clone传播——这是出于安全考虑,防止恶意仓库自动执行代码。因此本方案将hooks放在 .githooks/ 目录下并需要手动配置(通过 git config core.hooksPath .githooks 指定),这也是业界的常见做法。利用post-merge自动清理已合并分支对应的工作区,是一个优雅的设计——它确保了资源回收与代码合并这个自然节点绑定,无需人工干预。
此外作者还用Windows任务计划程序(Task Scheduler)跑一些巡检,确保没有服务被无限期挂着。Windows任务计划程序是Windows系统内置的作业调度服务,可以基于时间触发、事件触发或条件触发来执行脚本或程序,功能类似于Linux系统中的cron守护进程。这一选择体现了方案当前对Windows/PowerShell生态的依赖,对于使用macOS或Linux的开发者,等效的替代方案包括cron、systemd timers或launchd。作者也贴心地说明,如果不需要这套巡检,直接"拔掉"即可——暗示了方案的模块化设计,核心的看板逻辑与平台相关的调度机制是解耦的。
启动方式与几点务实的提醒
整个流程的启动技能叫 /backlog-auto。作者提醒,这个技能除了一些预检(pre-flight checks)外,不会在聊天窗口返回任何东西——所有进展都写进看板,所以从对话视角看会"像什么都没发生"。这恰恰是设计意图:把状态从对话里剥离出去,正是治理上下文膨胀的核心。
作者也非常坦诚地列出了这套方案的边界:
- UI并不精致:看板界面功能可用但"不会赢得选美比赛",作者没在美观上花太多精力。
- 不是成熟产品:尽管持续打磨,仍可能存在导致流程失败的边缘情况。
- 纪律性优先:再次强调所有工作都应上板,避免板内板外割裂。
作者笑称,为了把这套系统从自己的项目里"解耦"出来单独放到GitHub仓库,他"花光了整个Claude Code 5x的会话额度"——这也从侧面反映出,把一套深度耦合的个人工作流抽象成通用方案,成本并不低。
外部记忆是AI Agent工程化的重要方向
抛开这个具体项目本身,它折射出一个更大的趋势:随着AI Agent承担越来越多的实际开发工作,如何管理Agent的状态、记忆和并发,正成为一个真正的工程问题。
把上下文塞进对话窗口的做法有天然上限,而"看板+git worktree+脚本化生命周期"的组合,本质上是在为AI搭建一套结构化的外部记忆与执行沙箱。它让多个Agent可以并行、隔离、可回收地工作,而人类则通过一块可视化的板子来观察和干预,而不是盯着不断刷屏的纯文本窗口。
从更宏观的视角来看,这类方案位于AI Agent记忆管理的谱系之中。当前业界的探索大致覆盖三个层次:短期记忆(即上下文窗口本身)、中期记忆(如对话摘要、会话缓存)、以及长期记忆(持久化的外部存储)。看板方案本质上是一种结构化的长期记忆实现,它与RAG(检索增强生成)方案的区别值得深究。RAG自2020年由Meta AI提出以来,已成为解决大模型知识局限性的主流方案,其工作原理是将文档切分为chunk并通过嵌入模型转换为向量,存入向量数据库(如Pinecone、Weaviate、Chroma),推理时根据查询检索最相关的chunk注入上下文。RAG擅长处理"模型不知道的知识",但对于"模型需要追踪的状态"则力不从心——因为状态具有时序性和因果依赖,而向量相似度检索是无序的。看板方案恰好填补了这一空缺:它以显式的列(如"待办""进行中""已完成")来编码任务的生命周期状态,以卡片之间的关联来表达依赖关系,这些结构化信息在向量空间中很难被准确捕捉。两者并不互斥,反而可以互补——一个管"知道什么",一个管"在做什么"。
作者自己的评价很朴素:拥有一整块可以随意摆弄的看板,比只有一个纯文本窗口"要有趣得多"。对于正在被上下文膨胀困扰的开发者来说,这至少是一个值得借鉴的思路——问题的答案,可能不在于更大的上下文窗口,而在于更聪明的记忆组织方式。
核心要点
核心要点
相关推荐

对抗AI代码腐化:规格、结果笔记与文件清单的实战方法
一位开发者用八个月、650次提交、4.3万行代码的实战,总结出防止AI智能体代码库腐化的方法:前置规格与验收标准、任务结果笔记、文件清单约束,以及用触发式钩子取代规则文件。核心洞察是——指令只是建议,机制才能在长会话中存活。

"Tokens Exhausted":一段机器人视频背后的AI焦虑
一段名为「Tokens Exhausted」的机器人视频在 Reddit 引发热议,网友已分不清它是否为波士顿动力真实作品。本文解析这段AI讽刺内容为何戳中神经,以及它折射出的合成媒体与LLM时代焦虑。

4千美元淘到全新DGX Spark:本地部署大模型的性价比之选
一位Reddit用户以4000美元在Craigslist淘到全新DGX Spark,用于本地托管AI模型。本文解析这笔交易背后的性价比、二手交易安全,以及本地部署大模型的兴起趋势。