用可控合成对话训练更聪明的语音助手唤醒系统

论文为语音助手增加上下文推理层,区分唤醒后的真实指令与无关闲聊,并开源62.3小时合成对话数据集。
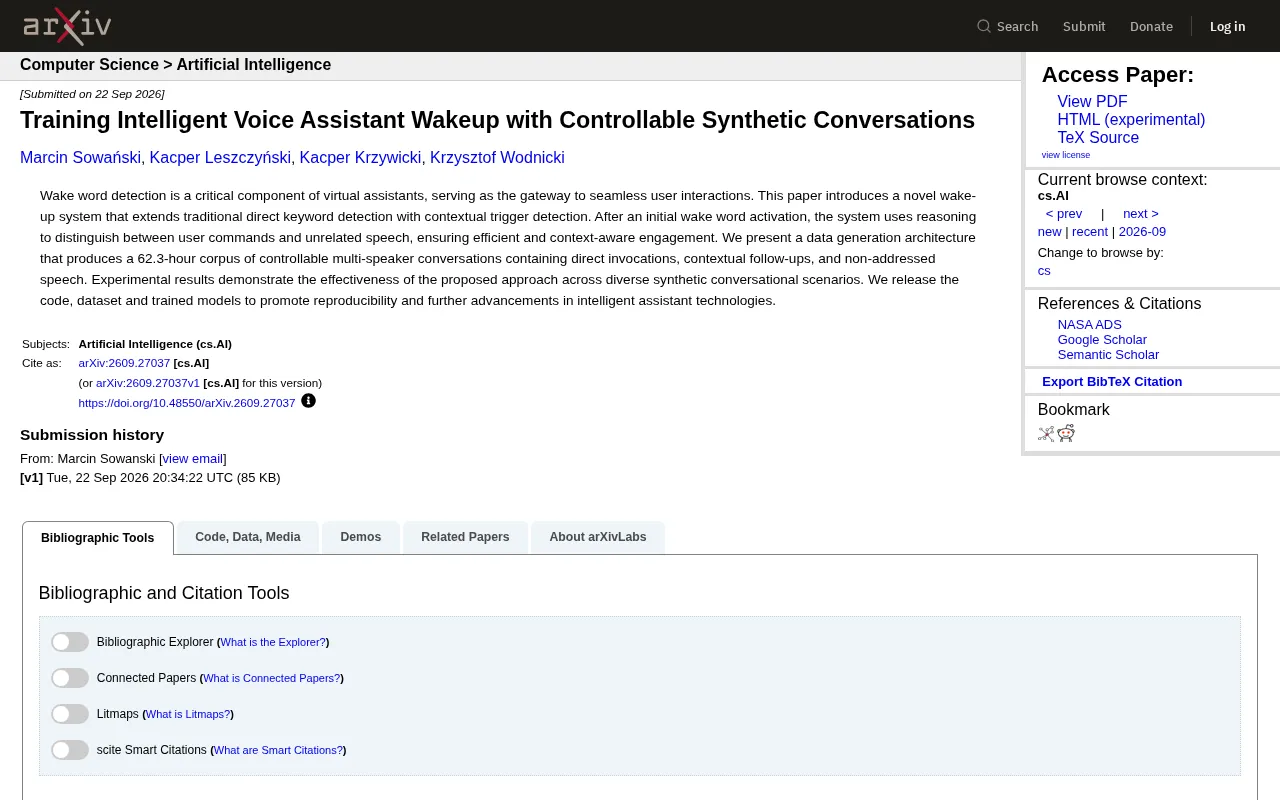
传统唤醒词检测只做关键词识别,无法判断用户激活助手后说的话是否真的针对它,容易在多人对话或闲聊场景中产生误响应。这篇arXiv论文在关键词激活的基础上引入"上下文触发检测"第二阶段,用推理能力区分"真实指令"与"非指向性语音"。为解决此类训练数据稀缺的问题,研究团队构建了一套可控的多说话人合成对话数据生成架构,产出包含直接调用、上下文跟进和非指向性语音三类场景共62.3小时的语料库,并将代码、数据与模型全部开源。实验证明该方法在多样化合成对话场景中有效,为降低语音助手误唤醒率提供了一条兼顾数据成本与可复现性的务实路径。
语音助手的第一步永远是「叫醒它」。无论是「Hey Siri」还是「小爱同学」,唤醒词检测(Wake Word Detection)都是人机交互的第一道门。但传统唤醒系统只做一件事:识别关键词。一旦被激活,它并不理解你接下来说的话是不是真的对它讲的。一篇最新的 arXiv 论文(arXiv:2609.27037)提出了一套新思路,试图让唤醒系统从「听到关键词」进化到「理解上下文」。
从关键词检测到上下文触发
传统唤醒机制的问题在于「一刀切」:只要检测到唤醒词就激活,之后所有语音都被当作有效指令处理。这在多人对话、环境噪声或闲聊场景下极易误触发。
论文提出的系统在传统的直接关键词检测之外,增加了一个**上下文触发检测(contextual trigger detection)**环节。核心逻辑是:在初次被唤醒词激活后,系统会用推理能力去区分——用户接下来说的到底是真正的指令,还是与助手无关的闲聊。
这意味着助手不再是被动的「关键词开关」,而是具备了一定的上下文感知(context-aware)能力。举个直观的例子:你说了唤醒词后,转头和旁边的人聊了几句,理想的系统应该判断出这几句不是对它说的,从而避免误响应。
上下文触发检测的技术实现通常依赖语言模型或小型分类器,对唤醒词激活后的后续语音片段进行意图归属判断。判断的关键维度包括:说话人是否在看向或靠近设备、语义内容是否包含可执行的任务意图、以及对话角色(是对人说话还是对机器说话)的隐性信号。与完整的自然语言理解(NLU)不同,上下文触发检测不需要深度解析指令语义,只需要做二分类:「针对助手」vs「非针对助手」,因此可以用较轻量的模型在端侧实时运行,不必依赖云端推理,这对延迟和隐私保护都有正面意义。
关键突破:可控的合成对话数据
要训练出能区分「指令」与「无关语音」的模型,最大的难点是数据。真实场景下的多说话人对话数据既难采集,又涉及隐私,还很难覆盖所有边缘情况。
论文的核心贡献之一是提出了一套数据生成架构,用于产出可控的多说话人合成对话语料。这套架构生成了一个 62.3 小时的对话语料库,其中包含三类关键场景:
- 直接调用(direct invocations):用户明确对助手下达指令;
- 上下文跟进(contextual follow-ups):延续前文的后续追问或指令;
- 非指向性语音(non-addressed speech):不是对助手说的话,比如人与人之间的闲聊。
「可控」二字是这套方法的价值所在。相比真实录音,合成数据可以精确控制说话人数量、对话类型的分布以及各种触发/非触发场景的比例,从而有针对性地强化模型对边界情况的判别能力。
合成对话数据的生成通常借助文本到语音(TTS)系统和大语言模型(LLM)协同完成:LLM负责生成多说话人对话脚本,TTS负责将文本渲染为不同音色、语速的语音波形,最后再叠加环境噪声和混响模拟真实录音条件。「可控」在工程上意味着可以通过配置文件精确指定每类场景的样本比例,例如设定30%为直接调用、40%为上下文跟进、30%为非指向性语音,从而解决真实数据中各类别严重不均衡的问题。这种数据生成范式近年在语音领域被广泛采用,但专门针对多说话人唤醒场景、且同时覆盖三类触发/非触发类别的系统化语料库此前并不多见。
实验效果与开源意义
论文的实验结果表明,所提出的方法在多样化的合成对话场景中都表现出有效性,能够较好地完成从直接唤醒到上下文判别的完整流程。
更值得关注的是研究团队的开放态度:他们公开了代码、数据集和训练好的模型。对于语音交互领域来说,高质量、可复现的多说话人对话数据本身就是稀缺资源。开源这套数据生成方法与语料库,意味着其他研究者可以在此基础上复现结果、继续迭代,而不必从零采集数据。
为什么这件事重要
随着智能助手进入越来越复杂的家庭和办公环境,「什么时候该响应、什么时候该沉默」正在成为体验的关键分水岭。误唤醒和误响应不仅打断用户,还带来隐私顾虑。
这篇论文的思路——把「唤醒」拆解为「关键词激活 + 上下文推理」两个阶段——代表了一个务实的方向:不追求让助手时刻在线倾听,而是在被叫醒之后,用轻量推理判断对话是否真的针对它。配合可控合成数据的训练范式,这类方法有望在降低数据成本的同时提升助手在真实多人场景下的稳健性。
对于开发者和研究者而言,这套开源的代码与数据是一个可以直接上手的起点;对于用户而言,它指向一个更「懂分寸」的语音助手未来。
相关推荐

Heretic 2.0 发布:从去审查到通用模型修改工具
Heretic 2.0 正式发布,新增任意秩消融(ARA)算法与插件系统,从去审查专用工具进化为可抑制废话、降低谄媚、调整情感对齐的通用模型修改平台。37k GitHub 星标,Hugging Face 衍生模型超 8500 个。
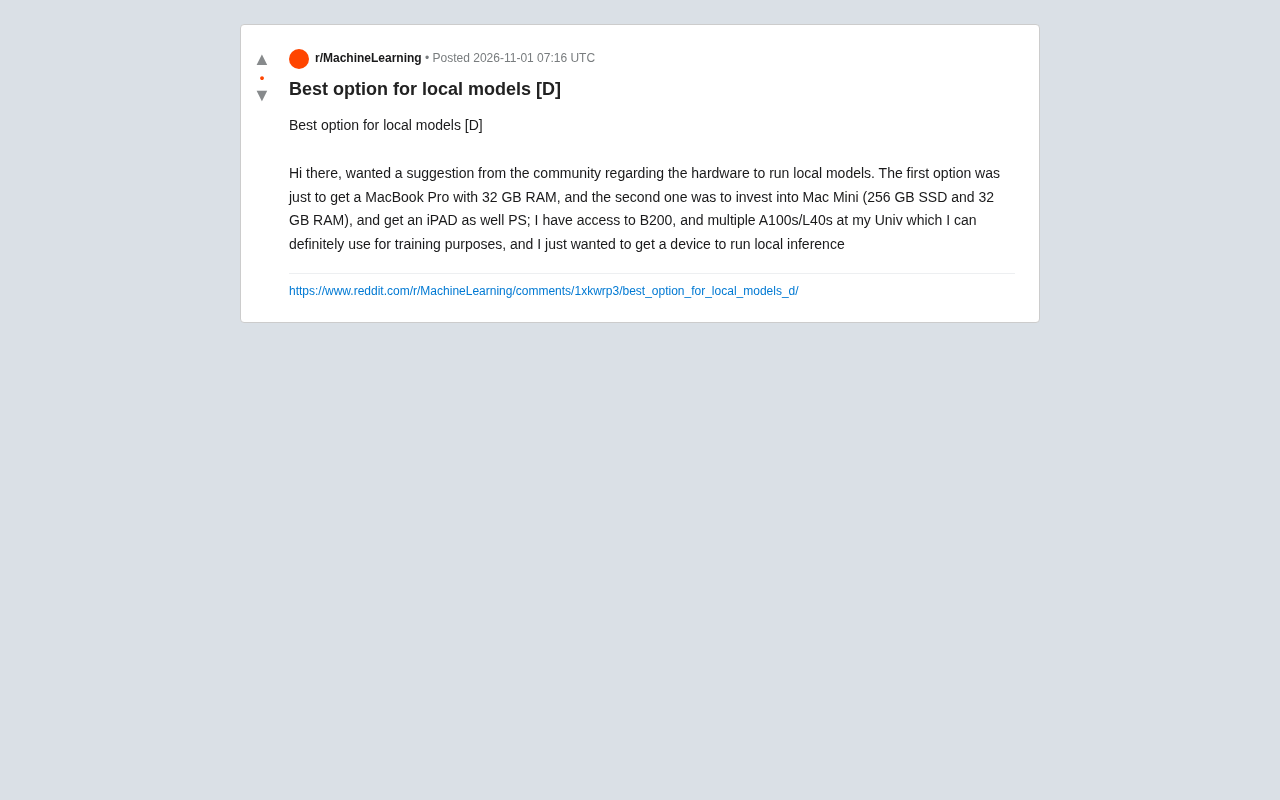
本地大模型硬件怎么选?MacBook Pro vs Mac Mini+iPad深度对比
Reddit社区热议本地大模型硬件选择:32GB MacBook Pro与Mac Mini+iPad组合如何取舍?本文从便携性、性价比、内存需求等角度深度分析,帮你找到最适合本地推理的设备方案。

AI Agent失败溯源:如何定位错误决策的根因?
Reddit讨论聚焦AI Agent失败溯源难题:如何定位导致Agent做出错误决策的根因?分析LangSmith、LangFuse等可观测性工具的局限,探讨手动分析与自建分析系统的实践组合,为Agent可靠性提升提供思路。