用量子玻恩规则替代Softmax注意力:一次大胆的架构实验

有开发者用量子玻恩规则替代Softmax生成注意力权重,实验证明可正常训练,但尚缺基准对比。
一位Reddit开发者提出将Transformer注意力机制中的Softmax替换为量子力学的玻恩规则——即对Query与Key内积取模平方后归一化——并声称模型可以正常训练。玻恩规则与Softmax在数学结构上都生成归一化非负权重,但二者对极端值和内积符号的处理方式存在本质差异:平方归一化更为温和,可能带来不同的训练动态;而正负内积在平方后产生对称贡献,与Softmax通过指数压缩负值的行为截然不同。文章指出,"能训练"本身已是值得关注的信号,因为大量替换方案都在优化稳定性上失败。然而,该实验目前仅属概念验证,缺乏与标准注意力的系统性基准对比,其真实价值有待严格消融实验验证。此类探索的意义更多在于促使研究者反思Transformer默认组件的可替换性。
一个来自Reddit的激进想法
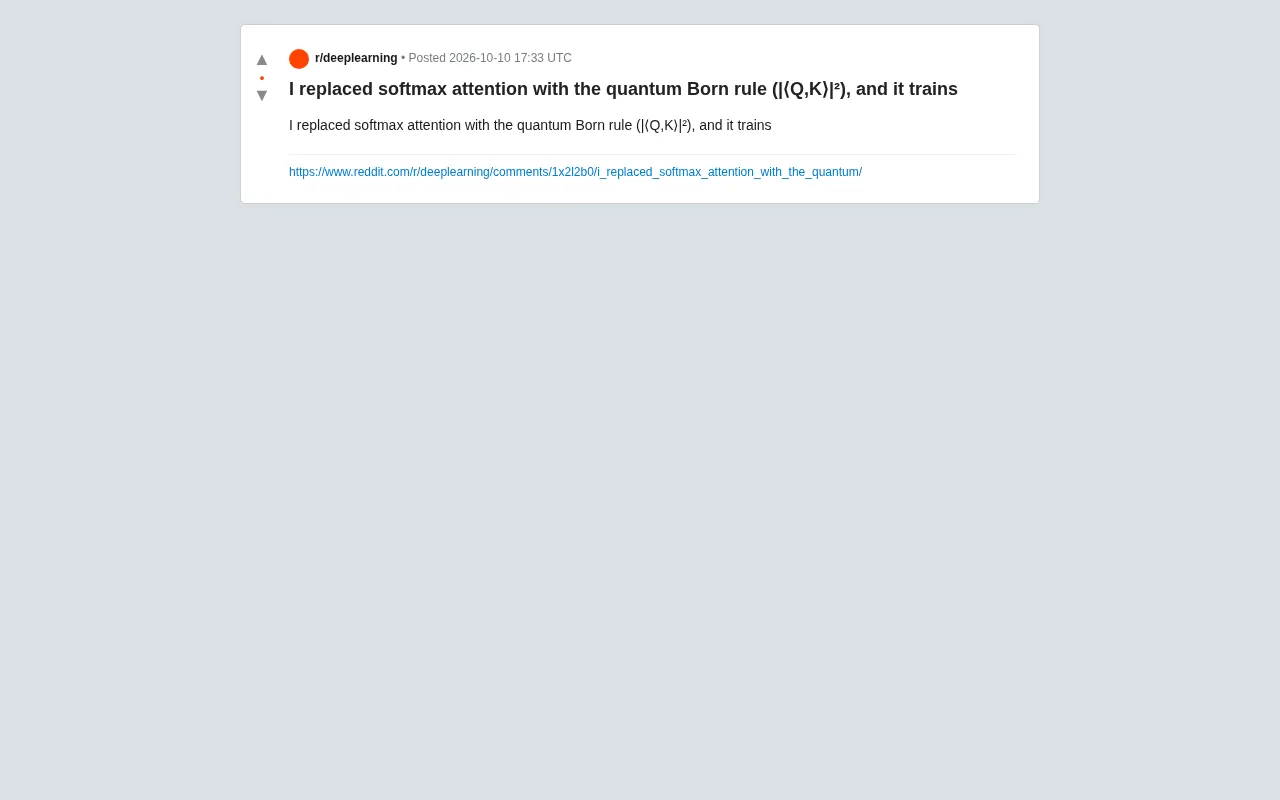
在Transformer架构中,注意力机制几乎是不可动摇的核心,而Softmax函数则是其中决定权重分配的关键环节。最近一位Reddit开发者抛出了一个颇具颠覆性的实验:用量子力学中的玻恩规则(Born rule),也就是 $|\langle Q,K\rangle|^2$,来替代传统的Softmax注意力——而且据作者所说,这个模型居然真的能训练起来。
这个想法乍听之下有些“玄学”,但背后其实蕴含着对注意力机制本质的重新思考。本文将拆解这一实验的技术逻辑,分析其潜在价值与局限。
需要说明的是:原始素材信息量较为有限,仅为一句话的实验结论,以下分析在原文基础上结合了相关技术背景进行合理延伸。
从Softmax到玻恩规则:注意力到底在算什么
标准的注意力机制通过计算 Query 和 Key 的点积得到相似度分数,再经过 Softmax 归一化,将这些分数转换为一组和为1的权重,最后对 Value 进行加权求和。Softmax 的作用是把任意实数分数映射到一个概率分布上。
而玻恩规则是量子力学中计算测量概率的方式:给定一个量子态的概率幅(amplitude),其模的平方 $|\langle Q,K\rangle|^2$ 就是对应的概率。两者在数学结构上有一个共同点——都在生成一组“权重”或“概率”。
作者的核心替换思路是:不再用指数函数(Softmax)来生成注意力权重,而是把 Query 与 Key 的内积视为一种“概率幅”,取其模平方后归一化,作为注意力分布。这种做法天然保证了权重非负,并且与量子测量的概率解释形成了优雅的类比。
为什么它“能训练”本身就值得关注
深度学习中,很多理论上看似合理的替换方案在实践中会遭遇梯度消失、数值不稳定或无法收敛的问题。作者强调“it trains”(它能训练),这其实是一个重要信号:说明 $|\langle Q,K\rangle|^2$ 这种形式在反向传播中能够产生有效的梯度流,不会立即崩溃。
平方操作在数值上相对平滑,相比指数函数的 Softmax,它对极端值的放大效应更温和,这可能带来不同的训练动态特性。
玻恩规则(Born rule)是量子力学的基本公设之一,由物理学家马克斯·玻恩于1926年提出。在量子力学中,一个量子系统的状态用波函数或态矢量描述,而测量某个可观测量时得到特定结果的概率,等于对应概率幅(probability amplitude)的模的平方。数学上,若系统处于态 $|\psi\rangle$,测量得到本征态 $|\phi\rangle$ 的概率为 $|\langle\phi|\psi\rangle|^2$。这与注意力机制中 Query 和 Key 的内积 $\langle Q, K\rangle$ 形成了直接的形式类比:Q 和 K 分别扮演两个量子态的角色,内积充当概率幅,平方后得到"测量概率"即注意力权重。这种类比的吸引力在于其数学上的自洽性——模平方天然非负,归一化后自动满足概率分布的约束,无需像 Softmax 那样依赖指数函数来强制保证非负性。
这种替换可能带来什么
从理论角度看,用玻恩规则替代 Softmax 可能带来几个有趣的影响:
- 不同的权重分布形态:Softmax 倾向于产生“赢家通吃”的尖锐分布,而平方归一化的分布形态可能更分散或更集中,取决于内积的符号与大小,这会改变模型关注信息的方式。
- 符号信息的处理:点积可以为负,Softmax 通过指数将其映射为小正数,而取模平方会让正负内积产生对称的权重贡献,这是两者行为差异最大的地方之一。
- 与量子计算的概念桥接:这类实验为未来可能的量子-经典混合架构提供了概念上的衔接点,尽管目前更多是数学形式上的借鉴而非真正运行在量子硬件上。
需要保持的审慎态度
一次“能训练”的实验,距离“比 Softmax 更好”还有相当长的距离。真正要验证这种架构的价值,至少需要回答以下问题:
- 在相同参数量和数据集下,收敛速度与最终精度相比标准注意力如何?
- 在长序列、大规模预训练场景下是否依然稳定?
- 平方归一化是否会在某些任务上引入新的偏差?
目前这些问题在原始分享中都没有给出答案。单一来源、缺乏基准对比的情况下,这更应被看作一次有启发性的概念验证(proof of concept),而非成熟的架构改进方案。
小结:好奇心驱动的架构探索
这类实验的价值,往往不在于立刻取代现有方案,而在于拓展人们对“注意力机制为什么用 Softmax”这一默认假设的反思。玻恩规则与注意力权重之间的数学类比确实优雅,也提醒我们:Transformer 中许多被视为理所当然的组件,其实都存在被重新审视和替换的空间。
对于想动手复现的开发者,建议在小规模模型和标准数据集上做严格的消融对比实验,用数据说话,才能判断这究竟是一次有趣的巧合,还是一个值得深挖的方向。
背景补充
理解这一点的背景在于:注意力机制的替代方案历史上屡屡折戟于优化难题。例如,线性注意力(Linear Attention)通过核函数近似将复杂度从 $O(n^2)$ 降至 $O(n)$,但在许多任务上表现明显劣于标准注意力,原因之一就是梯度信号的质量下降。类似地,用 ReLU 替换 Softmax 的尝试(即 ReLUformer)虽然能训练,但需要额外的归一化技巧才能稳定。平方操作 $|x|^2$ 的导数为 $2x$,是线性的,这意味着梯度不会像指数函数那样在极端值处急剧膨胀或消失,在数值稳定性上具有天然优势。这也是"能训练"这一表述在技术上并非理所当然的原因——它意味着该替换通过了深度学习实践中最基础也最关键的第一关。
相关推荐

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。

DukaanAI:用开源AI把商品照片变成库存清单
DukaanAI 是一款面向小零售商的 AI 库存工具,通过 Gemma 3 开源模型将商品照片转为库存条目,支持本地推理、字段编辑与 CSV 导出,探索 AI 辅助商品目录创建的可行路径。