用 n8n + AI 自动化内容校对测试:文件比对与HTML报告实战

用n8n+GPT-4.1自动比对客户原文与设计稿文本,将数天人工校对压缩至数小时并精确定位差异。
本文介绍了一套基于n8n低代码工作流和OpenAI GPT-4.1的文本内容自动校对方案,专门针对手工测试中耗时最长的"内容校对验证"场景。核心流程是:测试人员上传客户原文与设计稿两份文件,系统通过命名约定统一标识、将PDF/DOCX转为纯文本、把两列对比数据合并为单行结构后传给AI,再对AI输出做多层合法性校验,最终生成HTML差异报告,精确标注误改和漏复制两类错误的位置(精确到subject/bullet层级)。整套方案将原本耗费数天的人工逐行比对压缩至数小时,但当前仅覆盖文本维度,图像和排版校验需额外扩展。
从一个真实痛点说起
手工测试里有一类枯燥却极易出错的工作——内容校对验证(copy validation)。本文作者在 YouTube 频道 Trip Tech Solution 分享的这套自动化方案,源自一位做手工测试的朋友的真实困境:客户提供文案内容,设计师根据文案制作图像和排版,而测试人员需要逐行核对设计稿里的文字是否与客户原文 100% 一致。
问题在于量级。这类文件动辄成千上万份,逐行人工比对要花费数天时间,不仅拖慢交付节奏,还消耗大量人力成本,对公司而言是一笔持续的隐性支出。更棘手的是,人工阅读上千行文本本身也会出错,形成"用易错的方式去检查错误"的恶性循环。
作者把问题收敛成两个最典型的场景:一是文案是否被完整复制粘贴(有没有漏掉某行内容);二是复制过程中是否出现误改——比如多了一个点号、多敲了一个字母,或者某段文字被意外删除。这两类错误看似微小,却会让整段内容的含义发生偏差。
自动化的核心思路
整套方案的逻辑非常直接:测试人员只需上传两份文件——客户提供的原始文案文件(actual file)和设计师制作的设计文件(design file),系统自动完成比对,并输出一份可读的差异报告。
作者强调这里只演示了纯文本比对的场景。虽然设计师的产出通常是图像,但手工测试真正的瓶颈在文本核对环节,因此 demo 刻意剥离了图像,只用文本来展示问题。他也提醒观众,实际落地时可以按自己的业务添加更多 case scenario,这套流程只是一个可扩展的起点,而非只能处理这两种错误。
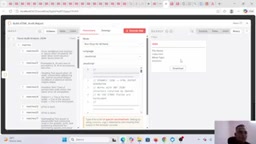
输出环节也考虑了灵活性:报告既可以直接下载到本地系统,也可以通过接口集成发布到网站上,具体取决于客户需求。作者把下载按钮也做进了流程里,方便不同场景调用。
n8n 工作流的搭建拆解
作者坦言这套工作流复用了他此前视频中大量的节点对象,真正改变的只是信息流转方式和各节点的配置。整个流程从表单提交(on-form submission)开始,接收两份上传文件。
文件标准化与命名约定
上传的文件支持 PDF、DOCX 等格式。作者在这里引入了一个关键设计——命名约定(naming convention)。无论用户上传的文件实际叫什么名字,流程内部都会统一映射成 file1、file2 这样的标准标识。这样做的好处是,后续所有代码节点的配置都能稳定引用固定变量,不会因为文件名变化而失效。
在代码节点中,作者处理了 binary data、file name 以及 MIME type 这几个关键字段,并加入校验:必须上传至少两份文件,否则流程中断。随后两份文件分别被转换、映射,连同类型标识一起向下传递。
命名约定(naming convention)是自动化流程稳健运行的基础工程实践。在 n8n 这类低代码工作流工具中,节点之间通过变量名引用数据,一旦上游数据的字段名随用户输入而变化,下游所有依赖该字段的节点都可能因为找不到对应键名而报错或静默失败。通过在流程入口处做一次统一的字段重映射——将任意文件名强制转换为 file1、file2 这样的内部标准标识——可以把"不确定性"限制在流程边界之外,让核心逻辑只处理已知结构的数据。这种做法在数据工程领域称为"模式规范化"(schema normalization),是 ETL 流程中的常见手段,在自动化测试框架中同样适用。MIME type 的校验则是另一层防护:不同格式的文件(PDF、DOCX、TXT)在后续解析时走不同的处理路径,提前识别类型可以避免把 PDF 的二进制流当纯文本处理而产生乱码或解析错误。
文件转文本是比对的前提
一个容易被忽略但至关重要的步骤:PDF/DOCX 是二进制格式,而质量检查需要纯文本字符串。作者使用 JSON.stringify(视频中口述为 dollar json)把文件内容转换成文本格式,存入变量。他特别点明——"在 file 上没法做 quality check,必须先有 data(文本)"。这一步是整个 AI 比对能跑通的基础。
合并数据并喂给 OpenAI
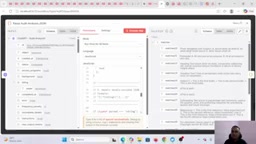
转文本后,两份文档的内容被合并进一个数据结构里。作者在这里做了一个巧妙处理:他没有把两列数据分别传给 AI,而是把两列的值塞进同一列的一行中。原因是直接给两列容易让模型"理解不到位、需要大量 prompt 去解释哪列是哪列",而合成一行后映射更清晰、模型更容易对齐。
模型选择上,作者使用 GPT-4.1(提到也可用 4.1 mini),通过 HTTP 请求节点调用,配置了 authorization、content-type 等标准 header,并在 JSON body 中写入比对规则。
将两列数据合并为单行再传给模型,这一设计背后是对大语言模型处理结构化数据时"注意力分配"特点的经验性应对。GPT 系列模型本质上是基于 Transformer 架构的序列处理系统,在处理多列表格数据时,模型需要在 prompt 中理解列与列之间的对应关系,这要求更精确的 prompt 工程,否则模型容易"跨行配对"或忽略列头定义。而将同一行的两列值拼接成一个字符串(例如 "原文: AAA | 设计稿: BBB"),则把"哪两个值需要对比"这一关系直接编码进了数据本身,大幅降低了模型理解的歧义空间。GPT-4.1 是 OpenAI 于 2025 年发布的模型,相较于 GPT-4o 在长上下文处理和指令遵循方面有所优化,其 mini 版本在保持较高准确率的同时显著降低了调用成本,适合批量文本比对这类对延迟不敏感但调用频次较高的场景。
从校验到可读报告
AI 返回结果后,作者没有直接采信,而是加了多层校验:检查 API 是否真的返回了 output text、返回的 JSON 是否合法、是否触发了异常。他给出的理由很实在——"我的输出检查非常重要,就算 OpenAI 100% 工作正常,我也要确认它确实输出了。"异常处理(exception handling)在这里被明确强调。
校验通过后,结果被整理成标准化、可读的结构(如 matches 0 / matches 1 / matches 2 这类标记),再通过一段不长的代码转成 HTML 表格形式,最终生成一份可下载的报告。
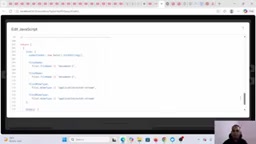
对 AI 输出做强制校验而非直接信任,体现了生产级自动化流程与 demo 脚本之间的关键差异。大语言模型的输出在边缘情况下可能出现 JSON 格式不完整、字段缺失、或因上下文长度超限而截断等问题,即便模型本身运行正常,网络超时或 API 限流也可能导致返回值为空。在 n8n 中,这类异常如果没有被显式捕获,会让后续节点拿到 null 或 undefined 数据,进而产生难以追踪的静默错误。作者在此处加入的多层校验——依次检查 HTTP 响应状态、返回体是否含 output text、JSON 是否可合法解析——构成了一个简单的"防御性编程"链路。这种模式在企业级 RPA(机器人流程自动化)和 API 集成中是标准做法,能显著提升流程的可观测性和故障定位效率。
实测两种错误场景
作者用两个真实场景验证了方案能力。
场景一(误改):原文某处是正常文本,设计师复制时误加了内容或改了字符(比如把一处文字改成 "not")。报告准确标出了这个差异点,指明 actual 值是什么、designer 文档里变成了什么。
场景二(漏复制 / 删除):原文中有 "BC" 这一内容,设计师直接漏掉没放进文档。报告识别出这是一个 delete 类型的缺失,并指出它应出现在哪个 subject、哪个 bullet 位置。
这个"定位能力"是作者反复强调的价值所在:面对上千行文本,报告会直接告诉测试人员"去 subject 的 after position one bullet 看",而不是让人再从头读一遍。更重要的是,系统能一次返回多个差异点——有几处问题就列几条(rule 1、rule 2、rule 3……),而非只报一个。
价值与适用边界
整套方案的收益很清晰:原本需要数天的手工逐行校对,被压缩到几小时甚至更短,测试人员拿到差异报告后可直接把问题邮件转给设计师,设计师据此定位、修复、更新,再回到测试环节,形成高效闭环。
不过也要客观看待其边界。这只是一个 demo 级别的教程,演示的是文本比对;真实业务中图像、排版、格式等维度的校验还需要额外设计。此外,方案高度依赖 OpenAI 的输出质量,作者虽然加了多层校验,但 AI 比对本身的准确率在大规模场景下仍需进一步验证。对于想在 n8n 中搭建类似自动化测试流程的团队来说,这套思路——标准化命名、文件转文本、单列映射喂 AI、强制输出校验、生成可读报告——提供了一个可复用的参考框架。
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。