用 NVIDIA NeMo 将 Agent 失败转化为测试与 Harness 修复

NVIDIA 提出把 Agent 生产失败沉淀为问题清单与定制评估集,反向驱动工程改进。
文章介绍 NVIDIA 开发者博客提出的 Agent 可靠性工程化思路:生产环境中的失败不应被当作一次性 bug 手动修复,而应系统化收集失败上下文、输入、工具调用记录与输出偏差,转化为优先级明确的问题清单。在此基础上构建定制评估集,使 prompt、工具、模型、记忆、技能与 harness 代码的每一处改动都能被可重复验证,并防止回归。文章特别强调 harness 层工程质量对 Agent 可靠性的影响,认为精确归因问题出在模型还是框架,往往比单纯更换更强模型更有价值。落地路径为:先建立失败证据采集机制,再将高优先级失败转为评估用例,最后接入迭代流程,NVIDIA NeMo 在其中承担枢纽角色。
当 AI Agent 从演示Demo走向生产环境,失败案例的处理方式直接决定团队的迭代效率。NVIDIA 官方开发者博客提出的思路是:把生产环境中的失败证据系统化地沉淀为优先级明确的问题清单和定制评估集,再反向推动 prompt、工具、模型、记忆、技能以及 harness 代码的改进。
为什么 Agent 的失败需要被「工程化」
传统软件测试的输入输出是确定的,而 Agent 的行为由模型推理、工具调用、上下文记忆共同决定,失败往往带有偶发性。如果只把失败当作一次性 bug 手动修掉,同一个问题会在生产环境中反复出现。NVIDIA 博客的核心主张是:失败不是终点,而是测试资产的原材料。
把生产环境中的失败证据收集起来,转成可复现的测试用例和评估标准,团队才能建立可持续的质量闭环,而不是每次都在救火。
Agent 失败为何具有偶发性
与传统软件不同,Agent 的输出并非由确定性的代码路径产生,而是由模型在给定上下文下采样生成。温度参数、上下文长度、工具返回内容的细微差异,甚至同一输入的不同排列顺序,都可能导致推理走向不同分支。这使得同一个 Agent 在面对相似任务时,可能一次成功、一次失败,失败呈现出概率性而非确定性。
这种特性带来两个后果:其一,单次复现困难,工程师难以像调试普通 bug 那样通过断点定位根因;其二,偶发失败容易被误判为「运气不好」而被忽略,直到在生产环境中累积成系统性风险。正因如此,才需要把失败当作统计样本而非孤立事件来对待——收集足够多的失败证据、记录完整上下文,才能让偶发问题转化为可分析、可复现的测试资产。
从失败证据到优先级问题清单
博客给出的第一步是把失败从「口头描述」变成「结构化问题」。所谓生产证据,包括失败发生的上下文、当时的输入、工具调用记录、最终输出与预期之间的偏差。这些材料汇总后,团队可以按影响范围和复现频率排出优先级,区分哪些是高频致命问题、哪些是长尾边缘案例。
这一层的价值在于让讨论有据可依。工程师不再需要凭感觉判断「这个 bug 严不严重」,而是可以直接对照真实生产数据做取舍。
定制评估集:让修复可以被验证
NVIDIA 方案中更关键的一环是构建定制评估(custom evaluations)。把每一类失败样本转成评估项后,团队就有了可重复运行的检查手段:修改 prompt、更换工具调用策略、调整模型或记忆机制之后,跑一遍评估集就能判断修复是否有效、是否引入回归。
这些评估集覆盖的改进维度在博客中被明确列出,包括 prompts、tools、models、memory、skills 以及 harness 代码。也就是说,失败驱动的测试不只针对模型本身,还覆盖整个 Agent 运行时框架。
定制评估与通用基准的区别
通用基准(如各类 Agent 排行榜所用的任务集)衡量的是模型在标准化场景下的平均能力,其题目公开、分布固定,很难反映某个团队自身业务中的具体失败模式。定制评估则是从自己的生产失败样本中反向构造出来的检查项:每一条都对应一个真实发生过的错误,并带有明确的输入、期望行为与判定标准。
它的价值在于两点:一是针对性,能直接检验那些曾经出问题的边缘场景是否被修复;二是可回归,评估集可反复运行,任何 prompt、工具或模型改动后都能快速发现是否引入倒退。实践中定制评估的判定方式可以是精确匹配、规则校验,也可以借助模型作为评判者(LLM-as-judge),但无论哪种方式,都需要把失败样本中的关键上下文完整保留,否则评估项会失去复现能力。
Harness 修复:被低估的可靠性来源
很多 Agent 的失败并非模型能力不足,而是 harness 层的工程问题——工具描述含糊、错误处理缺失、上下文拼接不当、重试逻辑不健全。NVIDIA 博客把 harness 代码修复与模型调整并列,说明在真实生产场景里,工程脚手架的质量对 Agent 可靠性影响显著。
把失败样本挂到 harness 的对应模块上,团队可以更精确地定位问题出在「模型不会」还是「框架没接住」。这种归因能力往往比单纯换一个更强的模型更有价值。
Harness 在 Agent 语境中的含义
Harness 一词在软件工程中原指测试脚手架或测试运行框架,在 Agent 语境下,它指的是包裹在模型之外的整套运行时工程代码:包括工具定义与调用协议、上下文与历史的拼接策略、错误捕获与重试机制、输出解析与格式校验、循环终止条件等。模型本身只负责推理与生成,真正把推理变成可执行动作、把工具返回重新组织进上下文的,正是 harness。
因此同一模型在不同 harness 下表现可能差异显著——工具描述写得含糊,模型就容易选错工具;缺少错误处理,一次工具超时就会让整个任务崩溃;上下文拼接不当,则会让关键信息在长对话中被稀释。将 harness 与 prompt、模型并列作为修复维度,意味着可靠性优化的重心从「换模型」转向「改工程」,这也是该方案区别于纯模型评测的关键之处。
落地建议
对准备把 Agent 投入生产的团队,可以按这个顺序推进:先建立失败证据的采集机制,确保每次异常都有上下文可查;再把高优先级失败转成评估用例,形成可持续运行的回归集;最后把评估结果接入 prompt、工具、模型、记忆与 harness 的迭代流程。NVIDIA NeMo 在其中承担的是连接「生产失败」与「工程改进」的枢纽角色。
Agent 的可靠性不是一次调优的结果,而是持续把失败转化为测试资产的过程。
相关推荐
微软WebIQ:为AI Agent提供可验证的实时网页接地
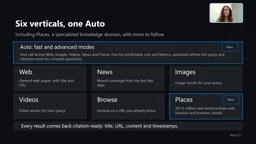
微软WebIQ为AI Agent提供实时、可引用的网页接地能力,覆盖网页、新闻、图片、视频、Places等来源,P95延迟164毫秒,同等质量下token用量减少50%,支持Scopes来源控制与MCP接入。
可增强高斯泼溅:打造机器人训练的照片级仿真环境
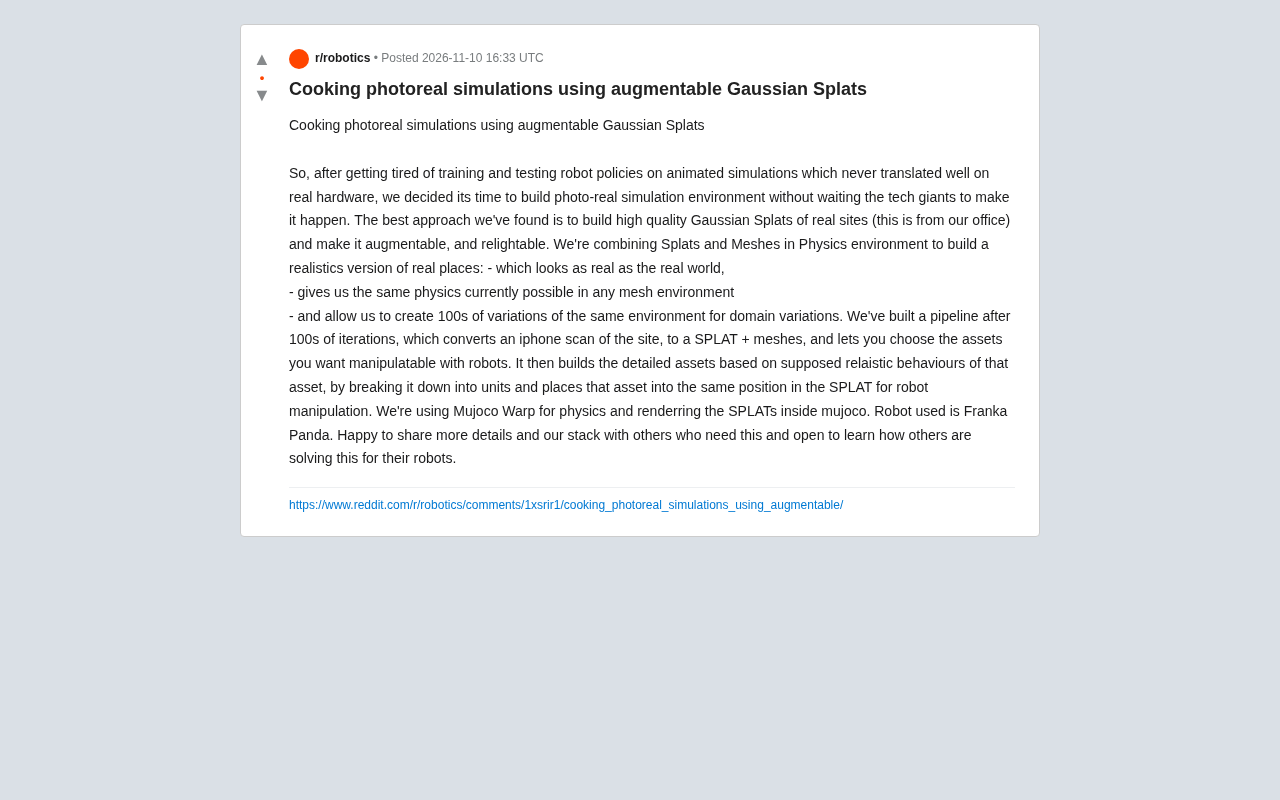
团队用高斯泼溅与网格混合构建照片级真实感机器人仿真环境,结合 MuJoCo Warp 物理引擎与 Franka Panda 机器人,实现可增强、可重打光的真实场地仿真,缩小仿真到现实的视觉差距。

Gemini 4 Carbon发布:一年内从Gemini 3到Gemini 4的飞跃
Google发布最新前沿模型Gemini 4 Carbon,距离Gemini 3不到一年。官方演示中Carbon一次性完成Theme Park二进制逆向工程、添加DeepMind主题新设施并移植到Web,展示了模型在长链路工程任务上的能力进展。