用 Opus 5.5 打造可玩宝可梦对战 Demo:AI 编程实测
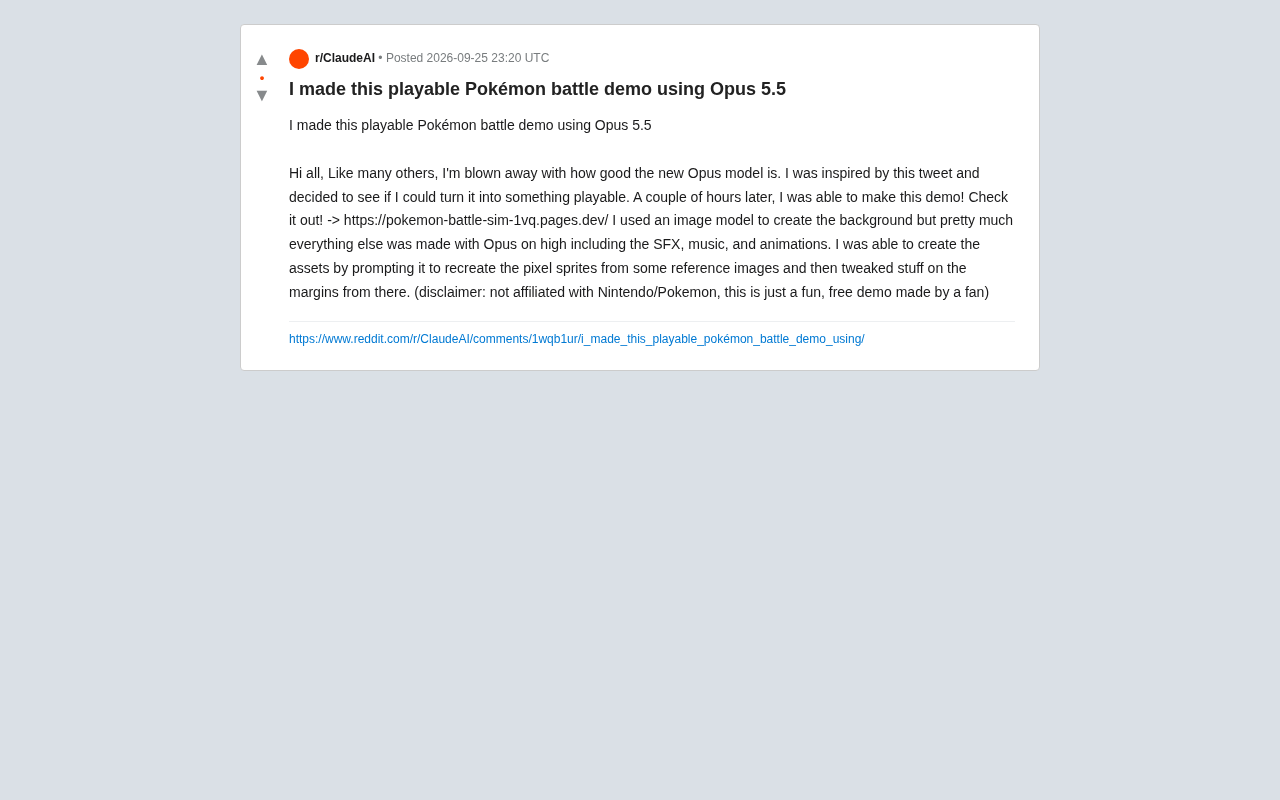
开发者借助 Claude Opus 5.5 在数小时内完成了一个几乎全由 AI 生成的宝可梦对战网页 Demo。
一位开发者受推文灵感启发,使用 Anthropic 的 Claude Opus 5.5 高性能模式,在几小时内做出了一个可在浏览器中游玩的宝可梦对战 Demo。项目中除背景图使用图像生成模型外,代码、音效、背景音乐和动画逻辑几乎全部由 Opus 生成;像素精灵图则采用「AI 按参考图重建初稿 + 人工微调细节」的协作工作流完成。这个案例的意义不在于游戏本身的复杂度,而在于它展示了 AI 辅助创作正从「生成代码片段」进化到「产出完整可交互作品」,并将传统上需要数天的小游戏开发周期压缩至一个下午。文章同时指出,此类社区自发的能力实测往往比标准 Benchmark 更能反映模型的真实可用性,但也强调该项目仍属快速原型范畴,与工程化产品存在差距。
一个宝可梦对战 Demo 背后的 AI 编程实验
最近 Reddit 上一位开发者分享了自己用 Anthropic 新发布的 Opus 5.5 模型做出的一个可玩宝可梦对战 Demo,迅速引发讨论。作者坦言,和很多人一样,他被这个新模型的能力「震撼到了」,于是花了几个小时把一条推文里的灵感变成了一个真正能玩的网页游戏。
这个 Demo 目前已经上线,任何人都可以直接在浏览器里体验对战流程。作者特别声明,项目与任天堂或宝可梦官方没有任何关联,纯粹是粉丝自制的免费玩票之作。
除了背景图,几乎全部由 Opus 生成
从技术实现角度看,这个案例最值得关注的地方在于 AI 承担了绝大部分工作量。据作者描述,除了游戏背景使用了图像生成模型来制作外,其余几乎所有内容——包括音效(SFX)、背景音乐、动画逻辑——都是用 Opus(高性能模式)完成的。
这意味着模型不仅要写游戏逻辑代码,还要处理战斗动画的时序控制、音频触发等偏交互与多媒体的部分。对于一个「几小时」量级的个人项目来说,这样的完成度确实体现了当前大模型在端到端产品原型开发上的进步。
像素素材是怎么来的
在游戏资源方面,作者采用了一个巧妙的思路:先给模型提供一些参考图,让它按照参考图去「重建」像素精灵图(sprites),然后再在细节边缘手动微调。
这种「AI 生成初稿 + 人工精修」的工作流,正在成为独立开发者和创作者的主流模式。它并不要求模型一次性做到完美,而是把 AI 当作一个能快速产出可用初稿的协作者,人类负责把控最终质量和风格一致性。
Anthropic 的 Claude Opus 系列是该公司旗下能力最强的模型系列,定位于需要深度推理和复杂任务的场景。「高性能模式」(Extended Thinking 或类似的高算力配置)通常意味着模型会花更多计算资源进行内部推理,在代码生成、逻辑规划等任务上表现更稳定,但相应的响应延迟和调用成本也会更高。在游戏开发这类需要跨领域协调(逻辑、音频、动画时序)的任务中,模型的上下文窗口大小和指令遵循能力同样关键——它需要在一段连续对话中始终保持对整体架构的「记忆」,才能生成前后一致的代码和资源调用逻辑。
像素精灵图(Pixel Sprite)是2D游戏中角色与道具的基本视觉单元,通常分辨率极低(如16×16或32×32像素),每一个像素的颜色都需要精心设计。传统制作依赖专业像素画师手工逐像素绘制,耗时且风格统一性要求高。让大语言模型「重建」像素图的做法,本质上是利用模型的多模态理解能力,将参考图的视觉特征转化为 SVG 矢量描述、HTML Canvas 绘图指令或直接生成色值数组,再渲染为像素风格图像。这种方式生成的初稿往往在轮廓和配色上与参考图接近,但细节处理(如抗锯齿边缘、阴影层次)仍需人工干预,这正是「AI 初稿 + 人工精修」工作流发挥价值的环节。
从一条推文到可玩产品:工作流的启示
这个项目的价值不在于游戏本身多复杂,而在于它展示了一条越来越短的创作路径:看到灵感 → 用 AI 拆解实现 → 生成代码与素材 → 部署上线,整个过程被压缩到几个小时。
对比过去,一个包含美术、音效、动画和对战逻辑的小游戏 Demo,即便对熟练开发者也需要数天甚至数周。而现在,单个开发者借助 Opus 这类模型,可以在一个下午完成从想法到可分享链接的全流程。
这类案例反映了什么趋势
值得思考的是,这类由社区自发产出的「模型能力实测」,往往比官方 Benchmark 更能反映模型的真实可用性。当越来越多用户能在短时间内做出完整、可玩、可分享的作品时,说明模型在综合任务上的连贯性和可靠性已经跨过了某个实用门槛。
当然,也需要保持理性:这仍是一个规模较小的粉丝 Demo,作者也对代码质量、可维护性等未做深入说明。它更多是「快速原型」意义上的成功,而非工程化产品的验证。
Benchmark(基准测试)是评估 AI 模型能力的标准化测试集,如 HumanEval(代码生成)、MMLU(知识问答)等。这类测试虽然便于横向比较不同模型,但往往是孤立的单一任务,无法反映模型在真实开发场景中处理模糊需求、跨步骤协调和长上下文一致性的能力。相比之下,「能在几小时内做出可玩 Demo」这类社区实测,考察的是模型在真实工作流中的综合表现——包括理解不精确的自然语言需求、主动补全细节、以及在多轮迭代中保持方向一致。这种「可用性门槛」的跨越,往往比 Benchmark 分数提升几个百分点对实际开发者更有参考意义。
小结
一个用 Opus 5.5 做出的宝可梦对战 Demo,看似只是社区里的一次玩票,实际上折射出 AI 辅助创作正在从「写代码片段」走向「产出完整交互作品」。对独立开发者和创作者而言,掌握「AI 生成 + 人工精修」的协作流程,可能比纠结于哪个模型跑分更高更有实际意义。感兴趣的读者可以直接访问作者分享的链接亲自体验。
相关推荐
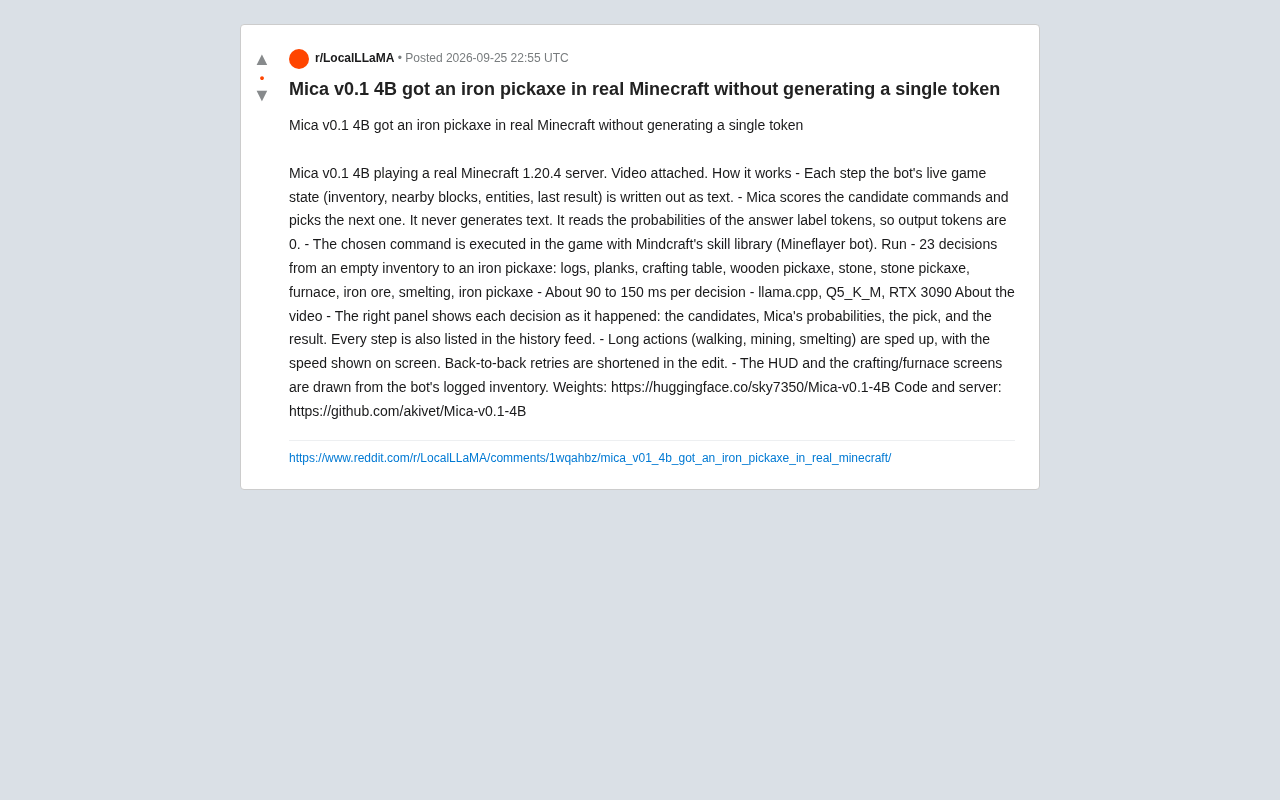
Mica v0.1 4B:不生成一个token,如何在真实Minecraft中造出铁镐
Mica v0.1 4B在真实Minecraft服务器中用23步造出铁镐,全程不生成任何文本token,而是通过读取答案标签概率进行决策。基于RTX 3090单卡实现90-150ms实时响应,模型与代码已开源。
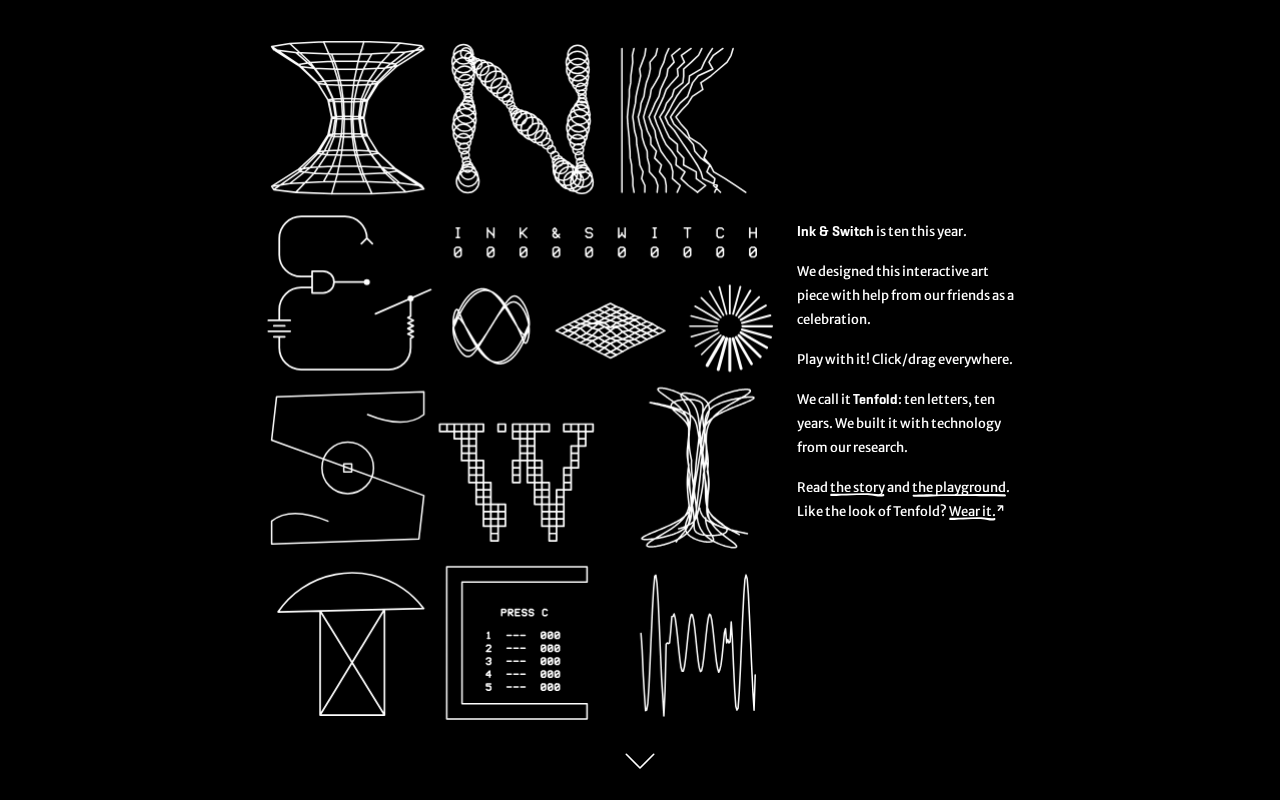
Ink & Switch 交互式主页:研究实验室的另类表达
Ink & Switch 交互式主页登上 Hacker News 热榜,本文解析这家专注本地优先软件与人机交互研究的独立实验室,如何用交互式设计传达其软件理念。
医学生问没有A*一作能否进神经外科:内卷已到荒诞地步
一名医学生询问没有A*顶刊一作论文能否匹配神经外科,引发对学术内卷外溢现象的讨论。本文分析顶刊发表为何成为跨领域硬门槛,以及量化评价体系的错配隐忧。