用Slack+BigQuery+Langfuse搭建可监控的AI数据助手
用Slack+Gemini+MCP+Langfuse构建生产级数据查询助手,兼顾安全、成本控制与全链路可观测性。
本文介绍了一套在Slack内构建企业数据查询助手的完整工程方案:核心是单个Cloud Run服务同时运行Slack机器人与MCP服务器,前者通过Socket Mode避免暴露公网Webhook,后者为Gemini提供只读BigQuery查询能力,并以白名单表、SQL语法校验、100MB计费上限和200行返回上限层层设防。Langfuse负责全链路可观测性,将每次提问转化为包含用户身份、token消耗、工具调用记录的可追溯Trace。Slack线程天然承担对话记忆功能,每个线程即一段独立对话。整套方案将权限控制、成本监控与合规审计工程化,为希望将LLM接入内部数据系统的团队提供了一个可落地的生产级参考架构。
为什么要在Slack里建一个数据助手
营销和销售团队做竞价决策时,常常需要快速、可靠的数字支撑:给某个客户出多少价、以什么价格成交。传统流程是提需求给分析师,然后等待排期。这种延迟在实时竞价场景里几乎是致命的。
这篇教程给出的方案是:直接在Slack里用自然语言向「Data Assistant」提问,助手自动查询BigQuery并返回真实数据,让每一次出价都有数据背书。更重要的是,整套系统接入了Langfuse做可观测性监控——谁在问、问了什么、每个问题消耗多少token、运行了多久、助手执行了哪些查询,全部可追溯。
这套架构的价值不只在于「能用AI查数据」,而在于它把权限控制、成本监控、对话记忆三件事做成了可落地的工程化方案。
整体架构:一个Cloud Run服务跑两样东西
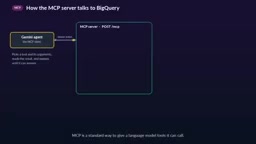
整个系统的核心是一个Cloud Run服务,里面同时运行着两个组件:一个Slack机器人和一个MCP服务器。
Slack机器人通过Socket Mode以出站WebSocket连接Slack,这意味着不需要暴露任何公网webhook,安全性大幅提升。机器人的各类token从Secret Manager加载,而非硬编码。
当一个问题到达时,Gemini的agent循环会决定调用哪些工具。这些工具都托管在MCP服务器上,MCP服务器只对一组白名单内的BigQuery表执行只读SQL,除此之外什么都不做。这种「最小权限」设计是整套方案的安全基石。
Socket Mode是Slack提供的一种替代公网Webhook的事件接收方式:应用主动向Slack建立一条出站的WebSocket长连接,Slack通过这条连接将事件推送过来,而不是向应用的HTTP端点发送POST请求。这对部署在防火墙后或私有网络中的服务非常友好——服务不需要拥有公网IP或域名,也不需要配置TLS证书和入站防火墙规则。代价是连接状态必须由应用自行维护,且Slack要求使用带connections:write权限的App-Level Token来建立这条连接。正因为Socket Mode依赖单条常驻WebSocket连接来接收和确认事件,多实例部署会导致每个实例都收到同一条事件并各自回复,进而产生重复回答——这也是文章中强调「必须将Cloud Run实例固定为1」的根本原因,而非Cloud Run平台本身的限制。
MCP服务器:给大模型安全的工具接口
MCP(Model Context Protocol)是一种标准化方式,用来给语言模型提供它可以调用的工具。在这套系统里,Gemini是客户端,它通过HTTP加bearer token调用MCP服务器。
服务器对外提供三个工具:
- ListTables:返回Gemini可以使用的表
- GetTableSchema:返回表的列和字段描述
- RunQuery:执行SQL查询
每个工具都用Google客户端库以Cloud Run服务账号的身份调用BigQuery,且只针对固定的允许表集合操作。
关键在于每条查询都会先经过校验:只允许SELECT或WITH语句、只允许白名单内的表、最多计费100MB、最多返回200行。查询结果以JSON返回,Gemini再把它转化为发到Slack线程里的答案。这几道防线有效避免了误操作、天价账单和数据泄露。
MCP(Model Context Protocol)由Anthropic于2024年底提出并开源,目标是解决「每个AI应用都要单独集成每个工具」的碎片化问题。它借鉴了LSP(Language Server Protocol)的设计思路:定义一套标准的客户端-服务器协议,让任何兼容MCP的模型都能调用任何兼容MCP的工具服务器,而无需为每种组合单独开发适配层。在此之前,给LLM接入外部工具通常依赖各家平台自定义的Function Calling格式,工具描述、参数Schema和调用方式各不相同,迁移成本很高。MCP统一了工具的声明方式(tools/list)、调用方式(tools/call)和资源访问方式,使得同一个MCP服务器可以被Gemini、Claude、GPT等不同模型复用。在本文的架构中,MCP服务器扮演的是「受控的数据库代理」角色——它不只是技术规范的体现,更是将权限边界从模型层下沉到工具层的关键设计:即便模型被诱导生成恶意查询,服务器层的白名单和SQL校验仍然是最后一道防线。
用Langfuse把每次提问变成可追溯的trace
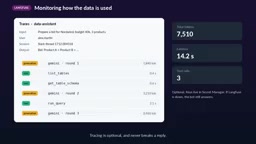
可观测性是这套系统的另一半价值。每个Slack问题都会变成一条trace。
这条trace存储了问题和最终答案、提问的Slack用户、以及所在线程——这样一整段对话就被归组为一个session。在session内部,Gemini的每一轮推理会作为一个generation记录下来,包含它的prompt、回答和token计数;每个MCP工具调用也会连同参数和返回结果一起被记录。
这意味着团队可以清楚看到:谁在用数据、他们问了什么、每个答案在token和时间上花了多少成本。对于需要控制AI使用成本和做合规审计的团队来说,这种粒度的监控非常实用。
值得一提的是,追踪是可选的。Langfuse的密钥同样存在Secret Manager里,如果Langfuse不可用,机器人依然能正常回答——监控层的故障不会拖垮主流程。
Langfuse是一个专为LLM应用设计的开源可观测性平台,其核心数据模型围绕Trace、Span、Generation三个层级展开。Trace对应一次完整的用户交互(本文中即一个Slack问题),Generation专门记录模型推理步骤,包含输入prompt、输出内容和token用量,Span则用于标记任意中间步骤(如工具调用)。这套层级结构使得「一次用户提问触发了几轮模型推理、每轮推理调用了哪些工具、整体耗时多少、成本多少」这类问题都能通过Langfuse的UI或API直接回答。Session概念则用于将同一对话线程的多条Trace归组,便于分析多轮对话的完整上下文。相较于通用APM工具(如Datadog、Jaeger),Langfuse针对LLM场景做了专项优化:原生理解token计费单位、支持prompt版本管理、可对模型输出做人工评分标注。对于需要向管理层汇报AI使用成本或向合规团队证明数据访问合规性的企业团队,这种细粒度的记录能力往往是将AI工具从「试验品」推向「生产系统」的必要条件。
搭建流程:从创建Slack应用到部署Cloud Run
整个搭建过程可以拆成几个关键阶段。
配置Slack应用
前往 api.slack.com/apps 点击「Create New App」,选择从零开始,命名并选定workspace。建议开发和生产使用两个独立应用。
在OAuth & Permissions里,给Bot Token Scopes添加:app_mentions:read、channels:history、chat:write、commands。
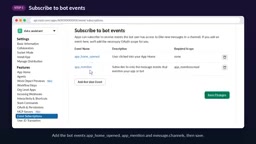
随后开启Socket Mode——这样payload会通过WebSocket到达,而不是公网请求URL。Slack会要求你生成一个带connections:write权限的App-Level Token,它以 xapp 开头。在Event Subscriptions里订阅 app_home_opened、app_mention、message.channels 等事件。最后安装到workspace,拿到以 xoxb 开头的Bot User OAuth Token。
管理密钥与权限
把两个token作为一个JSON secret一起存入Secret Manager,让Cloud Run服务账号能读取它。该账号还需要BigQuery的 Data Viewer 和 Job User 两个角色。
此外还要生成一个随机的MCP OAuth Token(用openssl生成)来保护MCP端点。所有真实token都不应提交到Git,也不要粘贴到代码、聊天或截图里。
本地验证与部署
安装依赖后,用Application Default Credentials登录并运行 main.py,检查启动日志里显示的机器人是否符合预期。
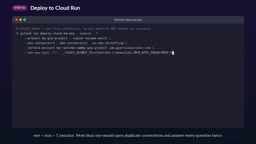
部署到Cloud Run时有一个关键细节:Socket Mode会保持一条常驻连接,因此必须把最小和最大实例数都固定为1。如果开多个实例,每个问题会被回答两遍。
实际使用体验
在频道里输入 /invite @data assistant 把机器人拉进来后,就可以 @ 它提问了,比如「为某个预算下有几款产品的客户准备一份竞价方案」。
机器人会在线程里立即回复「thinking」,并每5秒更新一次已用时间;另一边Gemini会检查表结构、通过MCP工具运行只读查询。完成后,这条消息会被替换成最终答案——每个数字都来自BigQuery,而非凭空猜测。
要调整报价,直接在同一线程里回复即可,无需重复@机器人或再次说明客户和预算。每个线程就是一段对话,机器人会记住线程里之前说过的一切。
几点需要注意:
- 只能在机器人已加入的频道里@它
- 回答总是出现在线程里
- 每个新客户或新竞价应另起一个线程
- 记忆会在重启或重新部署时清空,且永远不会跨线程
- 查询始终是只读的,且仅限于允许的表
这套方案的工程启示
抛开具体技术栈,这个案例展示了一个相对成熟的「生产级AI Agent」范式:用MCP标准化工具调用、用白名单和SQL校验层层设防、用Socket Mode规避公网暴露、用Secret Manager统一管理凭证、用Langfuse做全链路可观测性,最后用Slack线程天然实现对话记忆。
对于想把LLM真正接入内部数据系统的团队,这套组合提供了一个兼顾易用性、安全性与可监控性的参考模板。
相关推荐
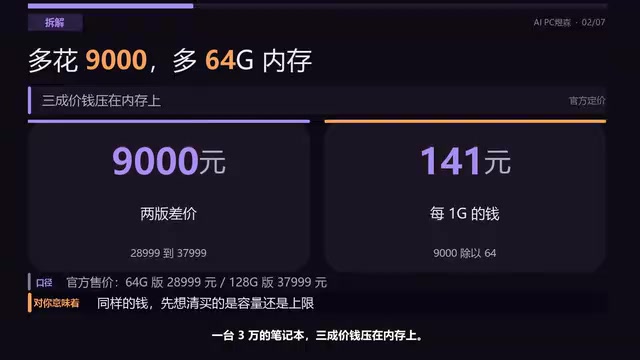
64G内存笔记本跑大模型,实际可用仅46.7G
华硕ProArt创16实测:64G内存标称值下模型可用仅46.7G,128G版官方上限1200亿参数。本文拆解9000元内存差价、统一内存占用真相、续航表现,并给出三步自查方法,帮你判断本地跑大模型该买多大内存。
Ollama零基础教程:本地部署大模型入门指南
Ollama零基础入门教程:了解Ollama是什么、核心特点与本地部署大模型的价值。涵盖开源免费、跨平台、CPU/GPU调度、API集成等关键信息,助你快速上手本地大模型管理工具。

LangGraph 实战:开发者真实工作流与技术栈剖析
从 Reddit 开发者提问切入,剖析 LangGraph 在实际生产中的工作流设计、技术栈组合、图结构模式与调试痛点,总结从教程走向落地的关键实践与可观测性需求。