有界自主与可验证安全:Agentic AI在高风险场景的治理框架BRaVeS

BRaVeS框架通过不变锚点与李雅普诺夫有界证明,为高风险场景下的智能体AI划定可验证安全边界。
本文介绍了一篇arXiv论文提出的BRaVeS框架,针对智能体AI在高风险场景中"越深度推理越偏离安全约束"的认知漂移问题给出系统性回应。框架由三层构成:将领域专家约束编码为贯穿推理全程的不变锚点、借鉴MoDA深度感知注意力机制保持锚点持续可见、以及通过SMARtAutonomy机制在风险上升时动态压缩系统自主权。理论层面,论文引入李雅普诺夫有界共识框架(LBCF)为有界恢复提供形式化收敛证明,但作者明确承认该证明仅适用于有限离散抽象而非完整神经激活空间。基于HAI 22.04工业控制数据的蒙特卡洛仿真验证了在既定抽象下的有限步收敛与零安全违规,但从仿真到真实Transformer部署仍有较大距离。
当深度推理成为安全隐患
随着智能体AI(Agentic AI)被寄予实现自动化的厚望,一个尖锐的问题浮出水面:在高风险环境中,仅凭概率推理的系统能否被安全部署?这篇来自arXiv的论文给出了明确的否定答案,并提出了一个值得关注的技术隐患——认知漂移(epistemic drift)。
所谓认知漂移,指的是当AI系统的推理链条不断加深时,其行为可能逐渐偏离领域专家(Subject-Matter-Expert, SME)为安全运行所设定的约束边界。换句话说,模型越是"深度思考",反而越可能走向危险。这与我们直觉中"推理越充分越可靠"的预期背道而驰,也正是工业控制、医疗、能源等高风险领域不敢贸然引入自主智能体的核心顾虑。
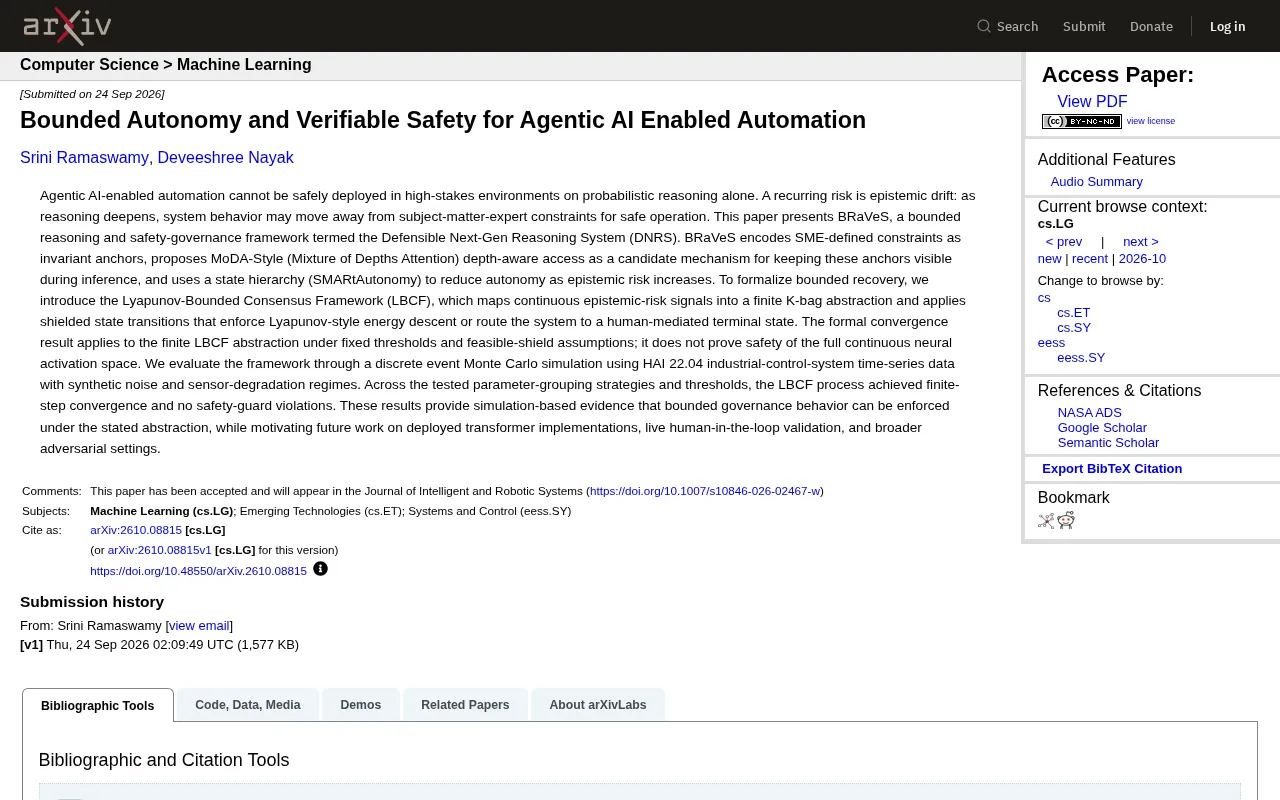
论文提出的解决方案被称为 BRaVeS(Bounded Reasoning and Safety-governance),也被作者命名为"可辩护的下一代推理系统"(Defensible Next-Gen Reasoning System, DNRS)。其核心思路不是追求无限的智能,而是为智能划定可验证的边界。
BRaVeS框架的三层设计
BRaVeS并非单一机制,而是由多个相互配合的组件构成的治理体系。理解它的关键在于把握"约束"与"自主"之间的动态平衡。
不变锚点:把专家约束写进推理过程
框架的第一层是将SME定义的约束编码为不变锚点(invariant anchors)。这些锚点代表了领域专家认定的安全运行底线,在整个推理过程中必须始终可见、不可逾越。这解决了一个常见痛点:传统大模型在长链推理中容易"遗忘"初始约束,而锚点机制试图让安全规则贯穿始终。
MoDA风格的深度感知访问
为了让这些锚点在推理过程中持续发挥作用,论文提出借鉴 MoDA(Mixture of Depths Attention) 风格的深度感知访问机制。它作为一种候选方案,目标是确保无论推理深入到哪一层,安全锚点都不会从模型的"视野"中消失。这是对认知漂移的直接技术回应——在深度推理与安全约束之间架起一座持续连接的桥梁。
MoDA(Mixture of Depths Attention)是一种在Transformer架构中动态分配计算资源的注意力机制。传统Transformer对每一层的所有token一视同仁,而MoDA允许模型根据内容重要性决定哪些token需要在更深层继续参与注意力计算,哪些可以跳过部分层直接传递。这种"按需计算"的设计原本是为了提升推理效率,但BRaVeS借鉴了其"深度感知"的核心思想:即对不同信息赋予不同的"穿透深度"。在BRaVeS语境下,安全锚点被视为必须穿越所有推理深度的高优先级信息,始终保持在注意力上下文中,从而防止模型在长链推理中因注意力稀释而逐渐忽视安全约束。值得注意的是,论文将此作为候选方案而非已实现的硬件实现,其可行性仍有待在真实Transformer中验证。
SMARtAutonomy:风险越高,自主越低
第三层是名为 SMARtAutonomy 的状态层级机制,其设计哲学朴素而有力:随着认知风险的升高,系统的自主权限相应降低。当系统判断自身处于高不确定性或潜在危险状态时,会主动收缩决策范围,把更多控制权交还给人类或更保守的策略。这种"知进退"的设计,正是高风险场景所需要的安全气阀。
李雅普诺夫有界共识:给安全一个数学证明
论文最具理论分量的贡献,是引入了 李雅普诺夫有界共识框架(Lyapunov-Bounded Consensus Framework, LBCF),用于形式化"有界恢复"的概念。
其工作机制可以这样理解:系统将连续的认知风险信号映射到一个有限的"K-bag"抽象空间,然后施加受保护的状态转移(shielded state transitions)。这些转移要么强制实现李雅普诺夫式的能量下降(即风险持续收敛),要么将系统导向一个由人类介入的终止状态。借用控制理论中成熟的李雅普诺夫稳定性思想,论文为智能体的安全行为提供了可证明的收敛保证。
不过,作者在此处表现出难得的学术诚实:这一形式化的收敛结果仅适用于固定阈值和可行防护假设下的有限LBCF抽象,并不能证明完整的连续神经激活空间的安全性。这意味着框架证明的是治理层的有界性,而非底层神经网络本身的绝对安全。这种边界划分,恰恰反映了当前可验证AI安全研究的现实处境。
李雅普诺夫稳定性理论源于19世纪俄国数学家亚历山大·李雅普诺夫对动力系统稳定性的研究,是现代控制理论的基石之一。其核心思想是:如果能为一个系统找到一个"李雅普诺夫函数"(类比于物理系统的"能量"),且该函数沿系统轨迹单调递减并在平衡点为零,则可以严格证明系统最终会收敛至平衡状态,而无需直接求解复杂的微分方程。这一方法在机器人控制、航空航天和电力系统中被广泛用于证明安全边界。将其引入AI安全领域的挑战在于,神经网络的状态空间是连续且高维的,难以直接构造有效的李雅普诺夫函数。BRaVeS的处理方式是将连续空间离散化为有限的"K-bag"抽象,在这个缩减的状态空间中构造可行的证明,代价是放弃了对底层神经激活的完整覆盖。
工业数据上的仿真验证
理论之外,论文通过离散事件蒙特卡洛仿真对框架进行了评估。实验采用了 HAI 22.04 工业控制系统时间序列数据,并人为注入合成噪声与传感器退化场景,以模拟真实工业环境中的异常状况。
结果显示,在测试的多种参数分组策略和阈值配置下,LBCF过程均实现了有限步收敛,且未出现任何安全防护违规。这为"有界治理行为可以在既定抽象下被强制执行"提供了基于仿真的证据支持。
需要清醒看待的是,这些结论建立在仿真环境和特定抽象之上。论文明确指出了未来工作的方向:真实部署的Transformer实现、在线的人机协同验证(human-in-the-loop),以及更广泛的对抗性场景测试。从仿真到真实部署,中间仍有相当长的路要走。
HAI 22.04(Hardware-in-the-Loop Anomaly Injection 2022版本4)是一个面向工业控制系统安全研究的公开时间序列数据集,包含来自真实工业设备(如水处理、发电等场景)的传感器读数,以及人工标注的异常事件和攻击注入记录。该数据集常被用于评估异常检测算法在物理信息系统(Cyber-Physical Systems, CPS)中的表现,其特点是信号具有强物理约束(如温度、压力不能突变),且异常往往是缓慢漂移而非突变,与认知漂移的仿真需求高度契合。蒙特卡洛仿真则通过大量随机采样来估计系统在不确定条件下的统计行为,是在缺乏解析解时评估复杂系统可靠性的标准工程方法。两者结合,使得实验在保持可控性的同时,具备一定的工业场景代表性。
对智能体安全研究的启示
这篇论文的价值不在于提供一个即插即用的产品,而在于它提出了一种务实的安全治理范式。在业界普遍追求更强推理能力的当下,BRaVeS反其道而行,强调用可验证的边界约束换取可部署的安全性。
其中几个思路尤其值得关注:将安全理解为需要主动保持可见的"锚点"而非一次性的提示;用风险联动的自主权限分级替代"全自主或全人工"的二元选择;以及借助控制理论为AI安全提供形式化证明。这些探索指向了一个更成熟的智能体部署未来——不是无边界的智能,而是有界、可辩护、可被人类接管的智能。
对于正在考虑将Agentic AI引入高风险业务的团队而言,这篇论文提供了一个重要提醒:真正的安全不来自更深的推理,而来自对推理边界的明确治理。
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。