余弦相似度不够用:LangGraph对抗式事实审计器rag-critic

rag-critic用原子命题分解和NLI蕴含判断替代余弦相似度,为RAG加运行时门禁。
文章从RAG系统的“自信幻觉”问题切入:余弦相似度只衡量语义接近,无法保证生成内容中的每个断言都有检索上下文支持。Reddit开发者发布的rag-critic通过四步机制解决这一问题——把回答拆成原子命题、用NLI分类器判定SUPPORTED/CONTRADICTED/UNGROUNDED、计算0到1的接地分数、低于阈值时输出具体改写指令并中断图流程。它可通过create_critic_node和critic_router原生接入LangGraph,支持Groq、OpenAI、Ollama及离线启发式模式。文章同时指出其局限:缺少基准测试数据,0.85阈值仅为示例,NLI分类器在长尾事实和否定句上的误判率未经验证,建议先用领域失败案例集校准再用于发布门禁。
为什么余弦相似度救不了RAG的「自信幻觉」
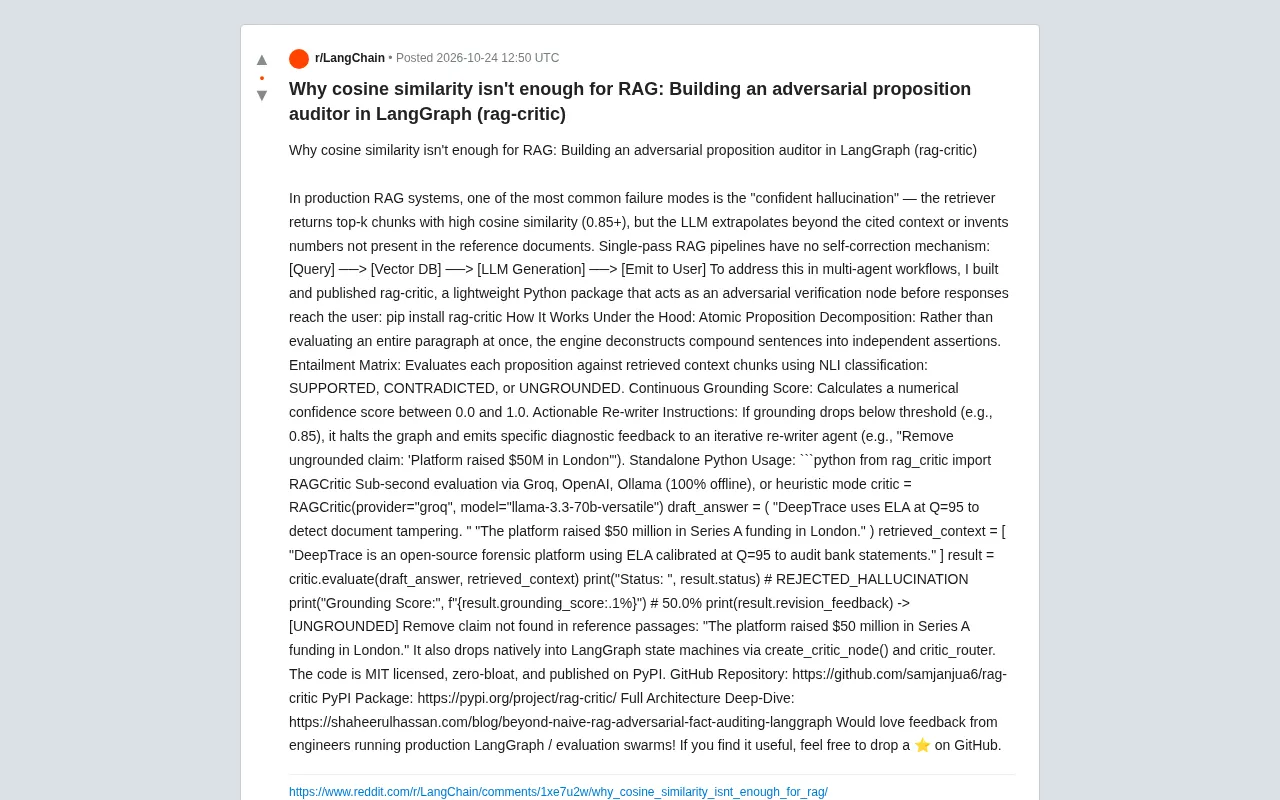
生产环境中的RAG系统经常栽在同一个坑里:检索器返回了余弦相似度0.85以上的top-k片段,LLM却在这些上下文之外自由发挥,甚至编造出参考文档里根本不存在的数字。这就是「自信幻觉」——模型语气笃定,依据却站不住脚。
传统单遍RAG管线的结构是 Query → Vector DB → LLM Generation → 输出给用户,中间没有任何自我纠错环节。向量相似度衡量的是语义接近程度,不是事实蕴含关系。一段话和问题在嵌入空间里挨得近,不代表它支持了模型说出的每一个具体断言。
Reddit上一位开发者发布的 rag-critic 正是冲着这个缺口去的:它是一个轻量级Python包,在响应送达用户之前充当对抗式验证节点。安装方式只有一行 pip install rag-critic,MIT协议,已发布到PyPI。
拆句、判蕴含、算分数:rag-critic的四个机制
据作者在Reddit帖中的说明,rag-critic的核心流程分四步。
原子命题分解:不整段评估,而是把复合句拆成独立断言。一段话里混着三个事实,其中两个有据可查、一个凭空捏造,整段打分只会掩盖问题。
蕴含矩阵:对每条命题用NLI分类器对照检索到的上下文块,判定为 SUPPORTED、CONTRADICTED 或 UNGROUNDED。这是与余弦相似度最本质的区别——相似度只给一个连续值,蕴含判断给的是带方向的事实关系。
连续接地分数:输出0.0到1.0之间的数值置信度,便于设阈值做工程决策。
可执行的改写指令:接地分数跌破阈值(作者举例0.85)时,图会暂停,并向迭代改写代理发出具体诊断,比如「删除无依据断言:'Platform raised $50M in London'」。
NLI(自然语言推理) 是自然语言处理中的一项基础任务:给定一个“前提”文本和一个“假设”句子,判断假设相对于前提属于蕴含(entailment)、矛盾(contradiction)还是中性/无关(neutral)。NLI分类器通常基于BERT、DeBERTa、RoBERTa等预训练模型在MNLI、SNLI等大规模数据集上微调而来。在RAG审计场景中,检索到的上下文块充当“前提”,模型生成的原子命题充当“假设”,分类器输出即为该命题的接地判定。相比余弦相似度只能衡量语义距离,NLI直接建模的是两个文本之间的逻辑关系方向,因此能区分“语义相关但事实相反”这种相似度无法捕捉的情形。需要注意的是,通用NLI模型在数值推理、否定嵌套和长尾实体上准确率会下降,这也是审计质量的核心瓶颈之一。
代码示例:一个被拒绝的回答长什么样
作者给出的独立Python用法中,草稿答案包含两句:一句关于DeepTrace用ELA在Q=95下检测文档篡改,另一句声称该平台在伦敦完成了5000万美元A轮融资。检索上下文只支持第一句。
from rag_critic import RAGCritic

critic = RAGCritic(provider="groq", model="llama-3.3-70b-versatile")
result = critic.evaluate(draft_answer, retrieved_context)
print("Status: ", result.status)              # REJECTED_HALLUCINATION
print("Grounding Score:", f"{result.grounding_score:.1%}")  # 50.0%
输出状态为 REJECTED_HALLUCINATION,接地分数50%,反馈明确指出融资那条命题在参考段落中找不到。这个例子很能说明问题:整段话的语义与上下文高度相关,余弦相似度大概率会很高,但其中一半的断言是无根的。
评估延迟方面,作者称通过Groq、OpenAI、Ollama(可100%离线)或启发式模式可做到亚秒级。
接入LangGraph:create_critic_node与critic_router
对于跑多代理工作流的团队,rag-critic提供了原生LangGraph接入方式:create_critic_node() 生成验证节点,critic_router 负责根据审计结果路由。接入后,图结构从线性变为带条件分支的循环——审计不通过就退回改写代理,而不是直接吐给用户。
这实际上是把「评估」从离线指标变成了在线控制流的一部分。多数团队的RAG评估还停留在跑完一批测试集看分数,而rag-critic的思路是在每次生成时做门禁。
LangGraph 是LangChain团队推出的用于构建有状态、多代理工作流的编排框架。它把应用建模为一张图:节点(node)是执行单元,边(edge)定义流转方向,而条件边(conditional edge)允许根据运行时状态动态选择下一步。这种结构天然适合循环和分支,例如“生成→审计→不通过则退回改写”的闭环。create_critic_node() 返回的就是一个符合LangGraph节点签名的可调用对象,接收并更新共享状态;critic_router 则是一个路由函数,读取审计结果后决定继续走向输出节点还是回退到改写节点。与线性链(Chain)相比,LangGraph的门禁式图结构使得“评估即控制流”成为可能,而不必把验证逻辑硬编码在业务代码中。
它解决了什么,没解决什么
值得肯定的是问题定位准确。余弦相似度作为检索召回指标没问题,但把它当作事实性保障是类别错误。原子命题分解加NLI蕴含判断,是把「这段话是否相关」升级为「这句话是否有据」,粒度更细,可解释性也更强——诊断反馈能直接告诉改写代理删哪句,这比一个笼统的低分有用得多。
需要保留的地方同样明显。原文没有给出任何基准测试数据:在什么数据集上、接地分数的阈值如何校准、NLI分类器的误判率是多少,均未涉及。阈值0.85只是作者举的例子,不同领域的合适阈值可能差别很大。此外,NLI分类器本身在长尾事实、数值比较、否定句上的表现会直接影响审计质量,这一点原文没有展开。
对正在跑生产LangGraph或评估集群的工程师来说,这个包值得一试——它足够轻,接入成本低,而且把「对抗式审计」这个思路做成了可复用的节点。但在依赖它的门禁做发布决策之前,建议先用自己领域的失败案例集测一轮,看看接地分数与人工判断的一致性。
RAGAS(Retrieval Augmented Generation Assessment)是当前较流行的RAG评估框架,提供faithfulness、answer relevancy、context precision/recall等指标,主要面向离线批量评测:给定问题集与生成结果,计算聚合分数并做回归对比。它的faithfulness指标同样会做命题级分解,但产物是数据集级别的统计量,而非单次请求的放行/拦截信号。rag-critic与RAGAS并非替代关系:前者是运行时门禁,后者是开发期质量看板。实践中常见的组合是用RAGAS做迭代评估、用rag-critic做线上拦截,两者共享“原子命题+蕴含判断”的方法论,但服务的目标不同——一个优化长期指标,一个保障单次输出。
常见问题
rag-critic和RAGAS之类的评估框架有什么区别? RAGAS偏向离线批量评估,rag-critic定位是运行时节点,审计不通过会阻塞图并触发改写,属于在线控制流组件。
必须联网吗? 不必。作者说明支持Ollama本地模型,可100%离线运行,也有启发式模式。
接地分数多少算合格? 原文以0.85为例,但这是示例值而非推荐值,需要按领域自行校准。
相关推荐
OpenAI Dots vs Anthropic Claude Duet:AI助理竞争升级
Anthropic 推出 Claude Duet,与 OpenAI Dots、Meta Muse 形成 AI 助理竞争新格局。本文解析三款产品的定位差异、云端运行与敏感操作审批机制,以及 AI 竞争从回答质量转向任务执行的行业信号。
Claude Duet发布:主动型智能体迈出第一步,审批卡成关键约束
Anthropic 推出研究预览版 Claude Duet,Claude 可主动推送简报、语音交办任务,并通过审批卡控制发送、付款、删除等操作。本文分析其主动交互逻辑、安全隔离设计与主动型智能体的信任挑战。
大模型价格战:OpenAI与Anthropic为何降价80%?
OpenAI和Anthropic在几个月内将LLM价格下调高达80%,本文分析价格战背后的竞争、技术成本、商业模式转变及行业影响。