语言不可读性:大模型安全的隐藏攻击面

LLM安全防线因"语言不可读性"出现结构性盲区:模型能理解的,防御系统却看不懂。
大语言模型的安全防护面临一个被低估的结构性挑战——语言不可读性:当输入内容对模型清晰可解、却对人类审核者和过滤系统难以辨识时,安全边界就会被悄然突破。现有安全机制大多预设"有害内容应当可被识别",但攻击者可以利用罕见语言、编码变体、隐喻嵌套等手段,构造出对防御层不透明却被模型照常执行的输入。更深层的问题在于,现代大模型的多语言与语义推理能力往往超过配套安全系统的解析能力,形成可被系统性利用的缺口。应对这一挑战,需要让安全系统的理解能力对齐模型能力边界,从关键词过滤转向语义意图判断,并正视人工审核在不可读输入面前的固有局限。
当语言变得"不可读",LLM安全防线为何失效
大语言模型(LLM)的安全防护正面临一个容易被忽视的挑战:语言的"不可读性"(Linguistic Illegibility)。这个概念指的是,当输入内容对人类审核者或传统过滤系统来说难以理解、难以解析或难以判定意图时,模型的安全边界就可能被悄然突破。
围绕这一话题,Hacker News社区展开了讨论。虽然讨论规模不大(15个赞、4条评论),但它触及了LLM安全领域一个相当本质的问题:安全护栏的有效性,高度依赖于系统能否"看懂"输入究竟在表达什么。当输入进入人类和自动化系统都难以清晰解读的灰色地带时,防御机制往往会出现盲区。
什么是"语言不可读性"
语言不可读性并不等同于乱码或无意义文本。它更多指向那些在形式上合法、但在意图和语义上模糊难辨的输入。比如:
- 使用罕见语言、方言或混合多种语言编写的提示词
- 通过编码、变体拼写、隐喻或间接表达来传递真实意图
- 依赖上下文层层嵌套,使得单独看某一句话无法判断其真实目的
这些输入的共同特征是:它们对模型仍然"可读"——模型能够理解并响应,但对人类审核者和基于规则的过滤器却"不可读"。这种模型理解能力与人类监督能力之间的错位,正是安全风险的温床。
语言不可读性的概念与AI安全领域中的"越狱"(Jailbreak)和"提示词注入"(Prompt Injection)密切相关,但属于不同的攻击维度。越狱通常通过角色扮演、虚构场景或指令覆盖来绕过模型的行为约束;提示词注入则是在输入中嵌入隐藏指令来劫持模型行为。而语言不可读性攻击的核心在于利用表达形式本身制造理解盲区——攻击者不是欺骗模型,而是欺骗模型之外的防御层。典型手段包括:将敏感词汇用Unicode变体字符替换(如用"ℍello"代替"Hello")、混用多种语言切换表达语境、利用低资源语言(如某些非洲或东南亚方言)绕过仅覆盖主流语言的过滤器,以及通过多轮对话将有害意图拆散在无害的片段中。这类攻击之所以难以防御,正是因为它没有破坏模型的任何规则,而是在规则的盲区中穿行。
为什么这会成为安全隐患
绝大多数LLM安全机制都建立在一个隐含假设之上:如果一段内容有害,它应当是可被识别的。无论是关键词过滤、内容分类器,还是人工审核流程,本质上都需要先"理解"输入,才能判断其是否越界。
但语言不可读性打破了这个假设。攻击者可以构造出对模型清晰、对防御系统模糊的输入,从而绕过检测。这类攻击的隐蔽性在于:它不需要暴力破解或明显的恶意关键词,而是利用了理解能力的不对称性。
理解能力的不对称
现代大模型的多语言能力和语义推理能力往往超过了配套安全系统的解析能力。一个模型可能能够流畅处理数十种语言、识别隐喻和间接表达,但负责审核的过滤器或人工团队却未必具备同等的覆盖范围。
这就形成了一个危险的缺口:模型能"听懂"的东西,防御系统"听不懂"。攻击者只要找到这个缺口,就能让有害意图以合法外观通过审查。这也解释了为什么单纯扩充关键词黑名单或依赖单一语言的审核难以根治问题。
这种不对称性在多语言场景下尤为突出,并已被研究人员实证。已有多项学术研究发现,将同一有害问题从英语翻译成低资源语言后,主流LLM的拒绝率会显著下降——这是因为模型的安全训练数据(RLHF中的人工反馈)大量集中于英语,而多语言能力的习得则来自更广泛的预训练语料,两者的覆盖范围存在系统性错位。此外,内容审核所依赖的分类器通常也以英语为中心训练,对其他语言的有害内容检出率较低。这意味着安全能力的缺口并非随机分布,而是高度集中在非英语语言和非主流表达方式上,形成了可被有针对性利用的结构性弱点。
对LLM安全设计的启示
这一讨论对构建更稳健的AI安全体系提出了几点值得思考的方向。
防御应当匹配模型的理解边界
安全系统的解析能力需要尽量对齐模型本身的理解能力。如果模型能理解某种语言或表达方式,那么针对该语言的安全检测也应当存在,否则就会留下可被利用的空档。这意味着安全投入不能只覆盖主流语言和常见表达,而要考虑模型实际能力所触及的全部范围。
从表层过滤转向意图理解
依赖表层特征(如关键词匹配)的过滤方式,天然容易被语言变体和编码手段绕过。更可持续的方向是让安全判断更接近对"意图"的理解——利用模型自身的语义能力来辅助识别可疑输入,而不是仅靠外部的规则匹配。用模型来防御模型,可能是应对语言不可读性的现实路径之一。
利用模型自身来辅助安全判断的思路,在业界通常被称为"LLM-as-a-Judge"或"模型自我审查"(Self-Critique)机制。其基本做法是:在输出前增加一个独立的判断步骤,让另一个模型实例(或同一模型的独立调用)对原始输入或生成内容进行意图评估,而不是依赖外部规则库。这种方法的优势在于,语义理解能力与安全判断能力使用同一基础,天然对齐;缺点则是引入了额外的推理成本,并可能出现"攻守同质化"问题——即攻击者同样可以用语言不可读性手段欺骗充当裁判的模型。因此,这一路径通常需要与其他防御层(如沙箱隔离、输出后监控)结合使用,而非单独依赖。
承认监督的固有局限
人工审核在面对不可读输入时存在天然瓶颈。审核者无法审查自己看不懂的内容。因此,安全架构设计需要正视这一局限,不能把人工审核当作万无一失的最后防线,而应通过分层防御、自动化辅助和持续监控来弥补。
小结
语言不可读性揭示了LLM安全领域一个结构性的挑战:模型的理解能力与安全系统的解析能力之间存在鸿沟,而这道鸿沟正是攻击者可以利用的空间。随着大模型的多语言和推理能力不断增强,这种不对称可能会进一步扩大。
虽然目前相关讨论还处于早期阶段,但它提醒开发者和安全团队:真正稳健的防御,需要让"能理解"和"能审查"这两件事尽可能对齐。只有当安全系统能够跟上模型理解能力的脚步,才能避免在语言的灰色地带失守。
相关推荐
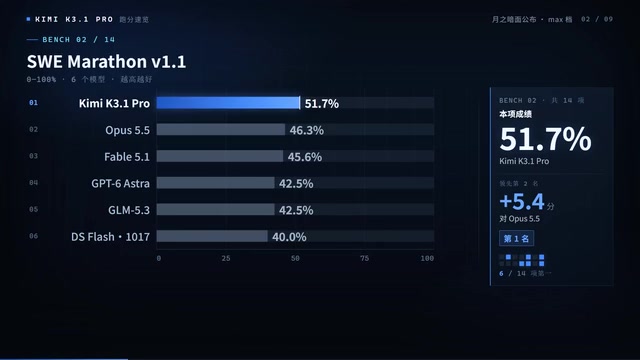
Kimi K3.1 Pro跑分曝光:14项测试6项第一,编程直追Opus
Kimi K3.1 Pro跑分公布:14项测试6项第一,场任务编程51.7超Opus,终端实战65.7仅差0.7分,幻觉率从23.4%降至8.3%,高速版支持百万上下文并计划开放权重。

谷歌Agent Compute Engine:每个Agent一个microVM
谷歌Agent Compute Engine为每个AI Agent分配独立microVM且不存凭证,本文解析其隔离设计与凭证管理思路,梳理已公开与未公开细节,并给出构建者可立即借鉴的三条实践。

付费AI写作研究谁最强?Reddit用户激辩ChatGPT与Gemini
Reddit用户热议付费AI聊天机器人写作研究能力:资深写作者发现免费Gemini输出胜过付费ChatGPT,社区讨论聚焦写作质量、研究场景偏好及提示词工作流,揭示免费与付费边界模糊下的工具选择策略。