扎克伯格称AI将接管整个业务,数据归属风险不容忽视

扎克伯格的大胆预言
Meta近期推出了一款面向企业的AI智能体(AI Agent),主打自动处理客户对话、预约排期以及促成销售转化。发布会上,马克·扎克伯格抛出了一个相当激进的判断:这些智能体最终将能够"运营你的整个业务"。
什么是AI智能体? AI智能体是一种能够自主感知环境、制定决策并执行行动以完成特定目标的AI系统。与传统聊天机器人不同,AI智能体具备"规划-执行-反馈"的闭环能力:它不仅能理解自然语言指令,还能调用外部工具(如数据库、API、日历系统),将复杂任务分解为多步骤子任务并自主完成。
从技术架构看,现代AI智能体通常由四个核心模块构成:感知层(解析自然语言输入与上下文)、规划层(基于ReAct框架或Chain-of-Thought进行任务分解)、执行层(通过Function Calling与外部系统交互)、记忆层(结合短期上下文窗口与向量数据库实现长期知识检索)。正是这一架构的成熟,使AI从单轮问答跃升至多步骤自主执行——2023年OpenAI正式开放GPT-4的Function Calling能力是关键里程碑,标志着LLM开始具备与外部世界系统性交互的接口。Meta此次推出的企业AI智能体,正是将这套能力封装进其社交商业生态,使中小企业无需任何AI工程能力即可直接部署。
ReAct框架与Chain-of-Thought的技术溯源: ReAct框架由谷歌与普林斯顿大学研究团队于2022年联合提出,其名称来源于"Reasoning + Acting"的结合。传统LLM在执行任务时,推理过程与行动步骤相互割裂,ReAct通过将思维链(思考过程)与工具调用(行动步骤)交织编排,使模型能够在每次行动后观察结果并动态调整后续策略,显著提升了多步骤任务的成功率。Chain-of-Thought则由谷歌Brain团队于2022年提出,通过要求模型在给出最终答案前显式输出中间推理步骤,大幅提升了复杂数学推理和逻辑判断的准确率——在部分基准测试中准确率提升幅度超过40%。两者的结合,构成了当前主流AI智能体规划层的核心技术底座。此外,记忆层中的向量数据库同样不可忽视:它将历史客户对话、产品知识库和FAQ文档转化为高维向量(Embedding),通过近似最近邻算法(ANN)实现语义相似度检索,使智能体在回答新问题时能够检索相关历史语境,从根本上解决了LLM"记忆短暂"的先天缺陷。Meta自身开源的FAISS(Facebook AI Similarity Search)库是业界最广泛使用的向量检索底层工具之一,但其设计定位为研究级批量检索工具,企业在自建智能体时通常会选择Pinecone、Qdrant或Milvus等具备完整API与监控能力的生产级方案。
这番话乍听颇具科幻色彩,但结合当前生成式AI与自主智能体的技术进展来看,并非空穴来风。
从2022年ChatGPT到2024年多模态智能体的演进,本质上是大语言模型从"语言理解系统"向"认知执行系统"的范式跃迁。 这一过程中,三个关键技术节点构成了当前AI智能体商用化的技术前提:其一,2022年底InstructGPT论文确立了RLHF(人类反馈强化学习)作为模型对齐的主流方法,使LLM从"预测下一个词"进化为"理解并执行人类意图";其二,2023年GPT-4发布时同步开放的Function Calling能力,首次将LLM与外部系统的交互标准化为结构化接口,这是智能体从"对话者"变为"执行者"的技术转折点;其三,2024年Anthropic发布的Claude 3系列引入了200K tokens的超长上下文窗口,配合Google Gemini 1.5 Pro的100万tokens上下文,从根本上扩展了智能体处理复杂、长链条任务的边界。正是这三次突破的叠加,使Meta得以在2024-2025年将企业级AI智能体作为成熟产品推向市场。生成式AI自2022年ChatGPT引爆公众视野以来,经历了从"对话助手"到"自主执行者"的快速演进:2024年,Anthropic的Claude、Google的Gemini相继强化了多步骤推理与工具使用能力。ReAct(推理+行动)、Chain-of-Thought(链式思维)等Agentic AI框架的成熟,使得智能体在复杂任务中的可靠性大幅提升。当Meta这样体量的平台将原生自主化工具直接嵌入业务流程时,恰恰说明AI智能体已不再是技术爱好者的实验玩具,而是逐步迈向生产环境的成熟能力。
AI智能体的可靠性边界: 尽管技术进步显著,当前AI智能体仍存在不可忽视的局限性。大语言模型的"幻觉"(Hallucination)问题在客户服务场景中可能造成错误承诺或信息误导——其根源在于LLM的本质是概率预测系统,目标是生成"统计上合理"的输出而非保证事实绝对准确。业界主要通过三种路径缓解幻觉:RAG(检索增强生成,强制模型基于企业知识库内容作答)、置信度阈值机制(低确定性时自动转人工)、以及事实核查层(输出前对关键信息交叉验证)。多步骤任务中的错误累积效应(Error Propagation)会使复杂流程的成功率大幅下降;此外,对抗性输入(Adversarial Inputs)——即用户故意构造的异常问题——仍是企业部署智能体时需要预设人工兜底机制的重要原因。Meta的原生工具在针对其生态场景的优化上有先天优势,但对于高客单价或强合规要求的业务,人工审核节点仍不可或缺。
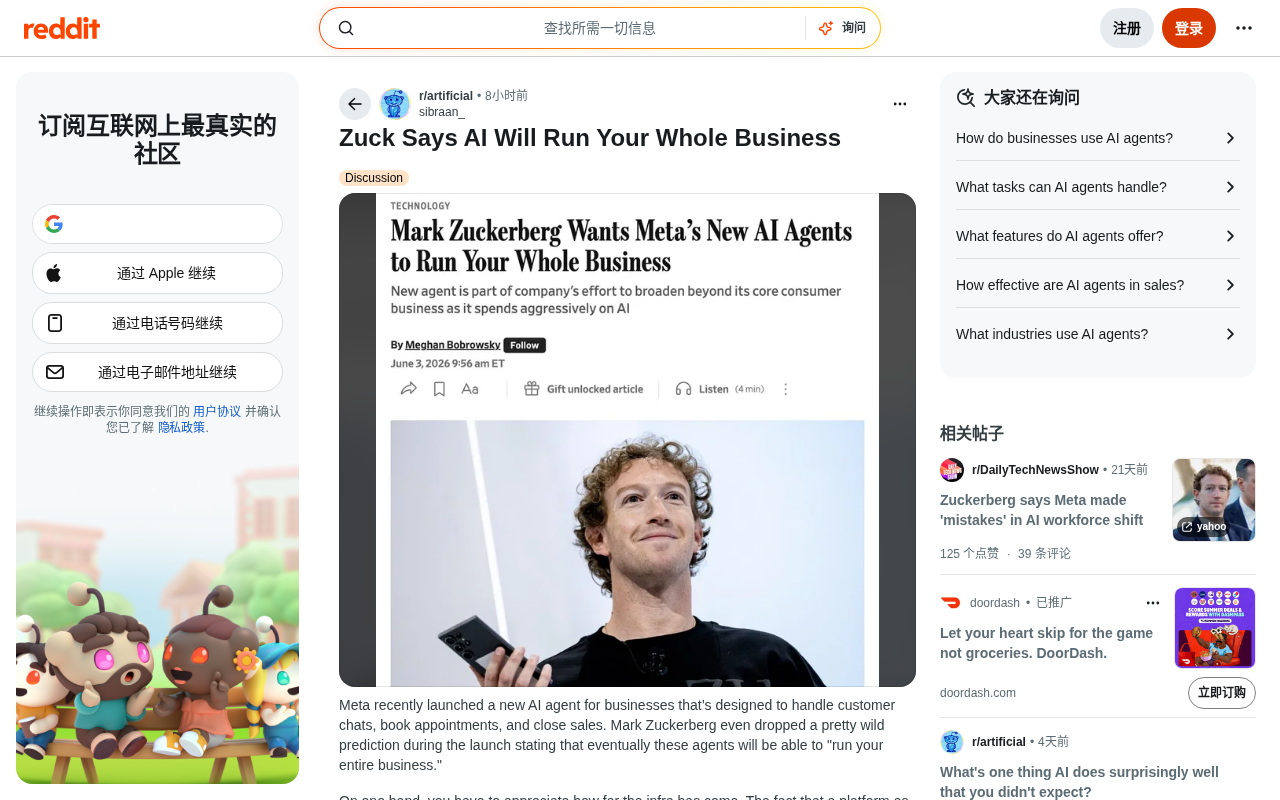
AI智能体基础设施已具备商用规模
从行业视角看,Meta此举最值得关注的不是产品本身,而是它所释放的信号:AI智能体的底层基础设施已足够稳健,能够被大规模商用部署。
对于客户服务和排期这类高频、重复、规则相对明确的场景,AI智能体确实能节省大量人力。想象一家电商每天处理成百上千条Instagram私信——从"这件还有货吗"到"什么时候发货",这类高度模板化的交互正是智能体的用武之地。
Meta商业生态的战略纵深: Meta的企业AI智能体并非孤立产品,而是其"超级应用"战略的关键一环。Meta自2021年起便开始将WhatsApp Business API向中小企业开放,2023年推出Meta Business Suite整合广告、内容与私信管理,此次AI智能体的加入,标志着Meta正在将"流量入口→用户互动→销售转化→客服售后"的全链路闭环完全纳入自身生态。
值得深究的是,这一战略的底层逻辑与Meta过去十年的扩张路径高度一致:2012年收购Instagram是为了获取移动端视觉内容流量,2014年收购WhatsApp是为了拿下私信与即时通讯场景,如今将AI智能体植入商业流程,则是在争夺企业与消费者之间商业交互数据的控制权。每一次产品扩张,本质上都是在扩大数据采集的广度与深度,进而持续强化其广告定向引擎的精度。
从技术层面理解,当企业通过Meta原生AI智能体开展客户对话时,这些数据可能被纳入其"转化API"(CAPI)体系——这是Meta在苹果ATT框架冲击后推出的服务端数据上报机制,允许企业将网站、CRM乃至线下销售数据直接上传至Meta服务器以增强广告归因精度。换言之,企业使用原生AI智能体越深度,Meta获得的转化信号就越完整,企业业务数据与Meta广告能力提升之间形成了一种隐性的"以数据换服务"关系,而这种不对等性往往被原生集成的便利性所掩盖。理解这一纵深布局,有助于准确判断智能体工具的战略意图:它不仅是效率工具,更是Meta构建企业级护城河的关键棋子。
谁是最大受益者?
对本地中小企业(SMB)和电商店铺而言,这种原生集成堪称重大利好。它们本就依附Meta的社交生态获客,将客服和转化环节交给平台原生工具,既降低了技术门槛,又实现了流程闭环。能用现成工具处理海量私信,就是实实在在的效率提升。
然而,SMB对社交平台的依赖问题并非新议题。中小企业对社交平台的依赖性风险,在互联网商业史上已有多次警示性案例。 2012年Facebook完成IPO后开始压缩品牌页面的自然覆盖率(Organic Reach),至2014年品牌页面的自然触达已从历史峰值的16%骤降至约2%,迫使企业转向付费推广。2018年算法更新进一步将内容分发权重从品牌页面向个人用户帖子倾斜,依赖免费流量的内容电商品牌流量下滑幅度超过70%。2021年苹果ATT框架落地后,Meta的广告归因精度受损,部分依赖Instagram广告的DTC(直接面向消费者)品牌获客成本在六个月内上涨了40%-80%。这些历史案例揭示了一条规律:当平台商业模式与商家利益发生冲突时,规则变更的成本将完全由商家承担——过去十年,无数小商家将品牌建设、获客转化乃至客服体系全部押注在Facebook或Instagram上,却在算法调整或平台政策收紧时遭受重创。AI智能体的引入,使得这种依赖关系进入了新的深度阶段:不仅是流量依赖,而是运营数据与客户关系的全面托管,风险敞口从获客环节延伸至客户关系全生命周期。
不可回避的核心问题:数据所有权
然而,热闹背后有一个必须直面的关键隐患——数据所有权归属。
理解数据所有权的战略价值: 第一方数据(First-Party Data)是指企业通过直接与用户交互所收集的数据——包括购买记录、咨询历史、偏好行为等——其价值远高于从第三方购买的数据,因为它真实、及时且专属。
当前,第一方数据的稀缺性正被多重因素叠加推高。监管层面,过去五年全球主要经济体的数据隐私立法已形成系统性压力。2018年欧盟GDPR(通用数据保护条例)正式实施,确立了"数据最小化原则"与"被遗忘权",并对违规企业设置了最高全球年营收4%的天价罚款上限——2023年Meta因违反GDPR被爱尔兰数据保护委员会处以12亿欧元罚款,创GDPR实施以来最高纪录。2020年加州消费者隐私法案(CCPA)落地,2021年中国个人信息保护法颁布,主要经济体的隐私监管框架已基本成型,企业从第三方渠道合规获取用户数据的成本急剧上升。技术层面,谷歌加速推进第三方Cookie淘汰计划,苹果iOS 14.5引入应用追踪透明度(ATT)框架,据Meta自身披露,ATT的落地直接导致其广告归因精度下降约30%,单年损失估计超过100亿美元。这一监管框架的深层含义是:企业将客户数据完全托管于第三方平台,不仅面临数据主权丧失的商业风险,更可能在平台发生合规事件时成为连带受害者。在此背景下,企业若将客户交互全部托管于Meta平台,不仅面临数据主权丧失的风险,更可能在平台规则变更或账号封禁时,瞬间失去与客户沟通的全部能力——这一风险在过去数年中已有大量真实案例印证。
将整条运营数据管线、客户交互记录以及潜在客户线索信息,全部交给一个商业模式高度依赖广告投放的超级平台,本身就蕴含结构性风险。Meta旗下拥有Facebook、Instagram、WhatsApp三大平台,月活用户合计超过38亿,广告收入占其总营收的97%以上。Meta的广告系统本质上是一个数据驱动的精准投放引擎——用户在平台上的每一次互动、每一条私信、每一个购买行为,都会被纳入其用户画像体系,进而提升广告定向精度。其核心技术架构"Meta Advantage+"整合了跨平台行为数据、社交图谱关系、设备信号与购买意图数据,是业界定向能力最强的广告系统之一。
核心矛盾在于利益链条的错位:当一个平台同时掌控你的获客渠道和运营销售流程的基础设施时,企业未来可能面临一种尴尬局面——以广告优化的形式,付费买回本属于自己的数据。换句话说,平台先用AI智能体沉淀你的客户数据,再将这些数据反向变现为更精准的广告定向,而你需要为此持续付费。
便利与掌控权的本质取舍
这是一道关于"便利"与"数据主权"的经典权衡题。原生集成带来的即插即用体验,代价是将最核心的商业资产——客户关系与数据——托付给第三方平台。对依赖平台流量的小商家,这笔交易或许划算;但对将客户数据视为核心竞争力的企业,风险则被急剧放大。
不同业务形态的应对策略
是否拥抱Meta原生AI智能体,答案并非非黑即白,取决于具体业务形态。
适合原生集成的场景:
- 本地中小企业和线下服务商
- 处理高频Instagram私信的电商店铺
- 客单价较低、交易链条短、决策周期快的业务
对这类玩家而言,用平台工具处理海量咨询和预约,投入产出比极高。
建议保持数据独立的场景:
- 高客单价的B2B SaaS企业
- 初创公司与营销代理机构
- 客户线索价值高、销售周期长的业务
对于后者,构建独立、开放的工作流仍是最稳妥的策略——独立站建设(如Shopify)、自有CRM系统(如HubSpot)、以及独立通讯渠道(如邮件列表)的构建,都是对冲平台依赖风险的有效手段,也是自主掌控数据链路和触达保障机制的基础。
CDP与数据独立的技术路径: 对希望保持数据主权的企业而言,构建自主数据体系并非遥不可及,现代技术栈提供了一套切实可行的解耦方案。
CDP(Customer Data Platform,客户数据平台)是其中的核心枢纽。与传统CRM不同,CDP专注于"身份解析"(Identity Resolution)——将同一用户在Meta私信、官网访问、邮件点击、线下消费等不同渠道留下的碎片化行为,通过确定性匹配(邮件/手机号)和概率性匹配(设备指纹、行为模式)整合为统一客户档案。其战略价值在于:即便Meta发生政策变更或账号封禁,企业仍持有完整的客户数据副本,可在其他渠道继续触达——这是数字时代企业韧性(Business Resilience)的基础设施保障。
数据采集层:CDP如Segment或开源的RudderStack,可统一采集来自Meta、官网、邮件、线下等多渠道的用户行为数据。客户管理层:HubSpot的免费tier覆盖中小企业大部分CRM需求,开源方案SuiteCRM则支持私有化部署,彻底避免数据上传第三方。自动化同步层:Make(原Integromat)或开源自托管的n8n,可将Meta渠道的对话数据通过Webhook实时同步至自有数据库,实现"双轨并行"——Meta负责引流与对话,自有系统负责数据沉淀与客户生命周期管理。这一架构在享受平台流量红利的同时,完整保留了数据主权,是当前兼顾效率与风险控制的最务实工程实践。
当每条线索都价值不菲、每次转化都关乎生死时,把数据主权握在自己手里,远比一时便利更重要。
在效率红利与数据风险之间走稳这条线
Meta的这步棋清晰表明,AI智能体正从概念走向商业主流,这一趋势无可逆转。技术的成熟令人振奋,但技术背后的商业结构同样值得警惕。
扎克伯格描绘的"AI运营整个业务"愿景固然诱人,但企业主真正需要思考的是:在把业务交给AI的同时,你是否也把定义业务命运的数据主权一并交了出去?
在效率红利与数据风险之间,如何走好这根钢丝,将是每一个想要拥抱AI智能体的企业,都必须做出的战略抉择。
核心要点
- AI智能体已进入商用阶段:技术架构(感知-规划-执行-记忆四层模型)的成熟——包括ReAct框架、Chain-of-Thought推理链与向量数据库记忆层的协同——使得AI智能体从实验室走向生产环境,Meta的规模化部署是行业成熟度的重要信号。从RLHF对齐到Function Calling标准化,再到超长上下文窗口的突破,三个关键里程碑共同构成了这一商用化跃迁的技术基础。
- 中小企业是最直接的受益者:高频、低决策复杂度的客服与排期场景,原生集成的投入产出比极高,但需警惕平台依赖风险的深化——历史上品牌自然流量骤降70%的案例,已是SMB平台依赖风险的清醒前车之鉴。
- 数据所有权是核心战略议题:在第三方Cookie退出、全球隐私监管收紧(GDPR、CCPA、中国个保法三重框架叠加)的大背景下,第一方数据的稀缺性持续上升,将客户交互数据托管于广告平台存在结构性风险;Meta的CAPI机制更使这一风险从流量层延伸至转化数据层。
- 解耦不等于放弃平台:通过CDP+CRM+自动化同步的技术组合,企业可在享受Meta流量红利的同时,在自有系统中保留完整数据副本,利用CDP的身份解析能力构建跨渠道统一客户视图,实现双轨并行的最优策略。
- 高价值业务须优先保障数据主权:客单价高、销售周期长、线索价值大的业务,构建独立数据基础设施的长期收益,远超平台原生工具带来的短期便利。在合规监管日趋严格的全球环境下,数据主权同时也是规避连带合规风险的防火墙。
相关推荐

Anthropic递交S-1:半年营收163亿、净亏807亿,谁在控制公司?
Anthropic递交S-1申请纳斯达克上市:2026上半年营收163亿美元、净亏损807亿美元源于估值重估而非现金流出,创始人持Class F股份掌握50.1%投票权,发行价与日期尚未公布。

Anthropic递交S-1:163亿营收与807亿亏损背后的真相
Anthropic S-1文件披露2026上半年163亿美元营收与807亿美元净亏损,其中724亿为会计效应。文件同时揭示2656亿美元算力承诺、云协议细节及创始人50.1%投票权控制结构,IPO定价仍留白。

Anthropic财务数据曝光:营收远超算力成本,Claude推理毛利率达68%
Anthropic泄露财务数据显示,其营收约为总算力成本两倍,Claude推理毛利率达68%,而前沿训练单季烧掉28亿美元。本文拆解推理与训练两笔账,分析AI公司估值逻辑的变化与数据的审慎解读。