掌握度阈值不能一刀切:知识追踪模型的隐形陷阱
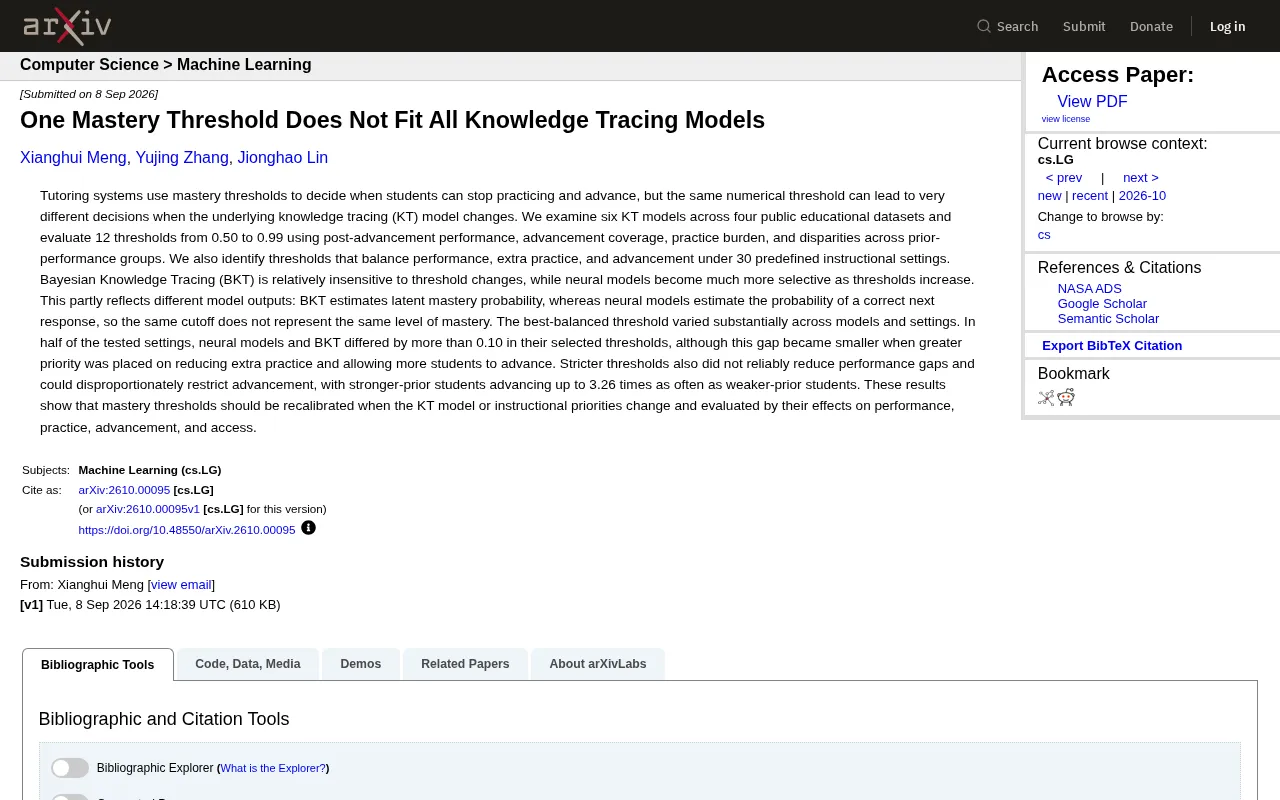
同一掌握度阈值在BKT与神经网络KT模型中含义根本不同,跨模型复用会导致教学不公平。
这篇研究揭示了智能辅导系统中一个被长期忽视的问题:掌握度阈值并非中性的技术参数,而是与底层知识追踪模型的输出语义深度绑定的教学决策工具。研究在四个数据集上对比了六种KT模型,发现BKT估计的是潜在掌握概率,神经网络模型估计的是下一题答对概率,两者在概念上根本不同,因此相同数值阈值会导致截然不同的教学行为。在半数测试场景下,两类模型的最优阈值相差超过0.10。更关键的是,提高阈值并不能可靠缩小学生表现差距,反而可能让先验能力强的学生推进频率最高达弱势学生的3.26倍,加剧教育不公平。研究建议从表现、练习负担、推进率和公平性四个维度综合校准阈值,且每次模型或教学目标变动时都需重新评估。
智能辅导系统(Tutoring Systems)广泛使用"掌握度阈值"(mastery threshold)来判断学生何时达到标准、可以停止练习进入下一环节。然而一篇新发布的研究指出,同一个数值阈值在不同的知识追踪(Knowledge Tracing, KT)模型下,会导致截然不同的教学决策——这意味着教育者可能在不知情的情况下,对不同学生群体施加了不公平的学习路径。
同一个数字,不同的含义
研究团队在四个公开教育数据集上评估了六种知识追踪模型,并测试了从 0.50 到 0.99 共 12 个阈值档位。评估维度包括:学生推进后的实际表现(post-advancement performance)、推进覆盖率(advancement coverage)、练习负担(practice burden),以及不同先验能力群体之间的差异。
核心发现是:贝叶斯知识追踪(BKT)对阈值变化相对不敏感,而神经网络模型随着阈值升高会变得明显更挑剔。这背后的原因并非模型"性格"不同,而是它们估计的东西本质上不一样。BKT 估计的是"潜在掌握概率"(latent mastery probability),而神经模型估计的是"下一题答对的概率"(probability of a correct next response)。
换句话说,当你把阈值设为 0.80 时,在 BKT 眼里这代表某种掌握水平,而在神经模型眼里它只是"答对下一题的可能性"。同一个 0.80 在两类模型中根本不代表同一件事。
贝叶斯知识追踪(BKT)由 Corbett 和 Anderson 于1994年提出,是教育技术领域历史最悠久的知识追踪模型之一。它将学生的知识状态建模为一个隐藏的二值变量——"已掌握"或"未掌握"——并通过四个参数来描述学习过程:初始掌握概率、学习率(每次练习后从未掌握转变为已掌握的概率)、猜测率(未掌握状态下答对的概率)和失误率(已掌握状态下答错的概率)。模型输出的是学生处于"已掌握"状态的后验概率,这是一个关于知识状态的潜在估计。
与之对比,深度知识追踪(DKT)等神经网络模型并不显式建模"掌握"这一潜在状态,而是直接利用学生的历史答题序列,通过循环神经网络或Transformer等架构预测学生在下一道题上答对的概率。这两种输出在语义上有根本差异:前者是对知识状态的概率估计,后者是对行为结果的概率预测。这正是同一数值阈值在两类模型中"含义不同"的根本原因。
阈值差异有多大
研究进一步在 30 种预设的教学场景下,寻找能在表现、额外练习和推进率之间取得平衡的阈值。结果显示,最优的"平衡阈值"在不同模型和不同场景间差异巨大。
在测试的半数场景中,神经模型与 BKT 选出的阈值相差超过 0.10。这个差距在教学目标更强调"减少额外练习、让更多学生推进"时会缩小,但在追求高表现保证时则会放大。对于直接套用某个"经验值"阈值的辅导系统来说,这种偏差足以改变成百上千名学生的学习节奏。
更严格 ≠ 更公平
研究中最值得警惕的一点,是关于教育公平的发现。直觉上,提高掌握度阈值似乎能保证学生真正学扎实,从而缩小强弱学生之间的差距。但数据给出了相反的结论。
更严格的阈值并不能可靠地缩小表现差距,反而可能不成比例地限制学生推进。研究量化了这一现象:在某些设置下,先验能力更强的学生推进的频率,最高可达弱先验学生的 3.26 倍。也就是说,一刀切的高阈值可能让本就落后的学生被卡在原地反复练习,而优等生则一路畅通——这与辅导系统缩小差距的初衷背道而驰。
这一发现与教育学中"马太效应"(Matthew Effect)的研究脉络一致:在缺乏个性化干预的系统中,既有优势的学生往往能从相同规则中获得更多收益。在自适应学习系统的语境下,统一的高阈值相当于用同一把尺子衡量起跑线不同的学生。先验能力强的学生本就更接近阈值,能以更少的练习次数触达它;而先验能力弱的学生则可能陷入"反复练习但始终无法达标"的循环,这不仅消耗学习动机,还造成事实上的机会不均等。研究中记录的3.26倍差距,提示阈值的设计本身就是一种隐性的资源分配机制,需要将公平性指标纳入系统设计的核心考量,而非事后审查。
对教育技术从业者的启示
这项研究的实践含义非常直接:掌握度阈值不是一个可以跨模型复用的"魔法数字"。
当底层 KT 模型发生变化(比如从 BKT 迁移到深度知识追踪 DKT),或者教学优先级调整(从"保表现"转向"促推进")时,阈值都必须重新校准。更重要的是,阈值的好坏不能只看单一指标,而应从四个维度综合评估:
- 表现(performance):学生推进后是否真的掌握了知识
- 练习(practice):是否带来了不必要的重复负担
- 推进(advancement):有多少学生能够顺利前进
- 公平(access):不同能力群体之间是否存在系统性差异
对于正在构建自适应学习系统的团队而言,这意味着不能简单地把论文里某个模型的最优阈值拿来即用。阈值选择本质上是一个与模型输出语义、数据分布和教学价值观深度绑定的工程决策。
结语
这篇研究把一个看似技术细节的问题,提升到了教育公平的高度。掌握度阈值这类"隐形参数"往往被工程师当作可调超参随手设置,却直接决定了真实学生的学习体验与机会分配。在越来越多教育产品引入神经网络 KT 模型的当下,重新审视并校准这些阈值,显得尤为必要。
相关推荐

Agentic Paper Bomb:用多智能体自动生成企业合规文档
Reddit 开发者分享 Agentic Paper Bomb 实验:让五个 AI 智能体扮演高管角色,自动生成企业合规、安全、DevOps 等文档。探讨多智能体协作生成文档的潜力与隐忧。

《Rob Roy》经典台词解析:领导者的代价与生存抉择
解析《Rob Roy》中Rob Roy与Sibbald的经典对峙台词,探讨领导力的代价、生存与尊严的权衡,以及权力博弈背后的人性洞察。

黄仁勋被曝聘请擅长处理丑闻的公关公司
据 Wired 报道,黄仁勋在《纽约时报》报道其妻子商业往来后,聘请了一家曾处理高知名度性丑闻的公关公司。本文分析这一举动背后的危机管理信号及其对英伟达声誉的影响。