正字法深度如何量化?两种粒度下的拼读不确定性研究
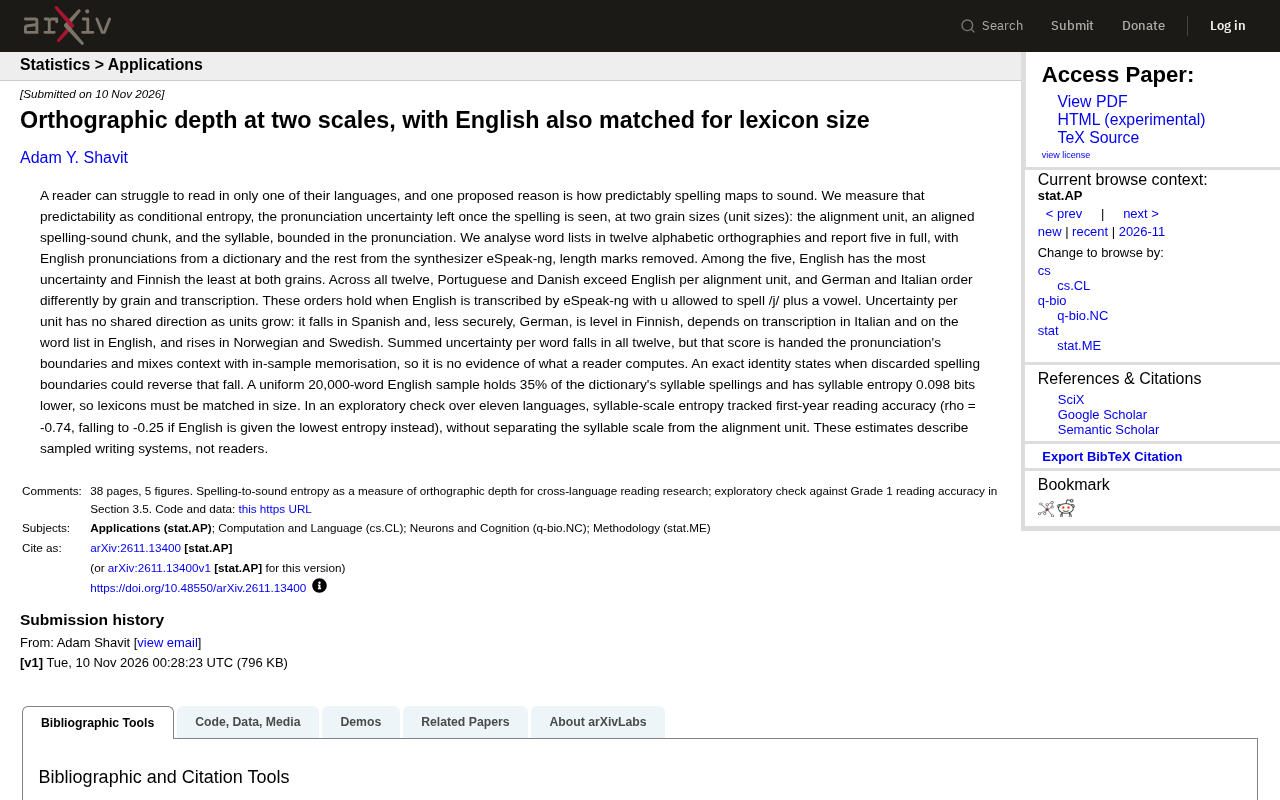
研究用条件熵量化十二种字母文字的拼写-读音不确定性,揭示粒度、词表与转写方式对正字法深度排序的影响。
该研究用条件熵精确刻画拼写与读音之间的剩余不确定性,在十二种字母文字的词表上测量了两种粒度——对齐单元与音节——下的正字法深度。结果显示,单位变大时每单位不确定性没有统一变化方向:西班牙语和德语下降、芬兰语持平、挪威语和瑞典语上升。在五种详析语言中,英语不确定性最高、芬兰语最低;更广比较中葡萄牙语和丹麦语按对齐单元超过英语。研究特别警示词表规模会系统性影响熵值估计,两万词英语样本仅覆盖词典音节拼写的35%。作者还区分了累积不确定性与读者实际计算过程,并将音节熵与阅读准确率的负相关定位为探索性结果。
拼写与读音的可预测性:一个被量化的难题
一个人可能只在自己的一种语言里阅读困难,这背后的一个常见解释是拼写与读音之间的映射是否足够可预测。但“可预测”本身是一个模糊的表述——它究竟指什么?又该如何测量?
一项新研究试图用条件熵(conditional entropy)来精确刻画这种不确定性:在看到拼写之后,读音还剩多少不确定。研究分析了十二种字母文字的词表,并详细报告了其中五种。这一框架把“正字法深度”从一个直觉概念变成了可比较的数值。
条件熵是信息论中刻画不确定性的核心工具。给定随机变量 X(此处为拼写),条件熵 H(Y|X) 衡量在已知 X 后,Y(此处为读音)剩余的平均不确定性,单位为比特。若拼写完全决定读音,条件熵为零;若两者独立,条件熵等于读音本身的熵。在正字法深度研究中,条件熵的优势在于它不依赖具体的规则列表,而是直接从词表统计中估计,因而可跨语言比较。但估计值受样本规模、转写一致性和对齐方式影响,这正是该研究反复强调方法学变量的原因。
两种粒度:对齐单元与音节
研究的关键设计在于同时测量两种粒度下的不确定性。第一种是对齐单元(alignment unit),即拼写与读音对齐后的片段;第二种是音节(syllable),以读音中的音节边界为界。
这两种粒度的选择并非无关紧要。据研究结果,当单位变大时,每单位的不确定性并没有统一的变化方向:在西班牙语中下降,在德语中也有下降但证据较弱,在芬兰语中基本持平,在意大利语中取决于转写方式,在英语中取决于词表,而在挪威语和瑞典语中反而上升。这意味着“正字法深度”不能简单归结为一个单一尺度上的排序。
正字法深度(orthographic depth)传统上指拼写与读音映射的透明程度:透明正字法(如芬兰语、意大利语)中字母与音素对应规则性强,深度正字法(如英语、丹麦语)中同一字母组合可有多种读音。以往研究常以规则覆盖率或一致性评分来操作化这一概念,但不同评分体系之间难以直接比较。该研究改用条件熵,将“深度”重新定义为在给定拼写下读音的平均剩余不确定性,使不同语言、不同粒度下的估计值落在同一标尺上,同时保留了“深度”本身的多维性。
五语言详析:英语不确定性最高,芬兰语最低
在完整报告的五种语言中,英语在两种粒度上的不确定性都是最高的,芬兰语则是最低的。这一结果与英语拼写系统历来被认为不规则的直觉一致,但研究用熵值给出了可复现的度量。
更广的十二语言比较揭示了更复杂的图景。按对齐单元计算,葡萄牙语和丹麦语的不确定性超过英语;而德语和意大利语的排序会随粒度和转写方式而改变。研究还验证了这些排序在英语改用 eSpeak-ng 合成器转写、并允许 u 拼写 /j/ 加元音的条件下依然成立。
数据来源上,英语读音取自词典,其余语言由 eSpeak-ng 合成,并去除了长度标记。这一处理方式本身也构成一个方法学上的变量——转写来源不同可能影响熵值估计。
词表大小必须匹配:一个容易被忽略的偏倚
研究特别指出,一个均匀抽取的两万词英语样本只覆盖了词典中音节拼写的 35%,且音节熵比完整词典低 0.098 比特。这说明词表规模会系统性影响熵值估计,因此跨语言比较时词典大小必须匹配。
这一发现对以往的正字法深度研究提出了方法学警示:如果不同语言的词表规模不一致,排序结果可能部分来自采样差异而非文字系统本身。
采样偏倚在熵估计中表现为:词表越小,观察到的拼写-读音组合越不完整,稀有映射被系统性遗漏,导致条件熵被低估。该研究用两万词英语样本与完整词典对比,发现前者仅覆盖35%的音节拼写,音节熵低0.098比特。这意味着若两种语言使用不同规模的词表,熵值差异可能部分来自覆盖度而非文字系统本身。匹配词表规模或在完整词典上计算,是跨语言比较获得可靠排序的前提条件。
累积不确定性与读者实际计算的区别
研究还计算了每个词的累积不确定性,并发现它在全部十二种语言中都随单位增大而下降。但作者明确警告,这个指标并不能作为读者实际计算过程的证据:它被直接赋予了读音的边界信息,混合了上下文与样本内记忆,而且当被丢弃的拼写边界重新引入时,这种下降可能被逆转。研究给出了一个精确的恒等式来描述这种反转条件。
这层区分很重要——测量文字系统的统计结构,与测量人脑在阅读时计算什么,是两个不同的问题。作者在结论中强调,这些估计描述的是被采样的书写系统,而非读者。
累积不确定性指读者从左到右逐单位阅读时,每遇到一个新单位所新增的不确定性之和。该指标在十二种语言中均随单位增大而下降,看似符合“上下文减少不确定性”的直觉。但作者指出,这一计算直接使用了读音的边界信息,相当于把读者在真实阅读中需要自行推断的结构预先赋予模型;同时它混合了上下文约束与样本内记忆效应。当被丢弃的拼写边界重新引入时,下降趋势可能反转,研究给出了描述该反转条件的恒等式。因此,累积不确定性描述的是书写系统的统计结构,而非人脑阅读时的实际计算过程。
探索性检验:音节熵与阅读准确率的关联
在一项覆盖十一种语言的探索性检验中,音节尺度的熵与一年级阅读准确率呈现负相关(rho = -0.74)。但如果把英语设为最低熵,相关系数会降到 -0.25,说明这一关联对个别数据点敏感。此外,该检验未能把音节尺度与对齐单元的影响分离开来。
作者对此保持谨慎,将其定位为探索性结果,而非因果关系证据。
方法学启示
这项工作的价值不仅在于给出了一套可比较的熵值,更在于它把正字法深度研究中若干隐含假设摆上了台面:粒度选择、转写来源、词表规模、以及统计指标与认知过程之间的鸿沟。对于关注阅读习得与文字系统比较的研究者,这些变量都需要在设计阶段被明确处理。
相关推荐
美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。