智能体AI的验证与自我改进:理论边界在哪里?

论文用计算复杂度框架拆解智能体AI的自我改进声明,证明性能提升不等于能力突破。
这篇arXiv论文从计算复杂度理论出发,为智能体AI的"自我改进"声明建立严谨的验证框架。论文核心主张是:性能分数无法区分改进来源——更长搜索时间、外部工具支持、还是真正的能力边界扩展,必须通过"有界验证"模型将三者分离。论文证明独立多数放大能保持系统能力边界,而"存在性接受"机制则可能系统性地放行错误输出;随机验证器类被夹在相邻两层多项式层级之间,但严格分离需依赖未解决的复杂度假设。最具现实意义的结论是:在固定验证协议下,递归自我修改不能突破系统所在的验证复杂度类,为"AI无限自我进化"的乐观叙事划出了明确的理论边界。整个框架将自我改进声明锚定到正确性、证据、验证资源与选择误差四类可审计义务,为未来的评测标准提供了数学语言。
当智能体AI宣称自己变强了,我们该如何验证?
智能体AI(Agentic AI)系统正在以多种方式"进化":有的通过延长搜索时间,有的通过获得额外的外部支持,还有的则直接修改自己提出和验证输出的方式。问题在于,仅凭一个性能分数,我们根本无法分辨这些改进究竟来自哪种机制——分数高了,但到底是因为算得更久、靠外援、还是真正"学会"了,这是一个被长期忽视的盲区。
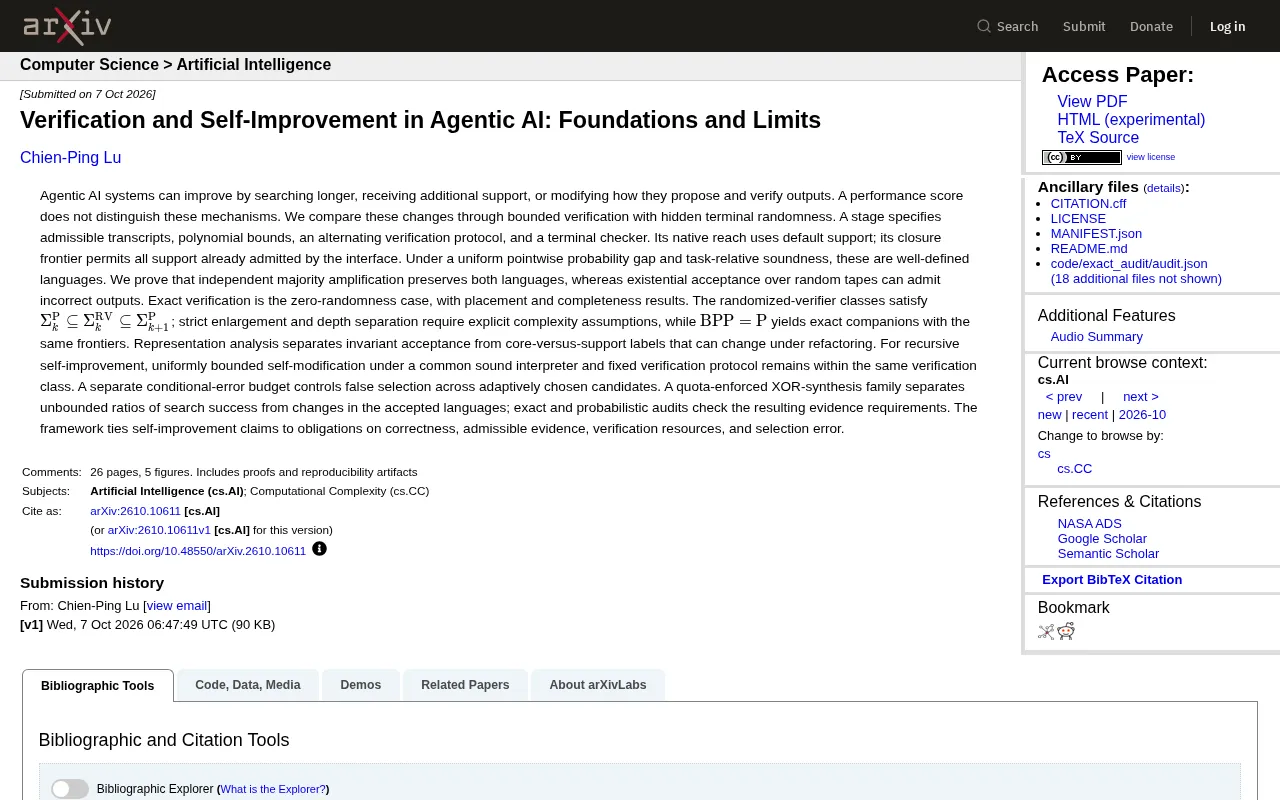
arXiv 上一篇题为《Verification and Self-Improvement in Agentic AI: Foundations and Limits》的新论文,正是试图从计算复杂度理论的角度,为这类自我改进的声明建立一套严谨的分析框架。它的核心主张非常直接:性能提升不等于能力提升,必须把每一类改进机制拆开来看,并为其配上明确的"验证义务"。
用"有界验证"重新定义改进
论文提出了一个被称为"有界验证"(bounded verification)的分析模型,其中引入了隐藏的终端随机性(hidden terminal randomness)。在这个框架里,一个"阶段"(stage)由几个要素共同定义:允许的交互记录(admissible transcripts)、多项式级别的资源边界、一个交替式的验证协议,以及一个终端校验器(terminal checker)。
这里有两个关键概念值得区分。一个是系统的"原生可达范围"(native reach),即在默认支持下能够达到的能力;另一个是"闭包前沿"(closure frontier),指接口已经允许的所有支持被动用后所能触及的边界。换句话说,前者是"自己能做到什么",后者是"借助所有合法外援能做到什么"。在统一的逐点概率间隙(uniform pointwise probability gap)和任务相对可靠性(task-relative soundness)假设下,这两者都能被定义为良定义的语言(well-defined languages)。
这种区分的意义在于:它把"模型自身的能力"和"系统整体依赖外部资源达成的表现"从数学上分离开来,避免了把借来的能力误记在模型头上。
**多项式层级(Polynomial Hierarchy)**是计算复杂度理论中的一个核心概念,可以理解为对经典 NP/co-NP 的逐层推广。第一层 Σ₁ᴾ 就是 NP——问题的答案可以在多项式时间内被"猜出并验证";第二层 Σ₂ᴾ 则允许在猜测之上再嵌套一层全称量词,以此类推。论文引入这套层级体系,是为了精确衡量不同验证机制究竟"消耗"了多少计算复杂度资源。**交替式协议(alternating protocol)**指验证过程在"存在性步骤"(找一个证据)和"全称性步骤"(对所有反例成立)之间交替进行,这正是多项式层级的计算模型基础。理解这一背景,有助于把握论文后续关于随机验证器类夹逼结果的含义:随机性的引入,使得验证能力介于相邻两个确定性层级之间,而非跨越整个层级。
多数投票可靠,但"存在性接受"会出错
论文中一个相当有启发性的结论,是对两种常见验证放大机制的对比。
第一种是独立多数放大(independent majority amplification),也就是通过多次独立采样、取多数结果来提升可靠性。论文证明,这种方式能够同时保持原生可达范围和闭包前沿两个语言——即它不会改变系统真正的能力边界,只是让结果更稳定。
第二种是对随机带的存在性接受(existential acceptance over random tapes),即只要存在某条随机路径能让输出被接受就算通过。论文指出,这种机制可能会接受错误的输出。这是一个重要警示:很多看似"只要试够多次就能成功"的智能体策略,实际上存在系统性地放行错误答案的风险。
作为零随机性的特例,精确验证(exact verification)对应确定性校验,论文为其给出了相应的位置(placement)和完备性(completeness)结果。
随机验证器与复杂度类的层级关系
在复杂度理论层面,论文给出了随机验证器类(randomized-verifier classes)与经典多项式层级之间的夹逼关系:
$$\Sigma_k^{\mathrm{P}}\subseteq\Sigma_k^{\mathrm{RV}}\subseteq\Sigma_{k+1}^{\mathrm{P}}$$
这个结果说明随机验证器类被稳稳夹在相邻两层多项式层级之间。但论文坦诚地指出,要证明"严格扩大"(strict enlargement)或"深度分离"(depth separation),需要引入明确的复杂度假设——这是复杂度理论中的一贯难题。而在 BPP=P 的假设下,这些随机类会退化出具有相同前沿的精确对应物。
换言之,随机性是否真的带来了额外能力,取决于那些尚未解决的开放性复杂度猜想。这是一种诚实的学术态度:框架能告诉你"如果某假设成立会怎样",但不会越界下无条件的强结论。
**BPP(Bounded-error Probabilistic Polynomial time)**是复杂度理论中描述"高效随机算法"的标准类:一个问题属于 BPP,意味着存在多项式时间的随机算法,对正确答案给出错误结论的概率不超过 1/3。长期以来,学界普遍猜测 BPP = P(即随机性并不提供真正超越确定性算法的额外能力),但这一猜想至今未被证明。论文提到"在 BPP=P 假设下随机类退化为精确对应物",正是基于这一猜想:若随机性对多项式时间计算没有本质帮助,则随机验证器的额外能力也将消失,整个框架中依赖随机性的能力提升就会"归零"。这说明论文的部分结论在强度上存在条件依赖,并非无条件成立的定理,这在复杂度理论领域是诚实且标准的表述方式。
递归自我改进的边界:改来改去,还在同一个类里
论文最切中智能体AI热点的部分,是关于递归自我改进(recursive self-improvement)的分析。
结论颇具"降温"意味:在一个共同的可靠解释器(sound interpreter)和固定验证协议下,经过统一有界的自我修改,系统仍然停留在同一个验证类之内。也就是说,单纯让智能体不断修改自身代码,并不能自动突破其验证能力的根本边界——这为那些关于"AI会无限自我进化"的乐观叙事划出了一条清晰的理论红线。
此外,论文还引入了一个独立的条件错误预算(conditional-error budget),用来控制在自适应选择候选方案过程中的误选率。它还构造了一个配额强制的 XOR 合成族(quota-enforced XOR-synthesis family),用以把"搜索成功率的无界比例提升"与"被接受语言的真实变化"区分开来——再次强调搜索更努力不等于能力真的变强。
递归自我改进(Recursive Self-Improvement,RSI)在 AI 安全与能力研究领域有着特殊地位:它是"智能爆炸"假说的核心机制——若一个系统能改进自身,改进后的版本又能更高效地改进下一代,则能力可能以超线性速度增长,最终超出人类控制。论文对此给出的理论刹车是:在固定验证协议和可靠解释器的约束下,自我修改产生的系统仍属于同一验证复杂度类。这里"可靠解释器"的含义是:执行修改后代码的运行环境本身不会引入新的计算能力(例如不能偷偷调用超出预算的资源)。这一结论并非否定自我改进的工程价值,而是在说:验证能力的边界不会因代码层面的自我修改而自动突破,想要真正提升可验证能力,必须从根本上改变验证协议本身,而非仅靠代码迭代。
表示分析:重构会改变"核心"与"支持"的标签
论文还做了一项"表示分析"(representation analysis),将不变的接受行为(invariant acceptance)与"核心-支持"标签(core-versus-support labels)区分开来。后者在系统重构(refactoring)时可能发生变化。这意味着,当我们重新组织一个智能体系统的内部结构时,哪些部分算"核心能力"、哪些算"外部支持"可能随之改变,但系统实际接受什么、拒绝什么的行为应保持不变。这对评估"改进"的真实性提供了另一个检验维度。
这项研究的价值与局限
这篇论文的核心贡献,是把智能体AI模糊的"自我改进"声明,锚定到了四类可审计的义务上:正确性、可接受的证据、验证资源、选择误差。它提供了精确和概率两种审计方式来核查由此产生的证据要求。
对行业而言,这是一剂清醒剂。当越来越多的产品宣称其智能体"能自我优化"时,这套框架提醒我们追问:提升到底来自哪里?是靠更多算力和搜索,还是靠外部工具,抑或真正改变了可验证的能力边界?
需要说明的是,这是一篇高度理论化的工作,结论严重依赖复杂度假设,离工程实践尚有距离。它更像是为未来的评测标准和能力声明提供数学语言,而非可直接落地的工具。但在智能体AI叙事普遍乐观、度量普遍粗糙的当下,这种对"验证边界"的较真,恰恰是稀缺的。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。