置信度更准,知识图谱审计为何仍难改进?

研究揭示更准的置信度未必显著提升知识图谱审计效果,错误结构和标签质量才是关键。
该研究探讨了LLM构建知识图谱时置信度估计与人工审计效率之间的关系。通过将非自适应审计建模为预算约束下的覆盖问题,作者发现置信度提升带来的审计增益受限于错误的结构性分布,尤其是错误可修复性和标签有效性。实验在Re-DocRED上模拟理想修复,结果显示在跨文档图上简单错误率×扇出队列比联合模型多留3.98-4.74个百分点错误,而开放共享动作可使联合规划器残余错误减少0.89-1.43个百分点。通用LLM验证在多数配置下提升表现,并能识别基准遗漏。研究结论是:更好的置信度是必要非充分条件,审计系统的结构设计、错误可修复性和标签质量共同决定最终收益。
在LLM构建知识图谱的流程中,置信度估计常被用来指导人工复核。直觉上,更准的置信度应该直接提升审计效率。但一项研究指出,这种改进可能远小于预期——即便错误预测更准确,审计效果也未必显著提升。该研究通过可修复性、选择余量和标签有效性三个概念,揭示了置信度与审计收益之间的鸿沟。
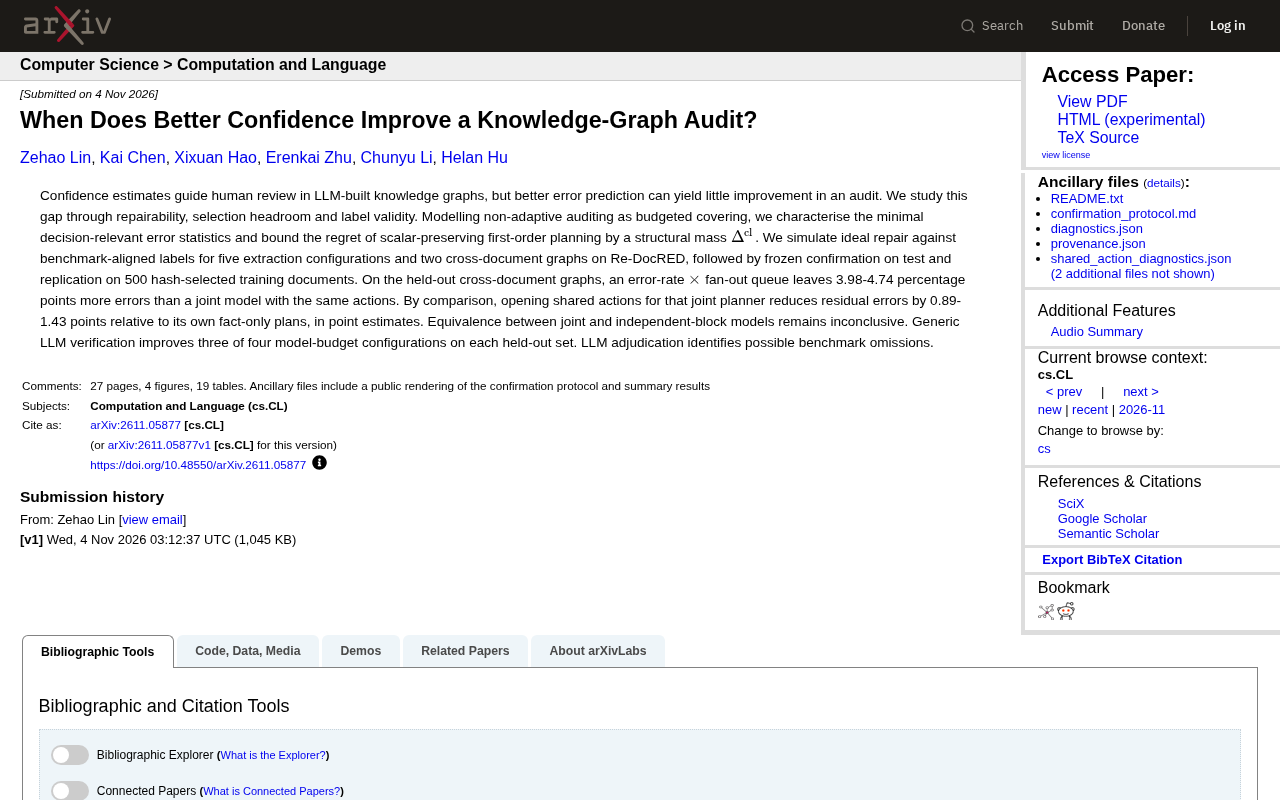
审计为何不随置信度线性提升
研究将非自适应审计建模为预算约束下的覆盖问题,刻画了决策相关的最小错误统计量。核心发现是:置信度提升带来的审计增益,受限于错误的结构性分布。也就是说,如果错误集中在难以修复或标签本身存疑的样本上,更准的置信度也难以转化为审计效果的提升。
作者进一步用“标量保持的一阶规划”来近似审计策略,并用结构质量Δ^cl来界定其遗憾界。这解释了为什么简单的错误率×扇出队列与联合模型在相同动作下,残余错误差异可达3.98-4.74个百分点(在留出的跨文档图上)。
非自适应审计指审计策略在获得置信度分数后一次性确定,不根据审计过程中新发现的信息动态调整后续选择。与之相对,自适应审计会在每次检查后更新对剩余错误的估计,从而可能调整后续的审计顺序。非自适应审计更易于实现和评估,但可能无法充分利用审计过程中逐步揭示的信息。
预算约束下的覆盖问题是组合优化中的经典问题:在给定总预算(如最多检查多少个事实)下,选择一组动作以最大化覆盖的错误数量或最小化残余错误。在这里,每个候选事实对应一个可能的修复动作,审计员需在有限预算内选择动作子集,使最终残留的错误最少。该建模方式将审计视为集合覆盖的变体,从而可以借用近似算法和遗憾界分析工具。
实验设计与关键数据
研究在Re-DocRED上模拟了理想修复,针对五种提取配置和两个跨文档图,随后在测试集上冻结确认,并在500个哈希选择的训练文档上复现。结果显示:
- 在留出的跨文档图上,错误率×扇出队列比联合模型多留下3.98-4.74个百分点的错误。
- 为联合规划器开放共享动作后,相对于其仅事实计划,残余错误在点估计上减少0.89-1.43个百分点。
- 联合模型与独立块模型之间的等价性仍无定论。
这些数字表明,审计策略的结构(是否允许共享动作)比单纯提升置信度精度更能影响最终错误率。
Re-DocRED是文档级关系抽取的基准数据集,由DocRED扩展而来,通过人工复核修正了原数据集中的部分标注错误,提供了更可靠的实体和关系标签。该数据集常用于评估文档级信息抽取模型,尤其适合研究标注噪声和审计策略,因为其修正后的标签可以作为相对干净的“金标准”来模拟修复过程。
跨文档图指将多个文档中的实体和关系通过共指消解或实体链接连接起来形成的全局知识图谱。与单文档图相比,跨文档图涉及更复杂的实体消歧和关系推理,错误传播范围更广,审计动作可能需要跨文档协调。本文在跨文档图上评估审计策略,正是为了检验错误结构性分布对审计收益的影响。
可修复性与标签有效性的角色
研究强调,审计收益取决于错误是否可修复以及标签是否有效。如果错误源于提取配置的系统性偏差,或者基准标签本身存在遗漏,那么置信度再准也无法引导审计员找到真正可修复的错误。作者提到,通用LLM验证在四个模型-预算配置中的三个上提升了留出集表现,而LLM裁决还识别出可能的基准遗漏——这暗示部分“错误”可能其实是标签问题。
这一视角将审计从“排序问题”扩展为“结构问题”:需要同时考虑错误的可修复性和标签的可靠性。
一阶规划(first-order planning)在此处指一种近似审计策略的优化方法:将审计动作的选择建模为一阶(线性)规划问题,并通过保持标量目标(如残余错误数)来简化求解。作者用“标量保持的一阶规划”近似原问题,是为了在可计算的前提下推导审计策略的遗憾界——即该近似策略与最优策略之间的性能差距上界。遗憾界用结构质量Δ^cl来界定,反映了错误分布的结构(如可修复性、标签有效性)如何限制近似策略的最优性。这一分析工具解释了为什么单纯提升置信度精度无法突破结构性限制。
对知识图谱审计实践的启示
对于构建知识图谱的团队,这项研究提示:不要盲目追求置信度模型的精度提升,而应关注审计动作的设计。例如,允许联合规划器共享动作(如同时修正实体和关系)比单纯优化置信度排序更能减少残余错误。此外,引入LLM验证和裁决可以帮助发现基准遗漏,但需注意其在不同配置下的效果差异。
研究也留下开放问题:联合模型与独立块模型的等价性尚未结论,跨文档图的审计策略仍需进一步探索。
总之,更好的置信度是必要非充分条件。审计系统的结构设计、错误可修复性和标签质量共同决定了最终收益。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。