自编码器替代注意力:更省算力的掩码语言模型新架构
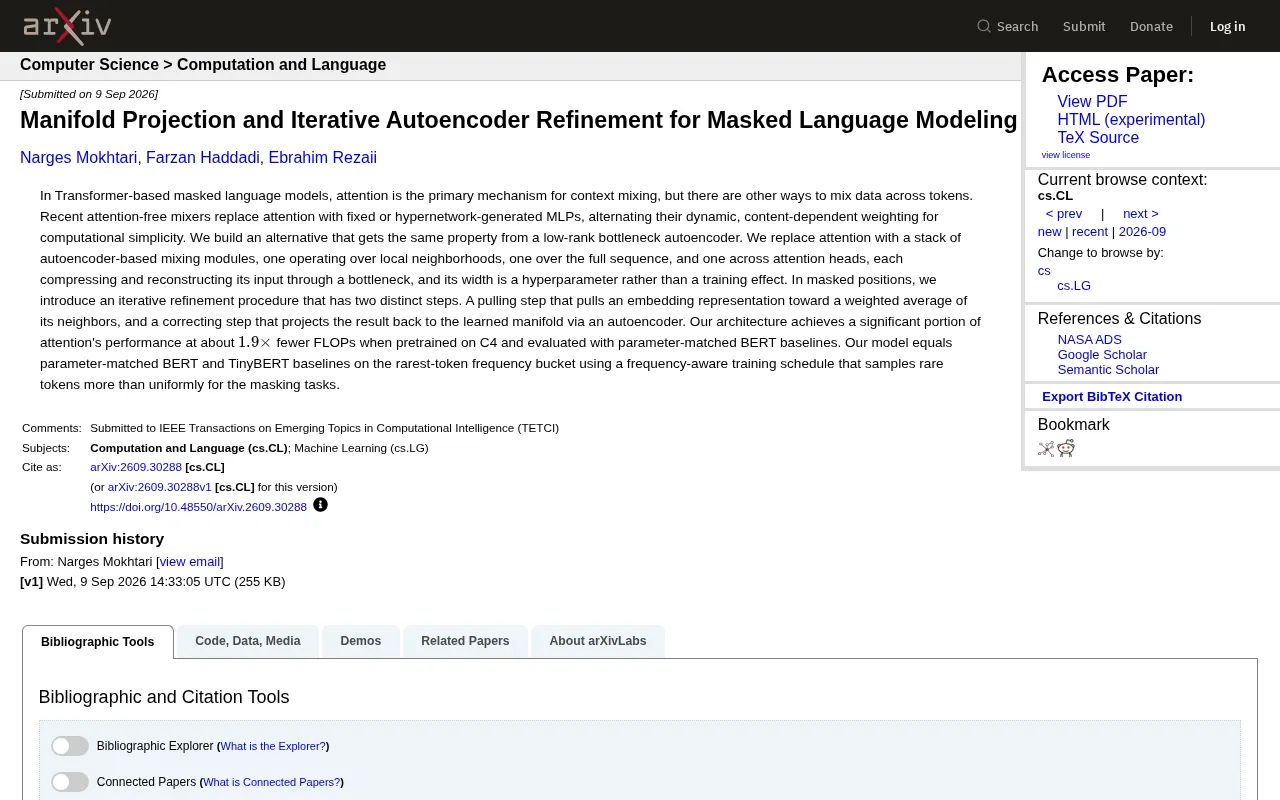
用低秩瓶颈自编码器替代注意力,配合迭代流形精修,以1.9倍FLOPs优势逼近BERT的掩码语言建模性能。
这篇论文提出用低秩瓶颈自编码器模块替代Transformer中的注意力机制,在掩码语言模型任务上实现高效的跨词元信息混合。混合模块分为局部邻域、全序列、跨注意力头三个层次,瓶颈宽度作为可显式控制的超参数,使模型容量更易调节。针对被掩码位置,论文还设计了"拉取—纠正"迭代精修流程:先将掩码词元的嵌入朝邻居方向拉动,再通过自编码器投影回学习到的语义流形,循环迭代以逐步逼近真实分布。在C4数据集上的实验表明,该架构FLOPs减少约1.9倍,整体性能接近参数匹配的BERT;结合频率感知训练调度后,在最稀有词频区间可追平BERT与TinyBERT。这为关注推理效率和边缘部署的场景提供了一个值得跟进的无注意力架构方向,但作为预印本,结论仍需更大规模验证。
背景:注意力之外的上下文混合
在基于 Transformer 的掩码语言模型(Masked Language Model, MLM)中,注意力机制一直是跨词元(token)混合信息的核心手段。但注意力并非唯一选择。近年来,一批"无注意力混合器"(attention-free mixers)尝试用固定或超网络生成的 MLP 来替代注意力,以换取计算上的简洁性——它们通过交替使用动态的、内容相关的加权方式来近似注意力的行为。
这篇 arXiv 新论文(arXiv:2609.30288)提出了另一条路径:用一个低秩瓶颈自编码器(low-rank bottleneck autoencoder)来获得与注意力类似的上下文混合能力,同时显著降低计算开销。
核心方法:三层自编码器混合模块
研究者把注意力替换为一组基于自编码器的混合模块,每个模块都通过瓶颈结构对输入进行压缩与重建。整个混合过程被拆解为三个作用范围不同的层次:
- 局部邻域混合:在词元的局部邻居范围内进行信息交换;
- 全序列混合:覆盖整条输入序列的信息流动;
- 跨注意力头混合:在不同注意力头之间进行融合。
这种设计的一个关键区别在于,瓶颈的宽度是一个可显式设定的超参数,而不是像注意力那样在训练过程中隐式形成的结果。这让模型的容量控制更加直接和可解释。
为什么用瓶颈自编码器
自编码器的压缩—重建过程天然带有信息筛选的效果。低秩瓶颈迫使模型在有限维度内保留最有用的上下文信息,从而在功能上逼近注意力"内容相关加权"的特性,却省去了注意力矩阵所需的二次方级计算。
从线性代数的角度理解"低秩":若将序列中所有词元的隐藏状态拼成一个矩阵,标准注意力实质上是对这个矩阵做了一次数据相关的全秩变换,计算量随序列长度平方增长。低秩瓶颈则强制把这个变换分解为"先压缩到 r 维、再展开"的两步,其中 r 远小于原始隐藏维度。这与矩阵分解中的奇异值截断思想一脉相承:只保留最大的 r 个奇异值对应的方向,丢弃噪声成分。不同的是,这里的"压缩—展开"参数是端到端学习的,而非事后截断。这也意味着模型被迫学会哪些跨词元的依赖关系真正重要,从而在更低维度的瓶颈空间内形成紧凑的上下文表示。与标准自编码器去噪目标不同,此处瓶颈的主要作用是维度控制而非重建保真,因此瓶颈宽度 r 直接决定了混合器能传递的跨词元信息量上限,成为精确调节模型容量的旋钮。
迭代式流形精修:Pull 与 Correct
论文最具特色的部分,是针对被掩码(masked)位置设计的迭代精修流程。它由两个交替进行的步骤组成:
- 拉取步骤(Pulling step):把某个嵌入表示朝向其邻居的加权平均方向拉动,让被掩码位置逐渐吸收周围上下文的信息。
- 纠正步骤(Correcting step):通过自编码器把拉取后的结果投影回学习到的流形(learned manifold)上,纠正拉取过程可能引入的偏离。
这一"拉取—纠正"的循环,本质上是在语义流形上做迭代式的位置修复。相比一次性预测,它给了模型逐步逼近真实分布的机会,这也是标题中"Manifold Projection"(流形投影)与"Iterative Autoencoder Refinement"(迭代自编码器精修)的由来。
流形(manifold)在这里指的是模型在高维嵌入空间中学到的一个低维曲面:所有"合理"的词元表示并不均匀分布在整个空间,而是聚集在这张曲面附近。这一假设来自经典的流形假设(manifold hypothesis),在图像、语音和 NLP 的表示学习中均有广泛佐证。
被掩码的位置在初始化时往往落在流形之外(因为它的真实语义未知),Pull 步骤通过邻居加权平均把它"拉向"可能正确的区域,但线性插值不保证结果仍在流形上——就像把两张人脸图像做像素均值,结果往往出现鬼影。Correct 步骤用自编码器把偏离的点重新投影回流形,类似于在曲面上找最近点。两步交替迭代,相当于沿流形表面做梯度下降式的位置修复,而非在平坦欧氏空间中一步到位。这种设计与扩散模型的去噪迭代、以及 MCTS 中的"模拟—修正"循环在哲学上高度相似:用多步粗精交替替代单步精确预测,以计算换质量。
实验结果:更少 FLOPs,接近 BERT 表现
在 C4 数据集上预训练、并与参数量匹配的 BERT 基线对比后,该架构展现出明确的效率优势:
- 在实现注意力"相当一部分"性能的前提下,FLOPs 减少约 1.9 倍;
- 采用一种频率感知的训练调度(frequency-aware training schedule)——即在掩码任务中对稀有词元的采样高于均匀采样——后,模型在最稀有词频区间上追平了参数量匹配的 BERT 与 TinyBERT 基线。
稀有词往往是语言模型的短板,能在这一区间与 BERT/TinyBERT 打平,说明该方法并非只在常见词上取巧,而是在长尾分布上也具备竞争力。
频率感知训练调度(frequency-aware training schedule)的动机来自语言的长尾分布:自然语言中词频遵循齐普夫定律(Zipf's law),少数高频词占据了绝大多数词元出现次数,而大量低频词(稀有词)却携带着丰富的语义信息。标准均匀掩码策略会让模型在高频词上获得大量梯度信号,对稀有词的学习严重不足。频率感知调度通过提升稀有词被选为掩码目标的概率,人为补偿这种分布偏斜,类似于分类任务中的过采样少数类。这一调整不增加模型参数,也不改变推理阶段的计算量,属于纯训练侧的低成本改进。其效果在最稀有词频区间最为显著——恰好是标准 BERT 训练的盲区——这也解释了为何在该区间能追平甚至持平于更强基线,而整体指标上仍有差距。
意义与展望
这项工作延续了近年来"重新审视注意力是否不可替代"的研究脉络。它给出的答案是:通过精心设计的低秩自编码器混合模块,加上流形上的迭代精修,可以在显著降低算力的同时保留掩码语言建模的大部分能力。
对于关注推理成本、边缘部署或大规模预训练效率的团队来说,这类无注意力(或弱注意力)架构提供了一个值得跟进的方向。当然,作为一篇新发布的预印本,其结论仍需更大规模、更多任务的验证——"相当一部分性能"与"完全对等"之间仍有距离。但其在效率与稀有词表现上的权衡思路,颇具启发性。
注:本文基于 arXiv 预印本摘要整理,具体实现细节与完整评测请参阅原始论文。
相关推荐
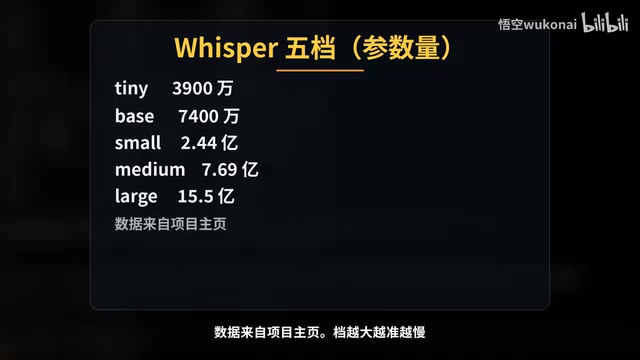
Claude Code实战:零代码搭建切片工厂,长视频自动变竖屏短视频
B站UP主悟空用Claude Code零代码搭建切片工厂,将35分钟长视频自动切成10条竖屏短视频。从Plan Mode、Whisper转写、claude.md规则、Hook质检到Subagent审核和Plugin分发,完整实战流程与实测数据。
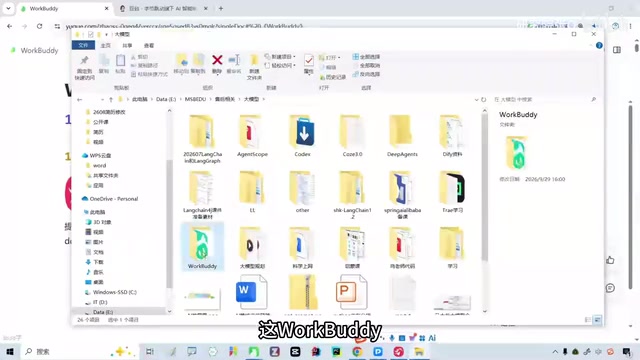
WorkBuddy保姆级教程:AI Agent如何帮你自动转文件
WorkBuddy保姆级教程实战:从豆包只能给方案到AI Agent直接动手,三分钟批量转换PDF并归档。含安装、积分机制、与Codex对比及上手建议。
零基础入门Java+DeepSeek实战:程序员转型AI大模型开发指南
本文基于B站直播教学,详解Java程序员如何零基础转型AI大模型开发,涵盖技能路径、实战构建第一个Java AI应用、简历包装与求职策略,助你抓住大模型时代机遇。