自发现强化学习揭秘:学习历史是资产还是负担?

首次对自发现强化学习规则Disco103实施因果机制审计,揭示学习历史的真实作用边界。
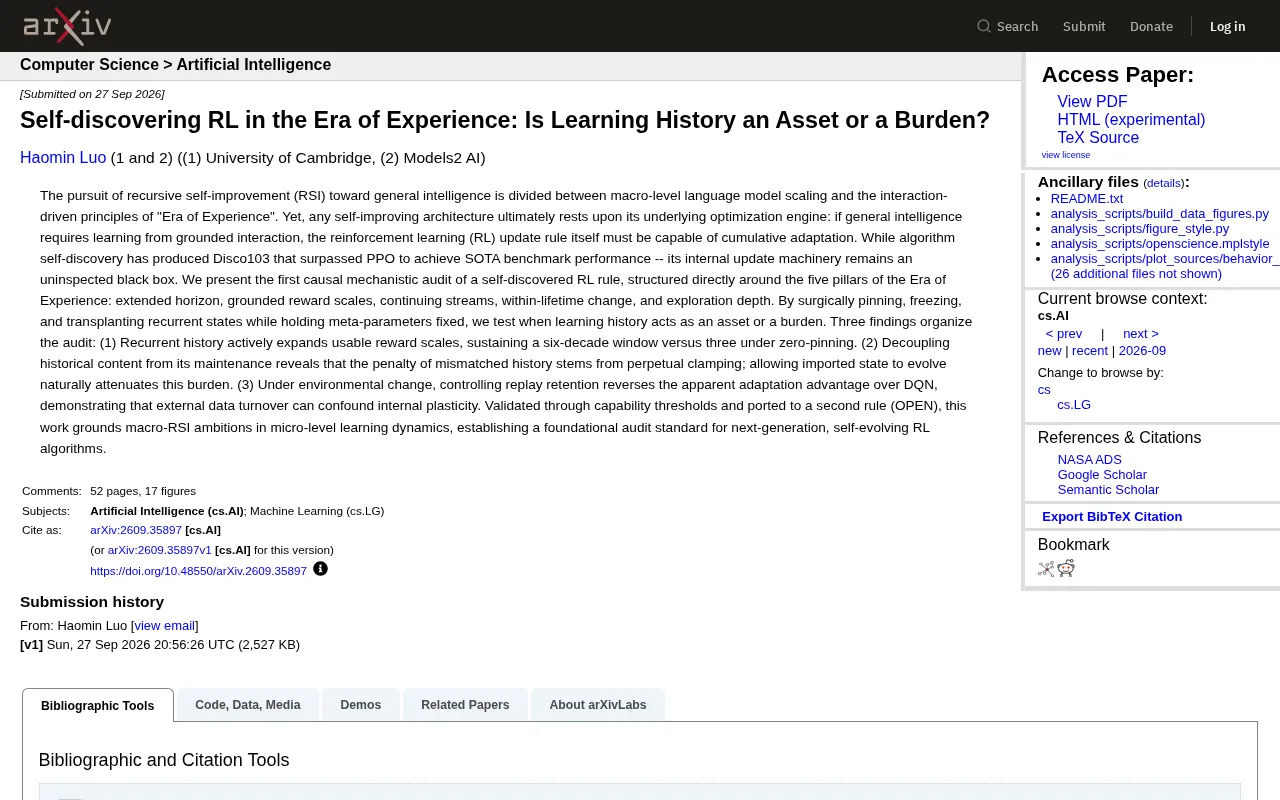
这篇arXiv论文对自发现强化学习规则Disco103进行了首次因果机制审计,系统检验了循环学习历史在"经验时代"五大支柱下的作用。研究采用"钉住""冻结""移植"循环状态的外科手术式干预方法,得出三项核心发现:循环历史可将可用奖励尺度从三个数量级扩展至六个数量级;不匹配历史的性能惩罚来源于"永久钳制"而非历史内容本身;在非平稳环境中,自发现规则对DQN的表观适应优势可被回放保留机制解释,未必反映真实的内部可塑性。上述发现在第二个自发现规则OPEN上得到复现,论文由此呼吁为下一代自进化RL算法建立标准化审计框架,将宏观的递归自我改进雄心锚定于微观学习动力学的可靠理解之上。
递归自我改进(RSI)通往通用智能的道路,长期分裂为两条路线:一条是宏观层面的语言模型规模化扩张,另一条是"经验时代"(Era of Experience)所主张的交互驱动原则。但无论采用哪种架构,任何能够自我改进的系统最终都建立在其底层的优化引擎之上。这篇新发布的arXiv论文(arXiv:2609.35897v1)提出了一个尖锐的问题:如果通用智能真的需要从有据可循的交互中学习,那么强化学习(RL)的更新规则本身,是否具备累积式适应的能力?
从"黑箱"算法到机制审计
算法自发现(algorithm self-discovery)近年取得了显著进展,其中代表性成果Disco103已经超越了经典的PPO,在多个基准测试中达到了SOTA性能。然而,研究者指出一个被长期忽视的问题:这些自发现规则的内部更新机制,至今仍是一个未经检验的黑箱。我们知道它有效,却不知道它为什么有效、在什么条件下会失效。
这篇论文的贡献在于,提供了对自发现RL规则的首次因果机制审计(causal mechanistic audit)。研究框架直接围绕"经验时代"的五大支柱展开:延展的时间视野(extended horizon)、有据可循的奖励尺度(grounded reward scales)、持续的数据流(continuing streams)、生命周期内的变化(within-lifetime change),以及探索深度(exploration depth)。
算法自发现(Algorithm Self-Discovery)是元学习的一个分支,其核心思想是让优化算法本身成为被学习的对象——系统通过与环境的交互,自动搜索并生成比人工设计更高效的更新规则。Disco103即是这一方向的代表性成果,它通过进化搜索或梯度元学习,在大量任务上发现了一套通用的参数更新公式,其性能在多个标准强化学习基准上超越了近端策略优化(PPO)。PPO是目前工业界与学术界最广泛使用的策略梯度算法,以其训练稳定性著称,因此Disco103的超越具有重要基准意义。自发现算法的优势在于摆脱了人类归纳偏置的约束,但这也意味着其内部逻辑对研究者而言近乎不透明——算法"知道该怎么做",但没有人知道"它在做什么",这正是因果机制审计的出发点。
核心方法:外科手术式的状态干预
这项研究最具特色的地方在于其实验方法。研究者通过"钉住"(pinning)、"冻结"(freezing)和"移植"(transplanting)循环状态(recurrent states),同时保持元参数(meta-parameters)固定,从而精确测试学习历史在何时充当资产、何时又变成负担。
这种"外科手术式"的干预方式,本质上是一种因果推断实验设计。相比于单纯观察算法的输入输出表现,直接操纵内部状态能够分离出各个因素的独立贡献,避免混淆变量的干扰。这也是本文标题所提问题——"学习历史是资产还是负担"——能够被严谨回答的关键。
循环状态(recurrent state)在此语境中指携带历史信息的隐藏向量,类似于循环神经网络(RNN)中的隐状态。自发现RL规则通常采用具有记忆能力的网络结构(如LSTM或门控RNN)作为"元控制器",在每个时间步接收当前奖励、观测和前一动作,并输出参数更新量。这个隐藏向量积累了智能体从过去交互中提炼的"学习历史"。"钉住"操作将该向量固定为某个特定值(如零向量或来自另一训练阶段的向量),从而切断历史信息的流入;"冻结"则保留向量值但阻止其继续更新;"移植"是将一个任务的历史状态注入另一任务的运行中。这三种操作共同构成了一套可控的因果干预工具集,使研究者能够将历史内容与历史维护机制的效果分别量化。
三大关键发现
审计得出了三项组织性的发现,回答了学习历史的作用边界。
循环历史扩展了可用奖励尺度
第一项发现表明,循环历史(recurrent history)能够主动扩展可用的奖励尺度。在保留历史的情况下,系统维持了一个跨越六个数量级的奖励窗口;而在"零钉住"(zero-pinning)条件下,这一窗口收缩到仅三个数量级。这意味着学习历史在处理跨尺度奖励信号时确实发挥了实质性作用。
不匹配历史的惩罚源于"永久钳制"
第二项发现更为微妙。研究者将历史内容与其维护机制解耦后发现,不匹配历史所带来的性能惩罚,其根源并非历史内容本身,而是来自"永久钳制"(perpetual clamping)。换句话说,如果允许移植进来的状态自然演化,这种负担会大幅减弱。这提示我们,问题往往不在于"记住了什么",而在于"如何维持这些记忆"。
环境变化下的适应优势可能是假象
第三项发现具有警示意义。在环境发生变化时,控制回放保留(replay retention)会逆转其相对于DQN的表观适应优势。这说明外部数据的更替可能会混淆内部可塑性——我们以为是算法内部学到了更强的适应能力,实际上可能只是外部数据流动带来的效果。这一发现对于评估自进化算法的真实能力,提出了严肃的方法论要求。
回放保留(replay retention)是指在经验回放缓冲区(replay buffer)中保留历史数据的策略,DQN(深度Q网络)等离线算法依赖该机制从过去经验中反复采样学习。在非平稳环境(即奖励分布或动态规律会随时间改变的场景)中,回放缓冲区的新旧数据比例会对性能产生关键影响:保留过多旧数据可能导致算法"活在过去",而清空缓冲区则会丢失有价值的先前经验。本文发现,当研究者控制回放保留比例后,自发现规则相对于DQN的适应优势会消失——这意味着此前观察到的优势,可能并非来自算法内部进化出了更强的可塑性机制,而仅仅是两种算法在数据新鲜度管理上的默认配置差异所致。这一发现对非平稳环境下RL算法的比较评估具有普遍方法论意义。
对下一代自进化RL的意义
这些结论并非仅在单一规则上成立。研究通过能力阈值(capability thresholds)进行了验证,并将审计方法移植到了第二个自发现规则OPEN上,证明了方法的普适性。
这项工作的深层价值,在于它把宏观层面的递归自我改进雄心,重新锚定在了微观层面的学习动力学之上。业界热衷于讨论模型规模、涌现能力和自我改进的宏大叙事,但如果底层的更新规则本身存在未被理解的脆弱性,这些宏观目标就缺乏可靠的地基。
论文由此提出,应当为下一代自进化RL算法建立一套基础性的审计标准。这不仅是对Disco103这类具体成果的检验,更是对整个"自发现优化引擎"研究范式的方法论奠基。当算法开始自己发现算法时,我们比以往任何时候都更需要能够打开黑箱、验证因果的工具。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。