自适应量化让TD学习在有限带宽下保持快速收敛
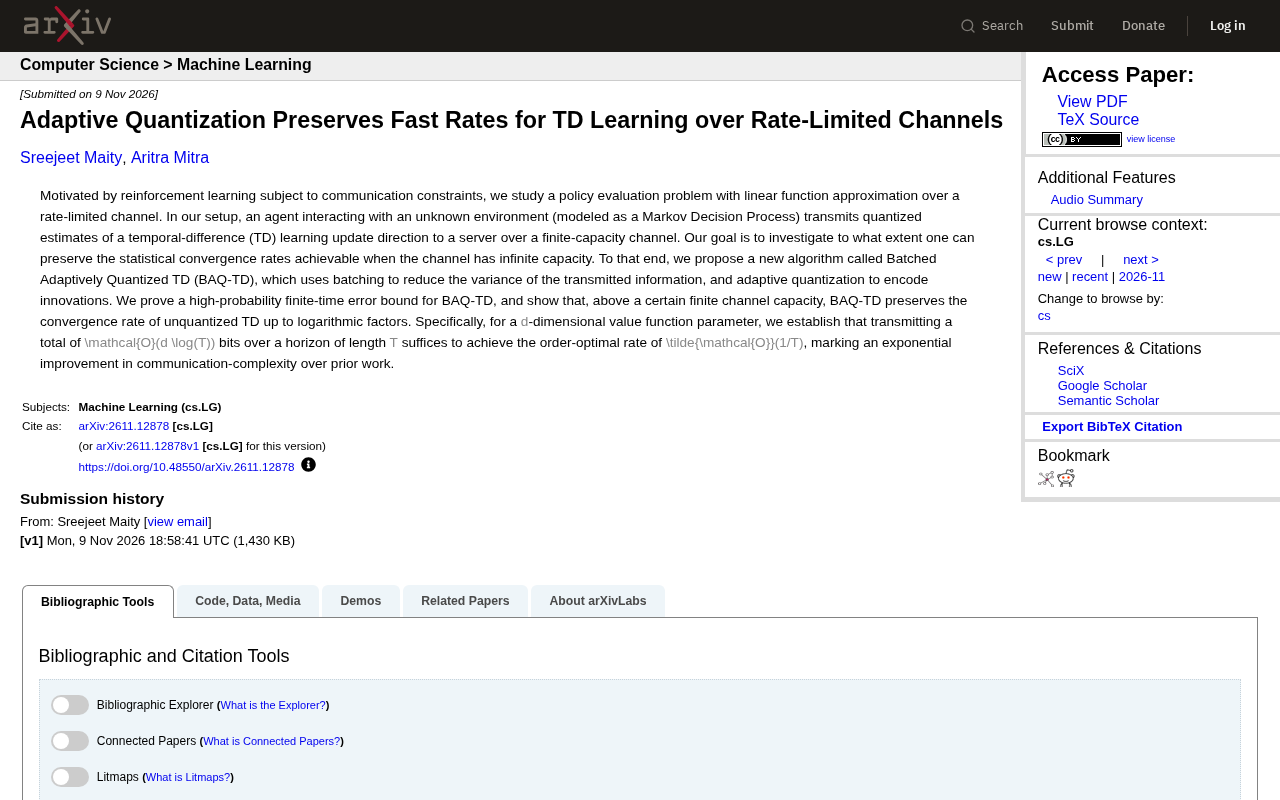
BAQ-TD算法证明自适应量化可在有限信道下保持TD学习的快速收敛速率。
论文研究通信受限的分布式强化学习中的策略评估问题,提出BAQ-TD算法,通过批处理降低方差、自适应量化编码创新量,有效利用有限比特资源。理论分析给出高概率有限时间误差界,证明当信道容量超过某阈值后,算法能以对数因子为代价保持无量化TD的收敛速率。对于d维参数,传输O(d log T)比特即可达到阶数最优的Õ(1/T)速率,通信复杂度较先前工作实现指数级改进。该成果为通信高效的分布式强化学习提供了理论基础和算法设计思路。
研究背景:通信约束下的强化学习
在分布式强化学习系统中,智能体与服务器之间的通信带宽往往有限。传统的时间差分(TD)学习算法假设参数更新可以无损传输,但现实场景中必须对更新方向进行量化压缩。这引出一个关键问题:量化后的TD学习能否保持与无量化版本相同的统计收敛速率?
来自rss的一篇论文《Adaptive Quantization Preserves Fast Rates for TD Learning over Rate-Limited Channels》针对这一问题展开了深入研究。该工作考虑一个线性函数近似的策略评估问题,其中智能体与未知环境(建模为马尔可夫决策过程)交互,并通过有限容量信道向服务器传输量化的TD更新方向。研究目标是探究在何种程度上可以保留无限容量信道下的收敛速率。
策略评估是强化学习中的核心问题之一,指在给定策略下估计状态价值函数(或动作价值函数)。在线性函数近似设定下,值函数被参数化为特征向量的线性组合,即 (V_\theta(s) = \theta^\top \phi(s)),其中 (\phi(s)) 是状态 (s) 的特征映射,(\theta \in \mathbb{R}^d) 是待学习参数。策略评估通常采用时序差分(TD)学习,通过随机逼近迭代更新参数:(\theta_{t+1} = \theta_t + \alpha_t (r_t + \gamma V_{\theta_t}(s_{t+1}) - V_{\theta_t}(s_t)) \phi(s_t))。线性函数近似因其可分析性强,成为理论研究的基准模型;许多深度强化学习的收敛性分析也常从线性情形出发。本文正是在这一框架下研究量化通信对收敛速率的影响。
BAQ-TD算法:批处理与自适应量化的结合
为了解决通信受限下的TD学习问题,作者提出了名为**Batched Adaptively Quantized TD(BAQ-TD)**的新算法。该算法包含两个核心设计:
- 批处理(Batching):通过累积多个时间步的更新来降低传输信息的方差,从而减少量化误差的影响。
- 自适应量化(Adaptive Quantization):对创新量(innovations)进行编码,即只传输当前估计与前一估计的差异部分,而非完整参数。这种差分编码方式能够更高效地利用有限的比特资源。
这两个机制协同工作,使得算法在有限信道容量下仍能保持稳定的学习性能。
创新量(innovations)编码是一种差分编码技术,源自信号处理与估计理论。在分布式优化中,若每次传输完整的参数向量,则相邻轮次间的冗余信息会被重复发送,浪费带宽。创新量指当前估计与接收端已知的前一估计之差,即 (\Delta_t = \theta_t - \hat{\theta}{t-1}),其中 (\hat{\theta}{t-1}) 是服务器端重建的上一轮参数。只对 (\Delta_t) 进行量化并传输,接收端通过累加解码即可恢复当前估计。由于创新量的动态范围通常远小于参数本身,且其分布可能随迭代变化,自适应量化器可以根据历史创新量的幅度动态调整量化区间和步长,从而在有限比特下最小化量化误差。这种差分编码与自适应量化的结合,是BAQ-TD实现高效通信的关键。
理论保证:有限容量下的快速收敛
论文的核心贡献之一是给出了BAQ-TD的高概率有限时间误差界。理论分析表明,当信道容量超过某个有限阈值后,BAQ-TD能够以对数因子为代价保持无量化TD的收敛速率。
具体而言,对于维度为(d)的值函数参数,在长度为(T)的时间范围内,总共传输(\mathcal{O}(d \log(T)))比特就足以达到阶数最优的(\tilde{\mathcal{O}}(1/T))收敛速率。这一结果意味着,相较于先前的工作,通信复杂度实现了指数级改进——从可能随(T)多项式增长降至对数增长。
这一理论发现具有重要的实践意义:它表明在分布式强化学习系统中,即使通信带宽非常有限,只要采用恰当的自适应量化策略,仍然可以实现快速收敛,而无需牺牲统计效率。
高概率有限时间误差界是统计学习理论中刻画算法收敛性能的严格框架。与仅给出期望意义下的渐近速率不同,有限时间界明确依赖于迭代次数 (T)、置信水平 (1-\delta) 以及问题参数(如维度 (d)、混合时间等),形式通常为:以至少 (1-\delta) 的概率,(|\theta_T - \theta^*|^2 \le C \cdot \tilde{\mathcal{O}}(1/T)),其中 (\tilde{\mathcal{O}}) 隐藏了对数因子。这种界能够同时反映收敛速度与可靠性,对于通信受限系统尤为重要——因为量化误差是随机的,必须控制其以高概率不影响收敛。论文证明BAQ-TD在信道容量超过阈值后仍能达到此类界,且额外项仅含对数因子,从而保证了实际部署中的鲁棒性。
与现有工作的对比
以往关于通信受限TD学习的研究通常需要更多的比特数或只能保证较慢的收敛速率。BAQ-TD通过批处理降低方差、通过自适应量化编码创新,在两者之间取得了平衡。论文明确指出,其通信复杂度相对于先前工作是指数级改进,这得益于对信息结构的更精细利用。
你可能没注意到,该理论保证适用于线性函数近似下的策略评估问题,这是强化学习中的一个基础设定。虽然实际应用可能涉及非线性函数近似,但这一结果为后续扩展奠定了理论基础。
潜在影响与未来方向
BAQ-TD的理论成果为通信高效的分布式强化学习提供了新思路。在联邦强化学习、多智能体系统等场景中,智能体与中心服务器之间的通信瓶颈一直是制约性能的关键因素。该算法通过自适应量化和批处理,在保持快速收敛的同时大幅降低通信开销,有望推动这些领域的发展。
未来可能的研究方向包括将方法扩展到更复杂的函数近似(如神经网络)、考虑更一般的信道模型(如时变信道),以及在实际系统中验证算法的鲁棒性。
总结
这篇论文通过BAQ-TD算法证明了自适应量化可以在有限速率信道下保持TD学习的快速收敛速率,通信复杂度仅随参数维度对数增长。这一结果不仅加深了对量化TD学习理论的理解,也为实际分布式强化学习系统的设计提供了指导。
相关推荐
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。