自建AI Studio实践:编码到发布全流程自动化

从「手动挡」到「自动挡」的进化
在AI辅助编程的浪潮中,越来越多开发者不再满足于让AI单纯「写代码」,而是希望打通从代码生成到应用发布的完整链路。近日,一位技术博主分享了自己搭建的 AI Agent Studio(下称 Manifest Studio),实现了编码、构建、发布的全流程自动化——这正是「自动挡」的魅力所在。
值得先厘清一个概念:AI Agent(智能体)与 GitHub Copilot 等代码补全工具的本质差异在于「自主性」。传统代码补全工具是被动响应——开发者输入,工具输出单次建议。而 Agent 具备规划(Planning)、工具调用(Tool Use)和多步执行(Multi-step Execution)能力,能够将一个高层目标分解为多个子任务,并自主选择工具逐步完成。
这种范式通常基于 ReAct(Reasoning + Acting) 框架,让模型在「思考—行动—观察」的循环中推进任务,直至目标达成。ReAct 框架由普林斯顿大学与谷歌于 2022 年联合提出,其核心创新在于将语言模型的「链式思考(Chain-of-Thought)」推理能力与外部工具调用能力结合:模型不仅能推理「下一步该做什么」,还能在推理中途调用搜索引擎、代码解释器、API 等工具获取实时反馈,再根据工具返回结果动态调整后续推理方向。
要理解 ReAct 的突破性,需要先了解它所改进的两种前身方案的局限:纯 Chain-of-Thought(CoT)让模型在回答前进行多步推理,但整个推理过程是封闭的,模型只能依赖训练时的参数化知识,无法获取最新信息或执行计算——这导致 CoT 在需要实时数据或精确计算的任务上表现欠佳;纯 Action 方案则直接调用工具但缺乏中间推理步骤,容易在复杂任务中迷失方向。ReAct 将二者交织融合:每一次工具调用的结果都会即时注入模型的上下文窗口,成为下一轮推理的输入依据,形成真正的认知闭环。原始论文在 HotpotQA、Fever 等多跳推理基准上的实验表明,ReAct 相比纯 CoT 将幻觉率(Hallucination Rate)降低了约 34%,这一结果直接推动了 Agent 框架设计的范式转变。值得注意的是,ReAct 并非简单的「先想后做」——它的关键突破在于推理与行动的交织进行,与单纯的思维链相比,这种「边思考边行动」的闭环显著提升了复杂任务的完成率和事实准确性,是当前主流 Agent 框架(LangChain、AutoGen、CrewAI 等)的共同理论基础。
当单个 Agent 的上下文窗口或能力边界无法覆盖更复杂的工程任务时,多智能体协作(Multi-Agent)架构成为下一阶段的自然演进方向。在 AutoGen、CrewAI 等框架中,不同 Agent 被赋予专属角色——代码生成者、单元测试者、安全审计者、发布执行者——通过标准化的消息传递协议协同完成任务。每个 Agent 只需维护自身职责范围内的上下文,从而突破单一 Agent 的窗口限制。这种「分工协作」的架构哲学与 Manifest Studio 中 Skill 按职责封装的设计思路一脉相承:将复杂任务拆解为边界清晰的子能力单元,既降低了单次推理的认知负荷,也使各模块可独立迭代与测试。
此前他介绍过应用托管平台 App Platform,但彼时的发布流程仍有明显痛点:开发者需要手动组织压缩包的文件结构,还要自行编写 Manifest 定义文件。这些重复性的工程化工作,恰恰是 AI Agent 最适合接管的部分。本文的核心,正是介绍如何将 Manifest Studio(Agent 工作台)与 App Platform(发布平台)的路径彻底打通。
Manifest Studio 工作台解析
Manifest Studio 已在 K8s 集群中完成部署,并与 App Platform 实现互通。这里的 Kubernetes(K8s) 是 Google 于 2014 年开源的容器编排系统,目前已成为云原生应用部署的行业标准。理解 K8s 的核心价值需要回溯容器化时代的工程痛点:单个容器解决了「运行环境一致性」问题,但当应用由数十乃至数百个容器组成时,如何协调它们的启停顺序、健康检查、网络互通和存储挂载,成为新的复杂度来源。K8s 通过「声明式配置」解决了这一问题——开发者描述「期望状态」(例如「始终保持 3 个副本运行」),K8s 的控制循环(Control Loop)持续比对现实状态与期望状态的差距并自动修正:当某个实例崩溃时自动重启,当流量激增时自动扩展副本数,当节点故障时自动迁移工作负载。将工作台部署在 K8s 集群中,意味着它具备生产级的可靠性与弹性。该项目同时支持 Docker Compose 部署,则是为本地轻量开发场景提供的低门槛入口,无需完整的 K8s 环境即可快速上手验证。
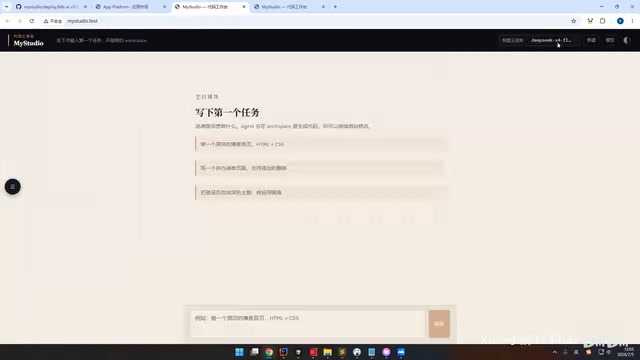
在 App Platform 中原本只能「手动部署、下载模板包」,现在则可以直接点击按钮跳转到 Manifest Studio 工作台进行代码编写。
工作台界面设计直观清晰:
- 左侧:会话列表,用于管理不同的开发任务
- 中部:模型选择区,可自由切换所需大模型
- 模型配置:目前支持 OpenAI 兼容协议的供应商(示例中使用的是阿里云广告百炼)
OpenAI 兼容协议已事实上成为大模型服务的行业接口标准,其核心是 /v1/chat/completions 这一 REST 接口规范。该规范定义了请求体中 model、messages、temperature 等字段的语义,以及流式响应(Server-Sent Events)的格式约定。这一标准的形成有其历史脉络:2022 年底 ChatGPT 的爆发式增长使 OpenAI API 迅速成为开发者默认的集成目标,大量下游应用围绕该接口构建;随后国内外涌现的大模型厂商(阿里云百炼、字节跳动火山引擎、本地部署的 Ollama、开源的 vLLM 推理框架等)为降低开发者迁移成本,纷纷选择兼容该接口而非推行私有协议,形成了类似「市场选择」的自然标准化过程。这带来了显著的工程价值:应用层代码无需针对不同供应商单独适配,只需修改 base_url 和 api_key 即可切换底层模型。从协议演化角度看,这一标准的确立类似于 JDBC 对数据库连接的统一,降低了整个生态的碎片化程度,也使模型能力与应用逻辑解耦成为可能。
值得关注的是模型发现机制:配置好供应商后,点击「发现模型」即可自动拉取该供应商的模型列表;若列表中没有目标模型,还支持手动添加后直接在选择器中使用。这种设计兼顾了自动化效率与灵活性,有效避免了硬编码模型名带来的局限。开发者在此基础上还可以实现模型路由策略——例如对代码生成任务调用 DeepSeek广告 Coder,对自然语言理解任务调用 Qwen,通过统一协议实现能力互补。
在工具生态的标准化层面,值得关注的是 Anthropic 于 2024 年 11 月发布的 MCP(Model Context Protocol) 协议。如果说 OpenAI 兼容协议统一了「应用层调用模型」的接口,MCP 则试图统一「模型调用工具」的接口——这是 Agent 生态中另一个关键的碎片化节点。在 MCP 出现之前,每个 Agent 框架(LangChain、AutoGen、CrewAI)都有自己的工具描述格式和调用规范,导致为一个框架开发的工具无法直接迁移到另一个框架。MCP 通过定义标准化的 Server/Client 架构,使工具提供方只需实现一次 MCP Server,即可被所有支持 MCP 的 Agent 客户端调用,从工具供给侧消除了碎片化。MCP 的 Server/Client 架构借鉴了 LSP(Language Server Protocol)的设计思路——LSP 正是 VS Code 能够以统一方式支持数十种编程语言智能提示的底层协议基础,这一被验证的架构模式被 MCP 迁移到了 Agent 工具生态领域。Manifest Studio 中的 Skill 机制若未来对接 MCP 协议,将使其发布能力可被更广泛的 Agent 生态复用。
实战演示:自动生成登录页
为直观展示「自动挡」效果,作者让 Agent 开发一个简单的登录页,并要求生成 index.html——因为托管环境默认加载该文件,后续访问无需额外指定路径。
执行过程中,工作台会实时展示执行日志,清晰呈现模型每一步的行为:调用了哪些工具、工具是否正常返回、当前进度如何。可观测性(Observability) 在 Agent 系统中具有特殊重要性——Agent 的行为链路本质上是概率性的推理过程,与确定性代码不同,相同的输入可能产生不同的工具调用序列。
理解这一特殊性需要与传统软件可观测性作对比:传统分布式系统的可观测性三要素(Metrics 指标、Logs 日志、Traces 链路追踪)主要针对确定性系统设计,故障排查的核心假设是「给定相同输入,系统行为可复现」。而 LLM 驱动的 Agent 引入了推理的随机性(temperature 参数控制的采样多样性)和上下文依赖性(前序对话历史影响当前决策),使得传统的链路追踪工具无法直接捕获「模型为什么做出这个决策」的语义信息。执行日志让开发者能够追溯每次推理中调用了哪个工具、工具入参是什么、返回值是什么、模型如何根据返回值调整下一步行动。在生产环境中,LangSmith、Langfuse 等专为 LLM 应用设计的可观测性平台将这一需求推向了更系统化的层次:它们能记录跨越数十次 LLM 调用和工具调用的完整链路,通过树状调用图可视化呈现因果关系,并支持将真实执行轨迹标注后用于 Agent Evaluation,形成「部署—观测—评估—改进」的持续优化闭环。这类日志是回溯异常行为、持续改进 Prompt 的基础数据,也是在团队协作中建立对 Agent 行为信任的重要依据。
与可观测性密切相关的是 Agent Evaluation(智能体评估) 这一尚未完全解决的工程难题。传统软件质量保障依赖单元测试和集成测试,其前提是「确定性输入产生确定性输出」;而 Agent 的行为链路具有概率性,相同的用户指令在不同执行轮次中可能走过不同的工具调用路径,且最终结果的「正确性」往往难以用简单的字符串匹配衡量。当前业界主要采用三个维度的评估框架:轨迹评估(Task Trajectory Evaluation)检查推理路径是否合理,例如发布任务是否经历了「生成 Manifest → 组织目录 → 调用 API」的正确步骤;结果评估(Outcome Evaluation)检查最终交付物是否符合预期;效率评估衡量完成任务所需的 LLM 调用次数,因为冗余的推理步骤直接对应延迟和成本。对于 Manifest Studio 这类自建系统,建立哪怕最简单的冒烟测试——例如每次发布后验证应用是否真正上线并可访问——都是保障系统可靠性的重要工程投入。
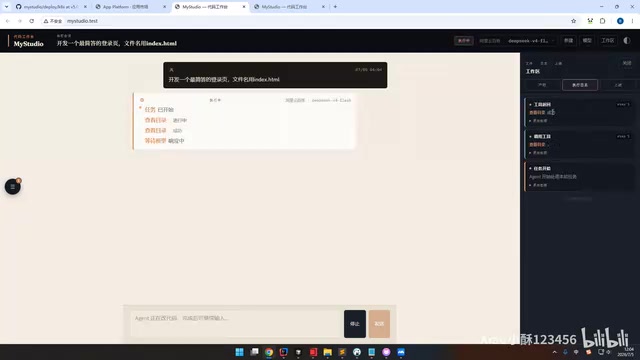
生成的文件统一存放在工作区目录下。很快,index.html 便出现在工作区中。整个过程中,开发者只需描述需求,无需手动敲一行代码。
一句话完成发布:Skill 机制的巧思
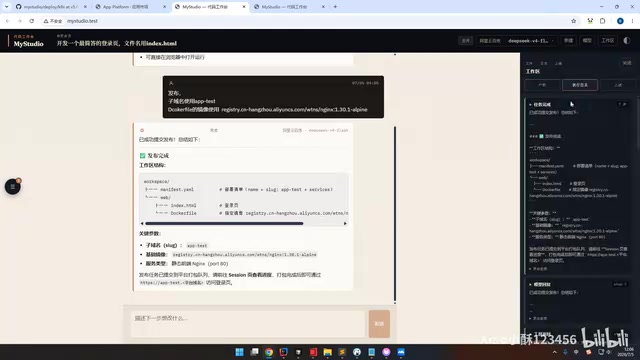
这套系统最亮眼的部分在于发布环节。应用开发完成后,只需对 Agent 说「发布」,几乎不需要任何额外操作。发布时有两个关键参数需要留意:
slug 子域名
每个 App 的访问需要一个 slug(子域名)。若不指定,系统会随机分配。由于配置了域名映射,示例中明确指定使用 app-test 作为子域名。
镜像构建的网络限制
在使用 Kaniko 进行镜像构建时,若无法访问外网镜像仓库,需在 Dockerfile 中指定可用的基础镜像,以规避网络问题。Kaniko 是 Google 开源的容器镜像构建工具,专为 Kubernetes 等无特权容器环境设计——传统的 Docker-in-Docker(DinD)方案要求容器以特权模式(privileged)运行,在多租户集群中会带来宿主机逃逸的安全风险。
要理解为何 DinD 的特权模式如此危险,需要了解 Linux 容器的隔离边界:容器本质上是通过 Namespace(命名空间隔离)和 Cgroups(资源限制)实现的进程,特权模式意味着容器内进程拥有与宿主机 root 几乎等同的权限,可直接操作宿主机设备文件、加载内核模块,一旦容器内代码存在漏洞,攻击者即可突破容器边界控制整个宿主机节点。Kaniko 则在用户空间内直接解析 Dockerfile 并逐层构建镜像,无需访问 Docker Daemon,可在普通非特权容器中安全执行。这一安全模型在实现上依赖了一个关键技术细节:Kaniko 将每一个 Dockerfile 指令对应的文件系统变更以 snapshot 形式捕获,直接操作 OCI 镜像规范定义的 layer tar 文件,完全绕开了宿主机内核的容器运行时接口,从根本上消除了特权提升的攻击面。除 Kaniko 外,同类工具还包括 Buildah(Red Hat 出品,支持无 Daemon 的镜像构建与推送)和 img(基于 BuildKit 的用户态构建工具),三者共同构成了 K8s 环境下安全镜像构建的主流方案谱系。
在受限网络环境中应对 Kaniko 的镜像拉取问题,业界标准实践是预先将常用基础镜像(如 nginx:alpine、node:lts-slim)同步至内网 Harbor 或 Nexus 等私有镜像仓库,并在 Dockerfile 的 FROM 指令中以内网地址引用(例如 FROM harbor.internal/library/nginx:alpine)。这一「镜像预热」策略不仅解决了离线构建问题,还因省去了外网拉取而显著缩短了构建耗时——在大规模 CI/CD 场景中,基础镜像的本地缓存命中率直接影响流水线的整体吞吐量。由于 Kaniko 执行期间无法动态切换镜像源,在离线或受限网络环境下需提前将基础镜像同步至内网仓库——这一细节体现了将 CI/CD 能力内嵌于 Agent 工作流时必须考量的基础设施约束。
发布的核心逻辑依赖于一个精心设计的 Skill(技能),承担两项职责:
- 组织目录结构:按照 App Platform 要求的 zip 格式,将工作区目录补全为规范结构
- 调用发布接口:完成向 App Platform 的实际发布请求
从工程实现角度看,Skill 机制的底层正是大模型的 Function Calling(函数调用) 能力。这一能力由 OpenAI 于 2023 年 6 月在 GPT-3.5/GPT-4 API 中正式引入,其本质是让模型输出结构化的 JSON 调用指令而非纯文本:开发者以 JSON Schema 的形式向模型描述可用工具的名称、参数类型与功能语义,模型在推理时自主判断是否需要调用工具,并生成符合 Schema 约束的参数对象,由应用层捕获后执行真实操作,再将结果反馈给模型继续推理。
理解 Function Calling 的意义需要与早期「通过 Prompt 指导模型输出特定格式文本再手动解析」的方案作对比:后者依赖模型对格式指令的遵从度,在模型规模较小或指令复杂时容易输出格式错误的文本,且参数合法性无法在调用前验证;Function Calling 则通过 JSON Schema 约束在模型输出层面就保证了结构合法性,显著降低了解析失败率,也使工具能力的描述从自然语言「软约束」升级为结构化「硬约束」。从技术实现角度,现代模型(如 GPT-4o、Claude 3.5 Sonnet)会在微调阶段专门针对工具调用场景进行对齐训练,使模型能够更精准地判断「何时该调用工具、何时该直接回答」——这一判断能力本身就是模型能力的重要维度之一。Anthropic 的 Claude 将其称为 Tool Use,Google Gemini 称为 Function Declarations,机制本质相同。Skill 是对这一机制的上层封装,使模型能够以语义化方式识别并触发复合操作:模型不需要知道发布 API 的具体 URL 或认证方式,只需识别到用户意图为「发布」即可触发正确的 Skill,降低了提示工程的复杂度,也使技能本身可以独立迭代而不影响模型交互逻辑。
Agent 执行多步骤任务时还面临上下文窗口(Context Window)管理这一核心工程挑战。当前主流大模型的上下文窗口从 GPT-4 Turbo 的 128K tokens 到 Claude 3.5 的 200K tokens 不等,看似宽裕,但在 Agent 场景中会迅速消耗:每次工具调用的输入输出都会追加到上下文历史,复杂任务经历数十次工具调用后,历史记录可能占满整个窗口,导致模型「失忆」早期任务要求。工程实践中常见的缓解策略包括:滚动窗口(保留最近 N 轮对话)、摘要压缩(用模型总结早期历史替代原文)、外部记忆存储(将中间结果写入向量数据库,按需检索)。
其中,向量数据库与 RAG(检索增强生成) 的结合是外部记忆存储的主流实现路径。向量数据库(如 Chroma、Weaviate、Milvus)将文本片段以高维向量形式持久化存储,支持基于语义相似度的快速检索。Agent 可在执行过程中将工具调用的中间结果、重要的代码片段或用户偏好写入向量库,在后续推理需要时通过语义检索按需取回相关片段注入当前上下文——而非保留全量历史。这正是 RAG 思想从「知识问答」场景向「Agent 记忆管理」场景的延伸:通过「存储—检索—注入」的动态机制,Agent 获得了超越上下文窗口物理限制的长期记忆能力。理解向量检索的工作原理有助于把握其局限:文本被嵌入模型(Embedding Model,如 text-embedding-3-small)转化为高维稠密向量后,通过近似最近邻(ANN)算法(如 HNSW、IVF)在毫秒级别完成相似度检索。「相似度」在此语境下指语义层面的相近程度,而非字符串的字面匹配——这意味着「如何部署应用」和「怎么把程序上线」在向量空间中是相邻的。然而向量检索对精确匹配(如特定函数名、精确配置值)的召回效果不如全文检索,在 Agent 记忆管理实践中往往采用向量检索与关键词检索的混合方案。在 Manifest Studio 的场景中,代码生成与发布是相对短程的任务,上下文压力较小;但若未来扩展至多轮迭代开发或跨会话持久记忆,上下文管理策略的选择将直接影响 Agent 的可靠性边界。
当大模型判断用户意图为「发布」时,会自动读取该 Skill 并按步骤执行。从执行日志可以看到,Manifest 被自动生成,slug 正确设为 app-test,index.html 也被妥善归入 web 目录——目录结构完全由 AI 自动完成。
打通闭环:Studio 与 App Platform 协同
发布完成后,刷新页面即可看到应用状态显示为「上线」,并附有访问地址。打开链接,登录页已成功运行。
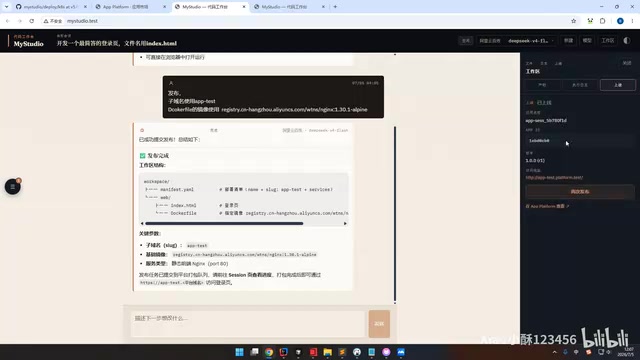
回到 App Platform 查看,该应用赫然在列:构建日志、应用市场 ID 一应俱全,slug 也正是指定的 app-test。至此,Manifest Studio(Agent 工作台)与 App Platform(代码发布平台)的完整链路正式打通。
开发者可以在同一界面里完成代码编写,然后一句话直接发布到托管平台——目录结构怎么组织、Manifest 怎么写,统统交给 AI 自动处理。
技术价值与工程思考
这套自建 AI Studio 的价值,不仅在于它「能用」,更在于它展示了一种 Agent 工程化的实践范式:
- Skill 抽象:将复杂的发布流程封装为可复用的技能,让大模型在合适时机通过 Function Calling 自动调用——这是构建可靠 Agent 的关键设计,也使技能与模型交互逻辑解耦,便于独立迭代
- 可观测性:完整的执行日志让 Agent 行为不再是黑盒,便于调试、排查和信任建立;LangSmith、Langfuse 等专为 LLM 应用设计的可观测性平台进一步将这一能力系统化,通过树状调用图和 Evaluation 流水线支撑持续改进
- 工具生态标准化:OpenAI 兼容协议统一了模型调用接口,而 MCP 协议则进一步尝试统一工具调用接口,两者共同构成 Agent 生态降低碎片化的双轮驱动
- 端到端链路:从代码生成到应用部署的全程自动化,才是「自动挡」的真正意义;其中 Kaniko 镜像构建与 K8s 编排的组合,提供了生产级的基础设施保障
- 多智能体演进:当单 Agent 能力边界受限时,Multi-Agent 协作架构通过角色分工与消息传递协议突破瓶颈,是 Manifest Studio 未来扩展为更复杂工程任务自动化的自然演进路径
该项目目前主要用于理解 Agent 原理,尚未公开,但支持 Docker Compose 和 K8s 两种部署方式。对于希望深入理解 Agent 运作机制的开发者而言,这类自建实践比直接使用现成工具更有价值——你会真正理解每一个环节背后的工程决策:为什么选择 Kaniko 而非 DinD、为什么用 OpenAI 兼容协议而非私有接口、为什么 Skill 的抽象粒度要与用户意图对齐、为什么 ReAct 的「思考—行动—观察」循环比单次推理更适合复杂任务、为什么上下文窗口管理是长任务 Agent 的关键瓶颈、为什么向量数据库与 RAG 是突破记忆限制的关键基础设施。
随着 Agent 技术持续成熟,「描述需求—自动交付」将成为软件开发的新常态。而亲手搭建这样的系统,正是把握这一趋势、建立深层理解的最佳路径。
核心要点
相关推荐

本地AI部署神器LocModel:一键玩转开源模型与AI生成
LocModel是一款本地AI部署工具,可自动适配硬件、一键下载开源模型,支持图片生成、视频生成、无审查大模型和Agent智能体,完全免费。本文基于实测视频介绍其安装与使用流程。

Antigravity CLI:终端免费调用Gemini与Claude顶级模型
Antigravity CLI(agy)宣称可在VS Code终端免费调用Gemini 3.1 Flash、Claude Sonnet等顶级模型,几秒完成安装。本文拆解其使用流程、终端内调用模型的价值,以及免费宣称背后需要核实的安全与可持续性问题。

聊天机器人与AI智能体:核心区别与选型指南
聊天机器人与AI智能体到底有什么区别?本文从工具、记忆、工作流三个维度拆解两者差异,用整理收件箱、安排会议等四个真实场景对比,并给出权限控制、不可逆操作确认等风险防范建议与选型判断标准。