自建Layer服务实战:Router、SDK与OpenAI兼容接口全解析

Layer 框架四种调用方式的实操梳理与测试评估
文章基于实操演示,系统梳理了 AI 路由框架 Layer 的部署与调用方式。环境上强调必须使用 Layer 自带 Venv 中的 Python 解释器,以避免 Torch 等重型依赖的版本冲突。调用层面给出四条路径:Router 自动分流并返回 Routing 字段、Layer.load 手动指定模型、System1 兼容的本地 HTTP 接口,以及通过 TypeSafe SDK 以 OpenAI 风格对接。四者结果一致,差异仅在是否经过路由层。测试显示官方用例基本全部通过,仅两个与 creative 判断相关的用例因设计不合理未通过;响应为毫秒级,可通过 systemd 托管并用 journalctl 查看日志。
Layer 是一个面向 AI 路由与模型分流的推理框架,支持在本地以 Editable 模式安装并直接加载模型,省去 HTTP 调用开销。本文基于 B 站 UP 主的实操演示,梳理 Layer 的多种调用方式、与 TypeSafe(OpenAI 兼容风格)SDK 的对接细节,以及官方测试用例的通过情况。
环境准备:为什么必须用 Layer 自带的 Python 解释器
演示者强调,运行 Layer 示例时务必使用 Layer 目录下 Venv 中的 Python 解释器,而不是系统全局 Python。原因在于 Layer 安装过程中依赖 Torch、Flash 和 Tension 等第三方包,这些包安装耗时且容易因版本不匹配或环境冲突导致问题。直接复用 Layer 初始化好的虚拟环境,可以避免重新搭建环境时出现的兼容性错误。
这种设计虽然增加了路径上的约束,但换来了环境的一致性——所有示例都在同一个已验证的依赖集合下运行,减少“在我机器上能跑”的调试成本。
Venv 与 Editable 安装
Venv(virtual environment)是 Python 标准库自带的虚拟环境工具,它把项目依赖隔离在独立目录中,避免与系统全局 site-packages 冲突。执行 python -m venv .venv 即可创建,激活后 pip install 的包只在该环境内可见。Layer 在初始化时已经建好这个环境并装好了 Torch 等重型依赖,因此直接调用其 Venv 中的解释器等价于“复用一份已验证的依赖快照”。
Editable 安装(pip install -e .)则是指向源码目录的可编辑安装:Python 不会把包复制进 site-packages,而是写入一个指向源码路径的链接文件(.pth 或 egg-link)。这样修改源码后无需重新安装即可生效,非常适合调试框架本身。两者结合,就是演示中“每次执行都加载本地模型、全程不走 HTTP”能成立的前提。
方式一:Router 自动分流,一次请求完成模型选择
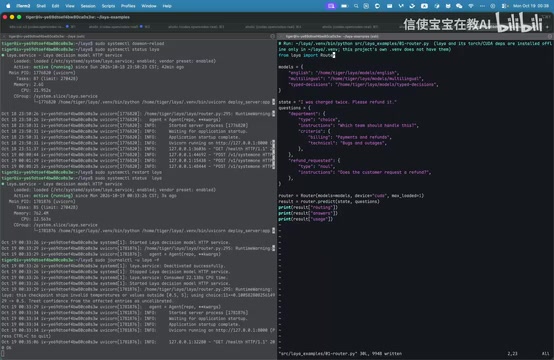
第一个案例位于 src-layer-example-01-router,使用 Layer 自带的 Paths SDK,以 Editable 形式安装后每次执行都加载本地模型,全程不经过 HTTP。
代码中向 Router 传入三种模型,并设置 MaxLoaded=1、强制使用 CUDA。请求时调用 Predict,Router 内部先做模型分流,再加载对应模型,根据用户的 State 和 Question 返回结果。由于走 Router 模式,返回结果中多了一个 Routing 字段,记录最终路由到的模型及原因。
实际运行结果:第一个关于计费与退款的问题被路由到 English 模型,reason 为“English Latent Text”(输入全为英文),最终 Department 选择 Billing,概率 0.98,Technical 概率 0.0132,置信度 0.8984;第二个非选择题(用户是否明确要求退款)为 True 的概率 0.9588,置信度同样很高。Token 消耗方面,输入消耗 80 个 Token,输出不占 Token。
Router 与 MaxLoaded 的含义
Router 是 Layer 的路由层,本质是一个轻量分类/决策模型:它读取输入文本(以及可选的 State),先判断问题属于哪个领域、该交给哪个下游模型,再把请求转发过去。返回结果中的 Routing 字段就是这次决策的审计记录,包含目标模型与 reason,便于排查“为什么走了这个模型”。
MaxLoaded=1 控制的是同时驻留在显存中的模型数量上限。由于每个模型都占用可观的显存,把上限设为 1 意味着同一时刻只保留一个模型实例,切换模型时需要卸载旧模型再加载新模型,以时间换显存。多模型高并发场景下可以调大该值,但需先确认显存余量。强制 CUDA 则确保推理跑在 GPU 上而非回退到 CPU。
方式二:手动 Load 指定模型,去掉路由层
第二个案例不再使用 Router,而是通过 Layer.load 手动指定模型全路径,并指定 CUDA 设备。执行时直接调用 Agent.predict,传入 State 和 Question。由于没有 Router,返回结果中不再有 Routing 字段,只有答案与置信度。
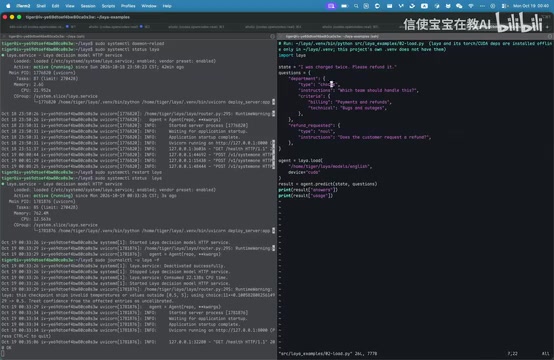
运行结果与 Router 模式基本一致:选择题仍选 Billing,非选择题概率与置信度相近,输入 Token 同为 80,输出不占 Token。两种方式的差异仅在于是否让框架自动做模型分流,手动模式更适合已知模型适用场景、希望减少路由开销的部署。
方式三:通过 System1 兼容接口调用本地服务
Layer 提供了与 System1 兼容的接口,本地服务启动在 127.0.0.1:8000 端口。请求参数与 TypeSafe 官方接口完全一致,Model 字段可填 JV1——Layer 无法识别该模型时会自动回退到 Routing 模式;手动指定 English、MartinLingo 或 Type Decision 则相当于 Layer.load 指定模型。
演示者用 -ffollowing 方式观察日志,可以清楚看到调用过程与 Routing 信息。在另一个示例中,显式设置 Model 为 English,日志确认因显式指定而选择了英文模型。
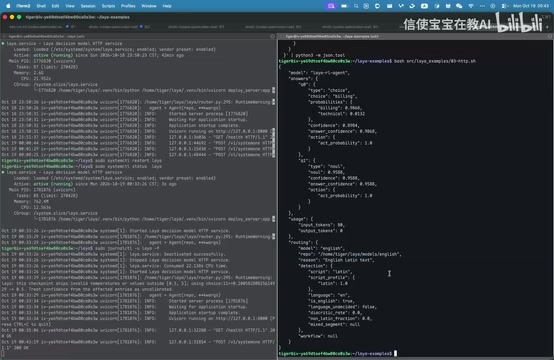
这种方式适合已经使用 System1 接口的现有系统,只需替换 BaseURL 和模型名即可将流量指向 Layer,无需改动业务代码结构。
OpenAI 兼容接口与 BaseURL 替换
所谓“OpenAI 兼容”,指服务端实现了与 OpenAI Chat Completions 相同的请求/响应 JSON 结构(model、messages、choices 等字段),因此任何按该协议编写的客户端都能直接对接,无需改动序列化层。迁移时通常只需改三处:BaseURL 指向 http://127.0.0.1:8000、填入任意非空 API Key、把 model 换成 Layer 认识或故意不认识的名字。
model 字段的行为值得注意:填一个 Layer 无法识别的名字(如演示中的 JV1、jf-1)并不会报错,而是回退到 Router 自动分流;填 English 等已知模型名则等价于手动 Load。这相当于用一个字段同时暴露了两种调用模式,对已有系统来说迁移成本接近于零。
方式四:OpenAI 风格 SDK 直接对接 Layer
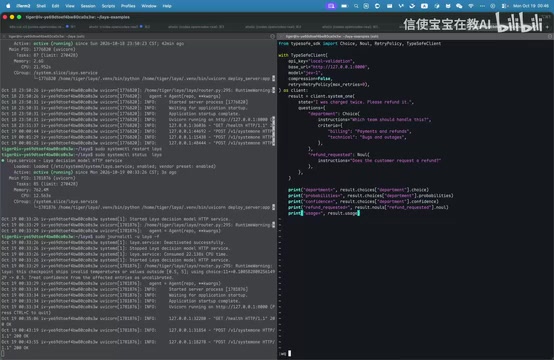
Layer 在输入输出上兼容 TypeSafe 官方接口,因此使用 TypeSafe SDK 时只需替换 BaseURL、API Key 和 Model 即可指向 Layer。演示通过 uv add typeSafe-sdk 安装 SDK(演示者已预先安装),然后创建 Client,BaseURL 指向 localhost:8000,Model 填 jf-1(不存在的模型,自动走 Routing)。
请求两个问题后,SDK 内部根据服务端返回结果拼装最终 Result。选择题可通过 Choice.Question ID.Choice 获取选中项,并通过 .Probability 与 .Confidence 读取各选项概率和置信度;非选择题通过 .Long 获取 True 的概率。最后打印 Usage 信息。用 uv 运行示例即可在日志中看到 System1 调用,结果与预期一致:选中 Billing,各概率与置信度正常。
测试情况与已知问题
三种调用方式——SDK、HTTP 和第三方 TypeSafe SDK——均经过测试,官方提供的测试文件基本全部通过。仅有两个与“酷炸导单”相关的用例未通过,演示者认为问题出在用例设计上:其中一个用例要求判断“产品质量极佳,六个月无任何问题”这类评论是否为 positive,但用例中的 creative 判断依据不明确,且强制要求 True 或 False 的映射关系缺乏可解释性。若补充更丰富的 creative 判断逻辑,Layer 实际可以处理这类问题。
响应速度方面,演示者观察到请求为毫秒级,测试次数不多但量级稳定。对于使用 systemd 托管 Layer 服务的场景,演示者还分享了常用命令:systemctl restart 重启服务、systemctl is-active 查看状态、journalctl 查看日志。
置信度与概率的区别
文中反复出现的 Probability 与 Confidence 并不是同一个量。Probability 是模型对某个具体选项给出的归一化概率(如 Billing 0.98、Technical 0.0132,二者之和接近 1);Confidence 则是模型对“本次输出整体是否可靠”的自评分数(如 0.8984)。前者回答“选哪个”,后者回答“有多确定”。
在评测时只看 Probability 容易高估模型能力:一个二分类问题即使输出 0.95,也可能因为输入本身模糊而 Confidence 偏低。演示中指出两个用例未通过,问题恰恰在于用例把开放式判断强行映射为 True/False,忽略了置信度与语义边界,导致评测结论失真。设计评测集时,应同时考察概率分布形状与置信度阈值,而非仅比对最终标签。
小结
Layer 的价值在于把模型路由、本地加载和 OpenAI 兼容接口整合到同一套框架下。Router 模式适合多模型自动分流,手动 Load 适合确定性场景,System1 兼容接口和 TypeSafe SDK 则降低了现有系统的迁移成本。测试中暴露的用例争议也提示:路由框架的评测标准需要更严谨的设计,而非简单的是非判断。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。