资深软件工程师转型MLOps:该优先补齐哪些能力?
资深软件工程师凭借数学与分布式工程背景转型 MLOps,分析核心能力缺口与最优切入路径。
一位拥有数学硕士学位和七年软件工程经验的资深工程师,正寻求转型至 ML 基础设施与 MLOps 领域。他的技术底座扎实——Python、Kubernetes、CI/CD、MLflow 一应俱全,还有构建基础模型数据管道的实战经历——但在 AWS 云平台、生产级模型服务、ML 专属可观测性和分布式 GPU 基础设施四个方向存在明显缺口。文章以他的案例为切入点,提炼出对同类转型者普遍适用的建议:优先补 AWS(投入产出比最高)、用端到端 ML 编排项目作为作品集、边面试边补缺口而非闭门备考,以及重点关注面试隐藏考点——系统设计与故障处理能力,而非职位描述上罗列的工具名称。文章最终指出,这类工程师的转型门槛比想象中低,关键在于将已有的工程能力重新组织成面向 ML 生命周期的叙事体系。
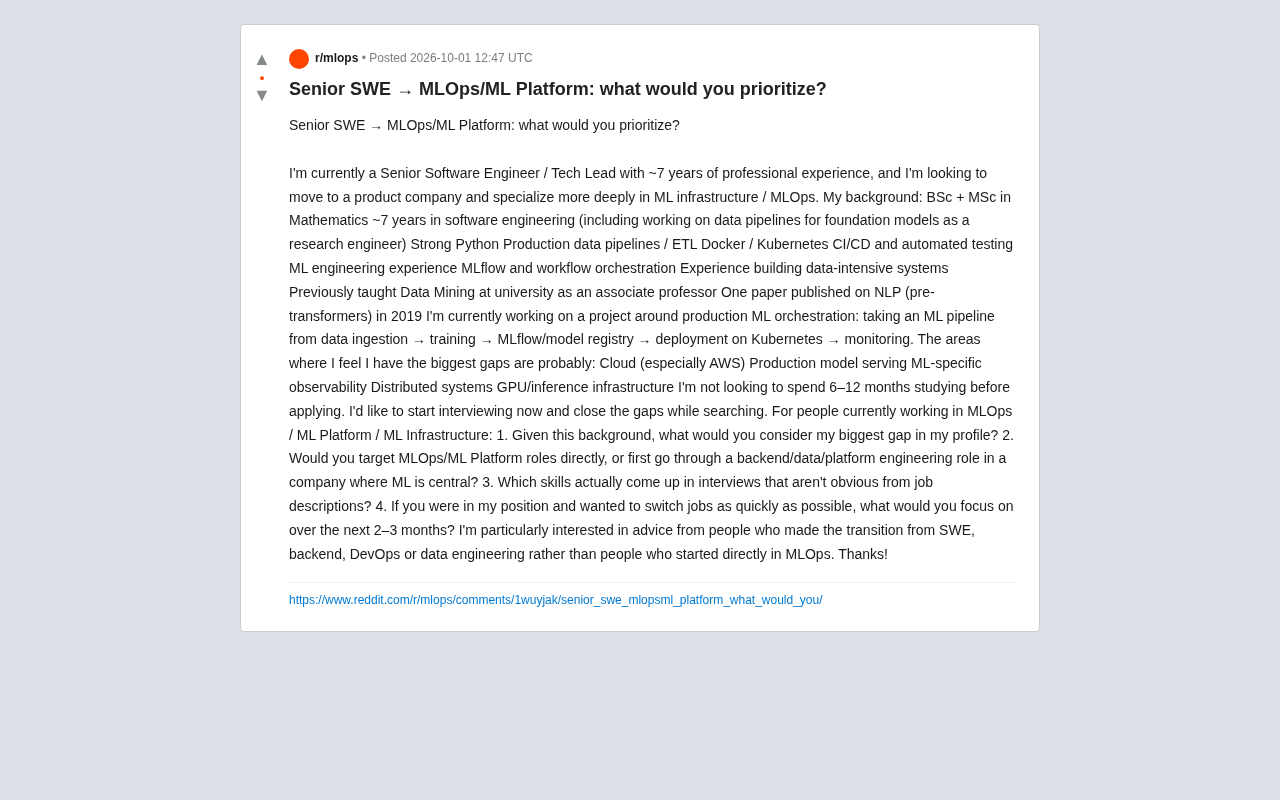
一位拥有约七年经验的资深软件工程师 / 技术负责人,想要转向产品型公司并深耕 ML 基础设施与 MLOps 领域。他在 Reddit 上发帖,详细列出了自己的背景、能力短板,以及最关心的四个转型问题。这篇帖子折射出当下大量后端、数据、DevOps 工程师共同面临的真实困惑:当 AI 工程化成为热门方向时,传统软件工程师如何以最快速度完成跃迁?
他的底牌:数学功底加上扎实的工程能力
从背景来看,这位工程师的履历相当硬核。他拥有数学本科和硕士学位,约七年软件工程经验,其中还包括作为研究工程师为基础模型(foundation models)构建数据管道的经历。技术栈覆盖了 MLOps 岗位的核心需求:
- 扎实的 Python 能力
- 生产级数据管道与 ETL
- Docker / Kubernetes
- CI/CD 与自动化测试
- 具备 ML 工程经验,熟悉 MLflow 与工作流编排
- 构建数据密集型系统的实战经验
他此前还曾在大学担任副教授教授数据挖掘课程,并在 2019 年发表过一篇 NLP 方向的论文(彼时 Transformer 尚未成为主流)。这样的组合——数学理论 + 分布式工程 + 一定的 ML 研究底子——在 MLOps 岗位的候选人中属于比较理想的类型。
他目前正在做一个贯穿端到端的生产级 ML 编排项目:从数据摄取 → 训练 → MLflow / 模型注册表 → 在 Kubernetes 上部署 → 监控。这个项目本身就是一份极具说服力的作品集。
他自认的五大能力缺口
难得的是,这位工程师对自己的短板有清晰认知。他列出了几个感觉最薄弱的领域:
云平台(尤其是 AWS)
这几乎是所有传统工程师转 MLOps 时最常见的门槛。很多 MLOps 岗位的职责本质上是「在特定云平台上把 ML 工作流跑稳跑快」,AWS 的 SageMaker、S3、EKS、IAM 权限体系等都是高频考点。缺乏云经验会直接影响面试通过率。
AWS SageMaker 是目前 MLOps 岗位中最常被提及的托管 ML 平台,它将数据标注、模型训练、超参调优、部署和监控整合为一套服务链路,面试官通常会要求候选人能够描述如何用 SageMaker Pipeline 编排一个完整的训练-部署流程。EKS(Elastic Kubernetes Service)则是将现有 Kubernetes 经验迁移到 AWS 生态的关键桥梁——对于已熟悉 K8s 的候选人,补 EKS 的成本比从零学云平台低得多。IAM(身份与访问管理)权限体系是最常被低估的考点:生产级 ML 系统往往涉及跨服务调用(训练任务访问 S3、推理服务访问模型注册表),权限配置错误是 MLOps 故障的高发来源之一,理解最小权限原则和服务角色(Service Role)的设计是区分初级与资深候选人的典型问题。
生产级模型服务(Model Serving)
从训练产出模型到真正对外提供低延迟、高可用的推理服务,中间隔着大量工程细节:模型版本管理、批处理与实时推理、A/B 测试、灰度发布等。这是 ML Platform 岗位区别于普通后端岗位的关键能力。
模型服务领域有几个常见的开源与托管方案值得了解:Triton Inference Server(NVIDIA 出品)支持多框架模型的高性能并发推理,适合 GPU 场景;TorchServe 是 PyTorch 官方的服务框架;BentoML 和 Ray Serve 则更侧重灵活的 Python 生态集成。面试中常见的考察维度包括:如何处理模型热更新而不中断流量(蓝绿部署或 Canary 发布)、如何设计请求批处理(Dynamic Batching)以提高 GPU 利用率、以及如何在延迟(Latency)与吞吐量(Throughput)之间做权衡。对于只有训练经验而缺乏服务化经验的候选人,最快的补齐方式是将现有模型用 FastAPI + Docker 封装成 REST API 并部署到 K8s,再逐步引入上述框架。
ML 专属的可观测性
传统 APM(应用性能监控)只是起点,ML 系统还需要监控数据漂移、特征分布变化、模型精度衰减等指标。这类「ML-specific observability」往往是职位描述里写得含糊、面试里却被深挖的部分。
ML 系统的可观测性问题本质上分为两层:基础设施层(服务延迟、GPU 利用率、内存溢出)和模型层(数据漂移、概念漂移、预测分布偏移)。数据漂移(Data Drift)指的是模型上线后,输入数据的统计分布与训练时出现偏差,比如用户行为模式随季节变化;概念漂移(Concept Drift)则指输入-输出的潜在关系本身发生了变化,例如金融欺诈模式随监管政策更迭而演变。常用的检测方法包括 PSI(Population Stability Index)、KS 检验(Kolmogorov–Smirnov Test)以及特征重要性监控。工具层面,Evidently AI、Whylogs、Arize 是目前较主流的 ML 监控开源/商业方案,面试中能提及具体方案并解释其设计权衡,会显著加分。
分布式系统与 GPU / 推理基础设施
随着模型规模增大,分布式训练、GPU 资源调度、推理加速(如量化、批处理优化)成为高阶 MLOps 的核心竞争力。这也是缺口中最难在短期内补齐的部分。
他真正想要的答案:如何快速切入
这位工程师明确表示,不愿意花 6–12 个月闭门学习后再投简历,而是希望「边面试边补缺口」。他抛出了四个极具针对性的问题:
- 以这样的背景,最大的简历短板是什么?
- 应该直接瞄准 MLOps / ML Platform 岗位,还是先进入一家 ML 为核心的公司做后端 / 数据 / 平台工程?
- 哪些技能会在面试中出现、却不会写在职位描述里?
- 如果想尽快跳槽,接下来 2–3 个月应该聚焦什么?
他特别强调,希望听到从 SWE、后端、DevOps 或数据工程转型而来的人的经验,而非一开始就做 MLOps 的人。这个限定条件很聪明——同路人的建议更具可迁移性。
给同类转型者的现实建议
虽然原帖是一个提问,但结合其背景,可以提炼出几条对广大转型者普遍适用的思路。
先投简历,用项目补缺口。 他端到端的 ML 编排项目已经是很强的敲门砖,与其等到「准备好」再投,不如即刻启动面试流程,用真实面试反馈来精准定位缺口,比盲目刷课效率高得多。
云平台是最该优先补的短板。 在五个缺口中,AWS 的投入产出比最高。它既是面试高频点,又能在短期内通过实操(把现有项目部署到 AWS)快速补齐,顺带还能覆盖模型服务与基础设施的一部分实践。
面试中隐藏的考点往往是「系统设计 + 失败处理」。 职位描述通常只列工具名,但面试官真正想看的是:你如何设计一个可扩展、可回滚、可监控的 ML 系统;当模型上线后精度掉了、数据管道断了,你怎么排查。这些场景化能力才是区分资深候选人的关键。
路径选择取决于目标公司的成熟度。 对于 ML 已经是核心业务、平台相对成熟的公司,直接投 MLOps / ML Platform 岗位并无不妥;而如果担心竞争激烈,先以后端 / 平台工程身份进入 ML 驱动的公司,再内部转岗,也是一条稳妥路径。
这位工程师的案例代表了 AI 工程化浪潮下一个典型群体:他们有扎实的软件工程底子,缺的只是 ML 基础设施这最后一块拼图。对于这类人来说,转型门槛其实比想象中低——关键是把已有的 Kubernetes、数据管道、CI/CD 能力,重新组织成一套「面向 ML 生命周期」的叙事。
相关推荐
Kimi K3.1 Pro跑分曝光:14项测试6项第一,编程直追Opus
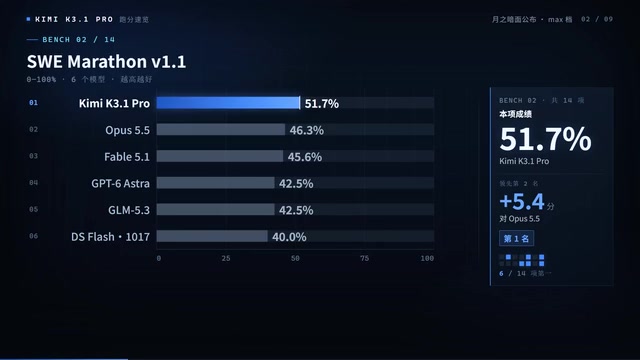
Kimi K3.1 Pro跑分公布:14项测试6项第一,场任务编程51.7超Opus,终端实战65.7仅差0.7分,幻觉率从23.4%降至8.3%,高速版支持百万上下文并计划开放权重。

谷歌Agent Compute Engine:每个Agent一个microVM
谷歌Agent Compute Engine为每个AI Agent分配独立microVM且不存凭证,本文解析其隔离设计与凭证管理思路,梳理已公开与未公开细节,并给出构建者可立即借鉴的三条实践。

付费AI写作研究谁最强?Reddit用户激辩ChatGPT与Gemini
Reddit用户热议付费AI聊天机器人写作研究能力:资深写作者发现免费Gemini输出胜过付费ChatGPT,社区讨论聚焦写作质量、研究场景偏好及提示词工作流,揭示免费与付费边界模糊下的工具选择策略。