自托管LangGraph智能体评估工具:让评判者接受现实检验

一个开源Agent评估工具,核心创新是给LLM评判者本身打分,揭示"评估体系烂掉"这一行业痛点。
一位开发者因团队的LangGraph客服Agent评估流程形同虚设——测试集无人维护、LLM judge给所有输出打7-8分、回归问题靠客户发现——而构建了开源工具AgentX-Trace-Eval。该工具采用单一二进制+SQLite的极简自托管架构,通过OTel或Python SDK收集真实运行追踪并转化为测试用例,最核心的设计是用用户差评等现实信号来反向验证LLM judge的可信度,从而区分"是Agent坏了还是评判者失灵了"。作者亲历一个`[:400]`截断bug导致评分从1.86飙升到10的案例,生动说明问题常出在评估管道本身。文章围绕三个行业真问题展开:评估集是否上线后腐烂、LLM-as-judge是否值得、自动化提示词优化循环是否可信,引发社区对"谁来评判评判者"这一命题的深层反思。
当评估体系自己先烂掉
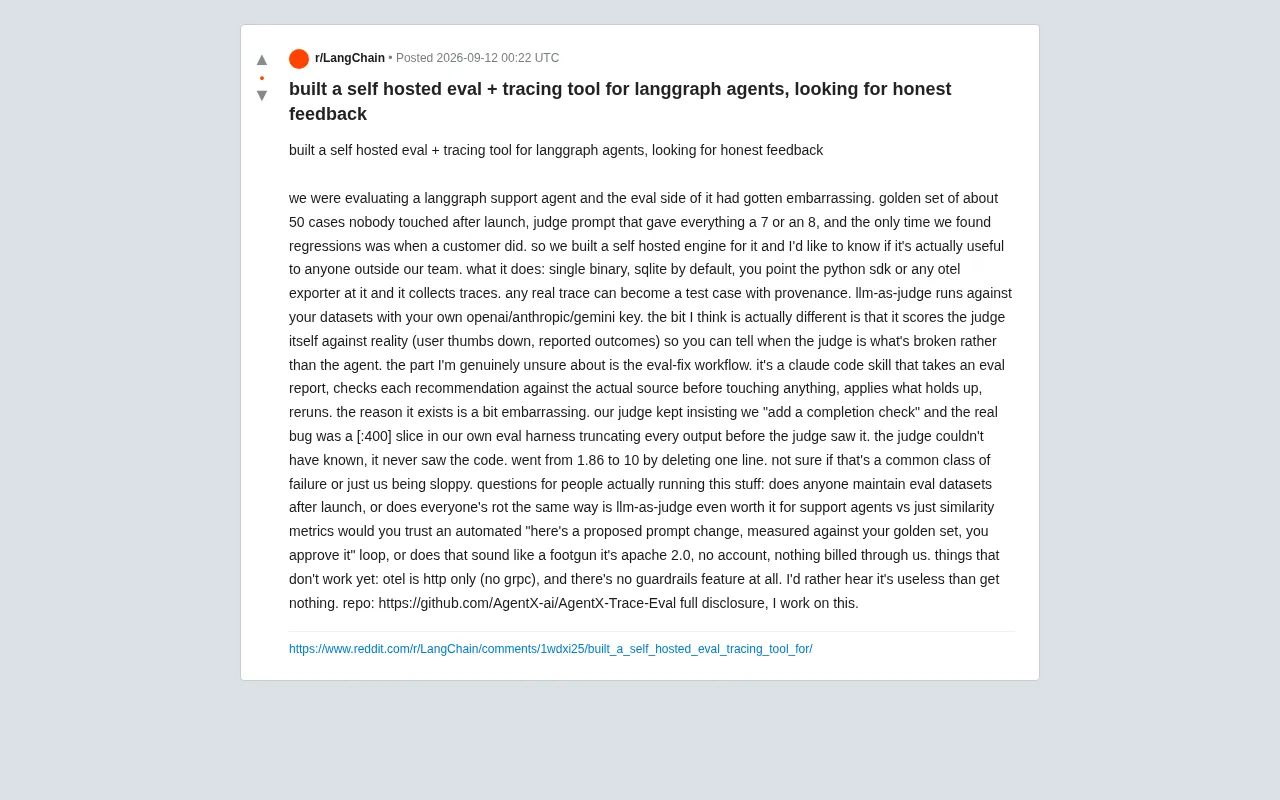
一位开发者在 Reddit 上分享了自己构建的开源工具 AgentX-Trace-Eval,起因是他们团队在评估一个基于 LangGraph 的客服智能体时,发现整套评估流程已经"尴尬到无法直视"。
问题具体表现在三个层面:一个约 50 条案例的黄金测试集(golden set)在上线后就无人问津,逐渐失去参考价值;作为评判者的 LLM judge 提示词给几乎所有输出都打 7 分或 8 分,失去区分度;而真正发现回归问题(regression)的时刻,往往是客户先撞上了 bug。
这是许多 AI Agent 团队都会遇到的隐痛——评估基础设施本身缺乏维护和验证,最终变成一种自我安慰式的摆设。作者坦言,与其得不到任何反馈,他宁愿听到"这东西没用"的直接批评。
工具做了什么
从技术架构上看,这个工具走的是极简自托管路线:单一二进制文件,默认使用 SQLite 存储,用户只需将 Python SDK 或任意 OpenTelemetry(OTel)导出器指向它,即可开始收集追踪数据(traces)。
核心功能链条是这样的:任何真实的运行追踪都可以带着来源信息(provenance)转化为测试用例;LLM-as-judge 使用用户自己的 OpenAI / Anthropic / Gemini API key 针对数据集运行评估。整个方案采用 Apache 2.0 许可证,无需注册账号,不通过作者方计费。
作者认为最有差异化的一点,是这个工具会给评判者本身打分——它把 judge 的评分与现实信号(用户的差评、实际报告的结果)做对照。这样一来,当指标出问题时,你能判断到底是 Agent 坏了,还是 judge 本身失灵了。这个设计直击了 LLM 评估中一个常被忽视的盲区:评判者不可信时,所有下游指标都失去意义。
一行代码引发的评估灾难
工具中最有争议、作者自己也最不确定的部分,是所谓的"eval-fix workflow"(评估-修复工作流)。它是一个 Claude Code skill:接收一份评估报告后,会先把每条修复建议与实际源代码核对,只应用那些经得起检验的建议,然后重新运行评估。
这个功能的诞生源于一次相当"打脸"的经历。他们的 judge 反复坚持要"添加一个完成度检查(completion check)",但真正的 bug 是评估框架自己代码里的一个 [:400] 切片操作——它在 judge 看到输出之前就把每条输出截断了。judge 根本无从知晓这一点,因为它从未看过代码本身。
结果戏剧性十足:删掉这一行代码后,评分从 1.86 直接飙升到 10。这个案例生动说明了一类容易被忽略的失败模式——问题可能出在评估管道(eval harness)本身,而非被评估的模型或 Agent。让自动化流程去核对建议与源码的一致性,正是为了拦截这类"评判者看不见真相"的情况。
抛给社区的三个真问题
作者没有把帖子写成产品广告,而是抛出了几个诚实的问题,值得每个做 Agent 评估的团队思考:
第一,上线后还有人维护评估数据集吗? 还是说大家的测试集都一样,随着时间无人问津地腐烂(rot)?这几乎是行业通病——评估集在项目初期精心构建,随后被彻底遗忘。
第二,对客服类 Agent 来说,LLM-as-judge 真的比相似度指标更值得用吗? 这触及了评估方法论的成本收益权衡:LLM 评判更灵活但更贵、更不稳定;相似度指标更廉价但可能过于机械。
第三,你会信任一个自动化的"提议提示词修改—对照黄金集测量—请你批准"的闭环吗? 还是说这听起来就像一把会走火的枪(footgun)?这是对"AI 自动优化 AI"这一趋势的直接叩问——在人类保留最终批准权的前提下,这种半自动优化循环究竟是效率利器还是隐患。
当前局限与定位
作者对工具的不成熟之处毫不隐瞒:OTel 目前仅支持 HTTP,尚不支持 gRPC;完全没有 guardrails(护栏)功能。他也全程披露了自己是该项目的开发者,代码仓库地址为 GitHub: AgentX-ai/AgentX-Trace-Eval。
从整体来看,这个项目的价值不仅在于工具本身,更在于它提出的问题清单,反映出 LLM Agent 工程化落地过程中一个被长期低估的环节:评估体系需要像被评估对象一样接受持续审视。当越来越多团队把 Agent 推向生产环境,"谁来评判评判者"会成为一个绕不开的命题。
对于正在运营 LangGraph 或其他框架 Agent 的团队,这类自托管、无账号绑定、开源可控的评估工具,至少提供了一个低门槛的实验起点。至于那个自动修复循环是否是好主意,恐怕真得靠社区在实践中给出答案。
相关推荐

34款AI编程助手混战终端,如何避免选错?
34款AI编程助手涌入终端,Orca工具支持多代理并行。本文分析淘金热背后的整合趋势、多代理并行的成本陷阱,以及如何保持代理中立的工作流,避免选错工具。

Gemini CLI实战:终端里的AI编程Agent
深入解析Gemini CLI:从安装认证到实战构建任务管理应用,涵盖计划模式、自动调试、GEMINI.md上下文持久化与token成本统计,帮助开发者用终端AI Agent提升编码效率。

Open Design:免费开源版Claude Design,激活你的编程智能体
Open Design 是一款免费开源的 Claude Design 替代品,本地运行,内置 250+ 设计技能,自动检测 16 种编程智能体,支持原型、幻灯片、移动端界面等设计任务。