#对齐
共 3 篇相关文章

·5 分钟
WRDO:用加权拒绝方向优化突破大模型安全对齐
WRDO提出加权拒绝方向优化,用学习到的聚合权重组合逐提示拒绝方向,在多个开放权重模型上优于单一方向干预,并可用于恢复被移除的对齐行为。
阅读全文 →

·8 分钟
蒸馏的隐性代价:教师行为泄漏与奖励模型超越
蒸馏不仅传递能力,还会泄漏教师的安全行为倾向;但精心设计的在线策略蒸馏能让奖励模型超越专家教师。本文解析 Imprinting、RM-OPD、CleanRM、Apertus 1.5 与 UltraBERT 的最新发现与工程实践。
阅读全文 →
 深度解读
·6 分钟
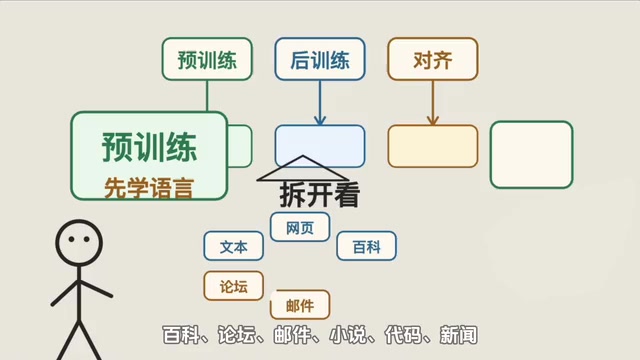
AI训练的三个阶段:预训练、后训练与对齐详解
深入解析AI大语言模型训练的三个关键阶段:预训练学语言、后训练学做事、对齐学分寸。用新员工培养的类比,帮你理解ChatGPT等AI的能力边界,搞懂AI幻觉的根本原因。
阅读全文 →