#显存优化
共 9 篇相关文章

35GB量化模型为何撑爆80GB GPU?KV Cache显存真相
为什么35GB的4-bit量化LLM仍会撑爆80GB显卡?本文拆解推理显存的四大组成,给出KV Cache精确计算公式,对比GQA与DeepSeek MLA的显存差异,并提供FP8 KV Cache等生产级防OOM方案。

单张RTX显卡同时跑Ollama与ComfyUI不爆显存的实战指南
如何在单张16GB RTX显卡上同时运行Ollama本地大模型推理与ComfyUI图像生成而不爆显存?本文详解显存预算、时间与优先级调度、静态/动态分区、模型量化选择、队列管理与监控排障的完整实战方案。
百万级上下文窗口的工程挑战:VRAM碎片与动态KV缓存
百万级上下文窗口对大模型推理提出严峻的显存挑战。本文解析VRAM碎片化与动态KV缓存两大工程难题,探讨分页式缓存、显存池、分层卸载等架构应对策略。

Kijai更新MiniMax-H3 VAE:显存占用更低,画质不打折
Kijai更新了MiniMax-H3(MH3)的int8量化VAE,实测在RTX 3060 12GB上显存占用更低且画质不退化,可生成1MP/10秒和0.7MP/15秒视频。本文解读更新要点、实测数据与对消费级显卡用户的意义。
KV Cache为何撑爆显存?大模型推理优化全解析
长对话导致显存爆炸?本文深入解析KV Cache如何存储历史信息加速推理,为何会撑爆显存,以及PagedAttention、FlashAttention、KV量化等主流优化方案,附大模型面试满分回答模板。
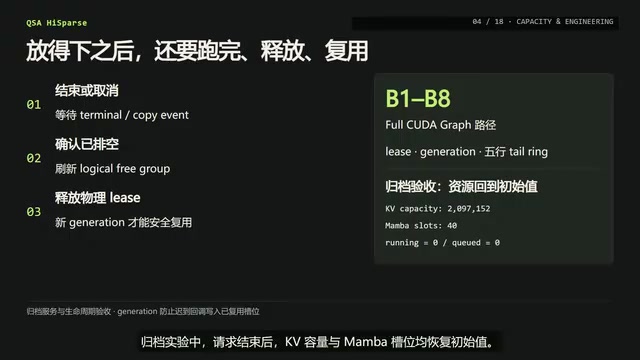
双卡RTX4090跑通Qwen3-Next:8并发满血长上下文实测
用两张48GB RTX 4090跑通Qwen3-Next的8并发长上下文推理,通过KV热缓存卸载省下约84%显存。实测涵盖显存账本、快路径吞吐、真实终端记录与多代理任务交付,附完整数据与免责说明。
 教程攻略
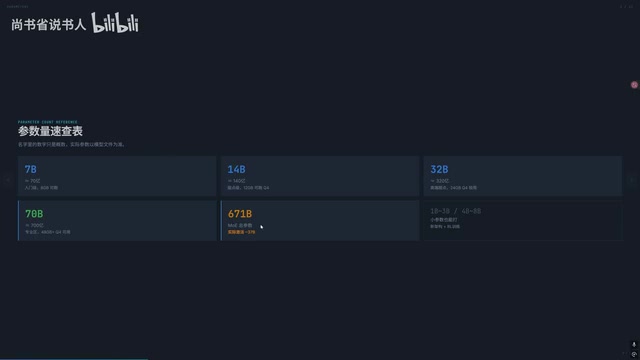
大模型命名规则解析:参数量、量化格式与显存需求速查
系统拆解大模型命名规则,解释32B参数量、AWQ/GGUF量化格式的含义,提供4-bit量化显存估算公式与速查表,涵盖MOE模型显存陷阱、IMatrix量化推荐及按显存档位的模型选择建议。
 产品体验
Unsloth:显存优化80%,本地微调大模型的最佳开源工具
Unsloth是GitHub 63K+ Star的开源大模型训练工具,支持Gemma 4、Qwen 3、DeepSeek等主流模型。通过显存优化降低50%-80%显存占用,让RTX 4090也能微调7B模型,提供Web UI一键训练。
 产品体验
Unsloth:单卡微调大模型,显存省70%的开源神器
Unsloth 是 GitHub 63K+ Star 的开源大模型微调工具,支持 Gemma 4、Qwen 3、DeepSeek 等主流模型。通过显存优化技术,单张 RTX 3090 即可完成微调,训练速度提升2-5倍,附 Web UI 图形界面,零门槛上手。