#本地训练
共 6 篇相关文章
 科技前沿
·5 分钟
单卡12GB训练本地VLA模型:用极简注意力视觉编码器替代预训练CNN
一位开发者分享在12GB显存3060上从零训练的本地VLA模型:用状态导向注意力替代预训练视觉编码器,以768×768循环状态处理原始像素,推理时学习新形状与名字的关联。文章拆解其架构、任务设计与训练中暴露的梯度爆炸和教师矛盾问题。
阅读全文 →

·8 分钟
消费级GPU训练Jev决策模型:延迟降19倍的System 1实践
实测用24GB消费级GPU训练Qwen3.5决策模型,复刻微软Decision Head架构:训练仅15分钟、峰值VRAM 7.95GB,推論延迟从3679ms降至191ms,ECE校准降至0.036,附完整A/B对照与多任务压测数据。
阅读全文 →
 产品体验
·7 分钟
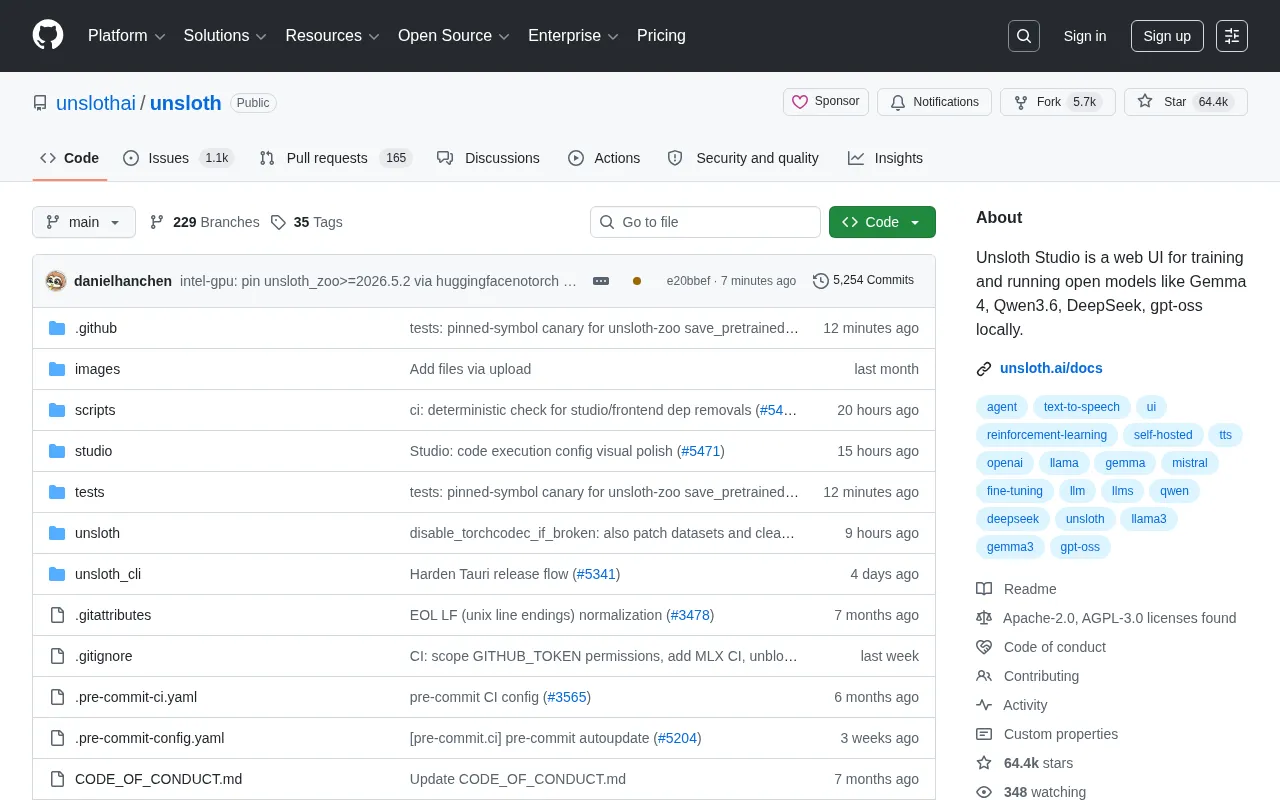
Unsloth:显存优化80%,本地微调大模型的最佳开源工具
Unsloth是GitHub 63K+ Star的开源大模型训练工具,支持Gemma 4、Qwen 3、DeepSeek等主流模型。通过显存优化降低50%-80%显存占用,让RTX 4090也能微调7B模型,提供Web UI一键训练。
阅读全文 →
 教程攻略
·7 分钟
Unsloth教程:本地微调大模型省显存加速训练指南
详解Unsloth开源工具如何在本地高效微调大模型,支持Gemma 4、Qwen3、DeepSeek等主流模型,通过LoRA优化显著降低显存占用,提供Web UI界面降低训练门槛,适合个人开发者和中小团队使用。
阅读全文 →
 产品体验
·13 分钟
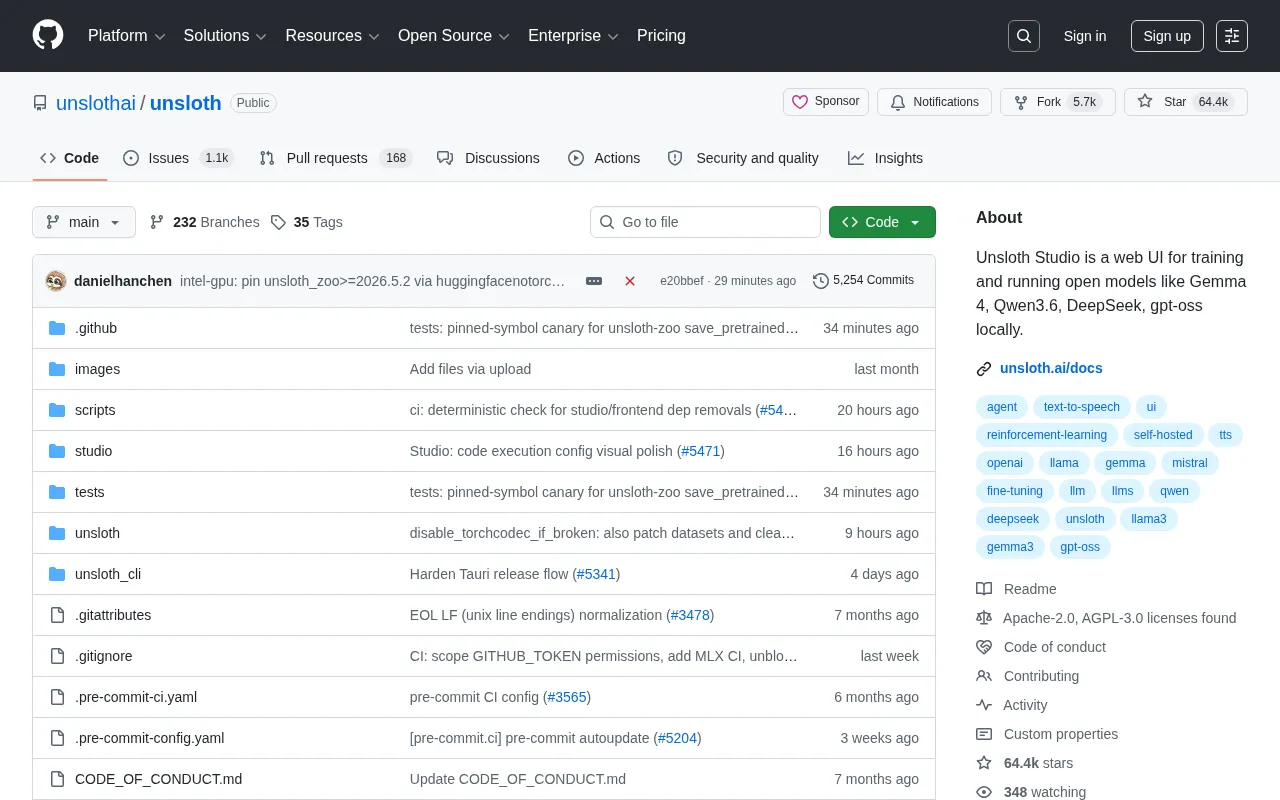
Unsloth:本地微调大模型速度提升5倍的开源神器
Unsloth 是 GitHub 63000+ Star 的开源大模型训练工具,支持 Gemma 4、Qwen3、DeepSeek 等主流模型的本地微调,提供 Web UI 界面、显存优化和 2-5 倍训练加速,让消费级 GPU 也能跑通模型微调全流程。
阅读全文 →
 产品体验
·7 分钟
Unsloth:免费本地训练大模型神器,6万星开源项目详解
Unsloth是GitHub上6.3万星的开源大模型本地训练工具,支持Gemma 4、Qwen 3、DeepSeek等主流模型微调,提供Web UI图形界面,大幅降低LLM微调门槛。本文详解其核心功能、技术优势与适用场景。
阅读全文 →