#机制可解释性
共 5 篇相关文章

·5 分钟
机制可解释性如何为AI安全兜底:一篇综述的深度拆解
一篇聚焦AI安全的机制可解释性综述拆解:对比机制证据与行为评估,梳理特征、多义性、电路等基础概念与特征提取、电路发现、因果验证等方法,并分析知识编辑、引导、监控等安全应用及其局限。
阅读全文 →

·4 分钟
KANSteer:打破线性表征假设的文生图非线性引导
arXiv 新论文 KANSteer 挑战线性表征假设,利用柯尔莫哥洛夫-阿诺德网络(KAN)将文生图模型的概念遍历建模为曲线,实现比线性引导更平滑精细的中间状态生成控制。
阅读全文 →

·5 分钟
表征简洁≠电路更小:对抗训练揭示可解释性的阈值分野
一篇 arXiv 新论文通过对抗训练受控实验发现:模型表征越简洁(更易被稀疏自编码器分解)并不总意味着因果电路越小,两者的关系依赖忠实度阈值,仅在高忠实度区间才同步。
阅读全文 →
·5 分钟
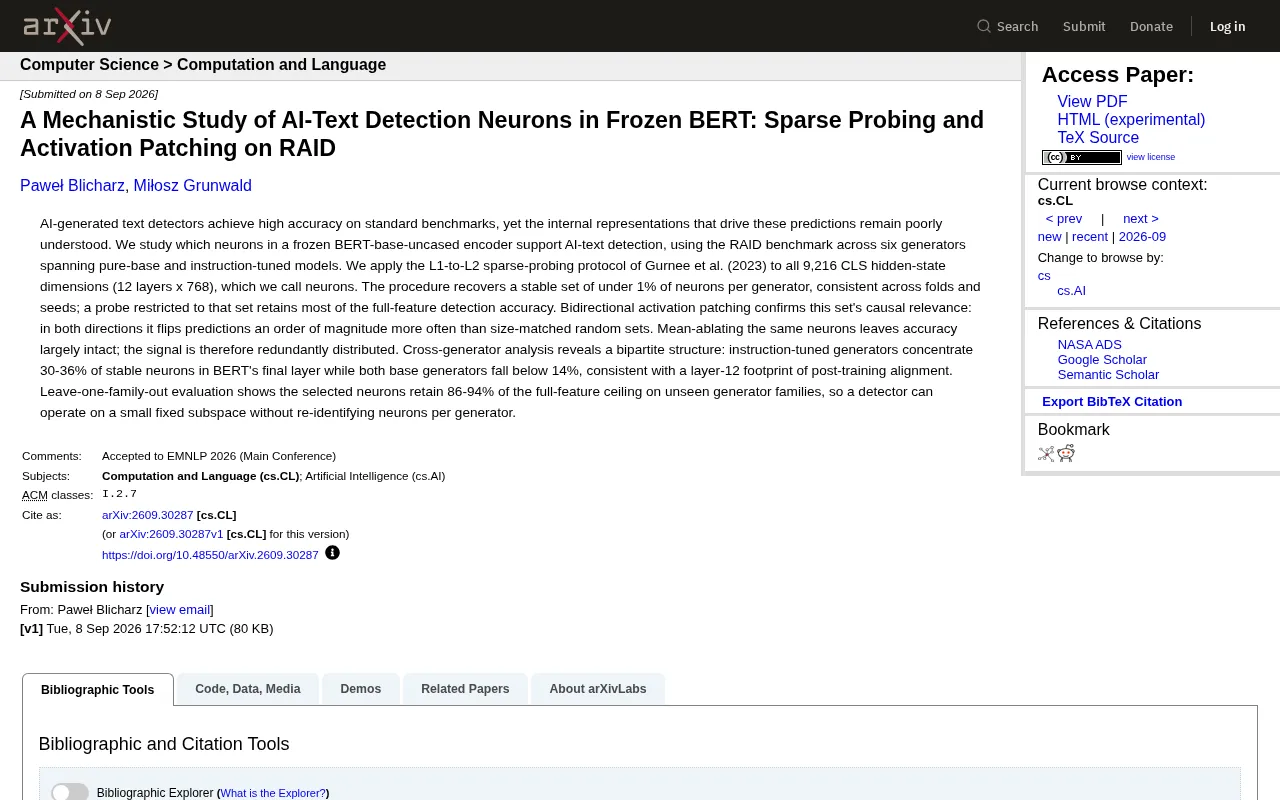
冻结BERT中的AI文本检测神经元:稀疏探测与激活修补揭秘
一项arXiv最新研究通过稀疏探测和激活修补,在冻结BERT编码器中定位驱动AI文本检测的关键神经元,发现不到1%的神经元即可支撑检测,并揭示指令微调模型在BERT第12层留下的独特足迹。
阅读全文 →
·2 分钟
解读Transformer电路的数学框架:机制可解释性的奠基之作
深入解读Anthropic的《A Mathematical Framework for Transformer Circuits》,介绍QK/OV电路、残差流与归纳头等核心概念,理解Transformer机制可解释性的奠基性研究。
阅读全文 →