#缓存优化
共 5 篇相关文章
·5 分钟
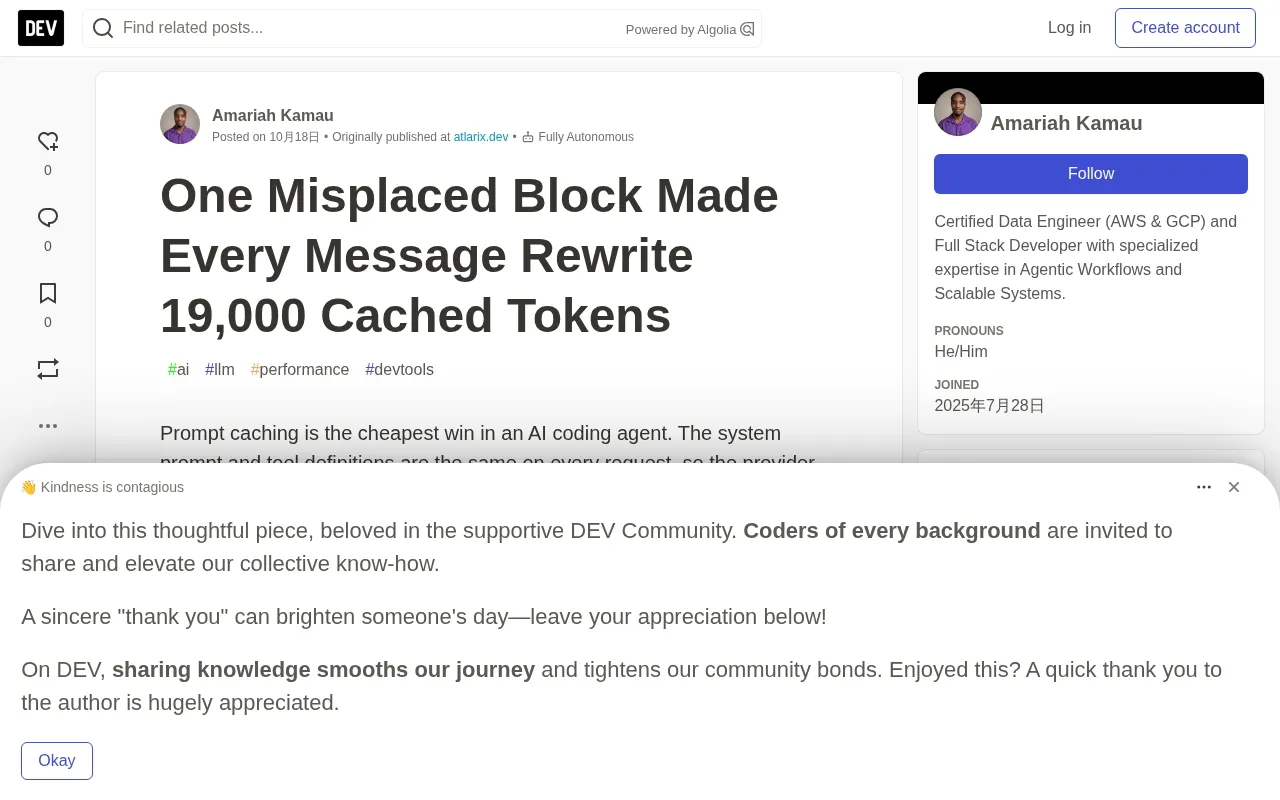
一个错位的模块,让每条消息重写19000个缓存Token
Atlarix团队发现Build模式下每条消息重写19000个缓存Token的bug,根源是动态请求块错位在缓存断点之前。本文详解缓存机制、问题发现过程、修复方案及前后性能对比,并总结出'变化内容必须在断点之后'的关键教训。
阅读全文 →

·4 分钟
Claude Code空闲自动压缩:机制、缓存计算与关闭方法
Claude Code 2.1.299版本在会话超过200K令牌且空闲约54分钟后自动压缩。本文解释触发机制、缓存成本逻辑,并提供关闭该功能的设置方法,帮助开发者平衡上下文完整性与费用。
阅读全文 →

·8 分钟
Opus 5.5 Fast Mode 正式转正:双倍价格与缓存陷阱
Anthropic 将 Opus 5.5 Fast Mode 移出研究预览,无需申请即可使用,但价格翻倍至 $8/$40 每百万 token,且切换速度会使提示缓存失效,本文详解定价、缓存陷阱与限流降级策略。
阅读全文 →

·7 分钟
MIT作者打造2MB模型:跑进CPU L3缓存,单核3405 tok/s
开发者用1.9MB小模型跑进CPU L3缓存,在60美元Ryzen单核上达3405 tok/s,附evict_read对照实验与完整可复现流水线,MIT开源。
阅读全文 →
·3 分钟
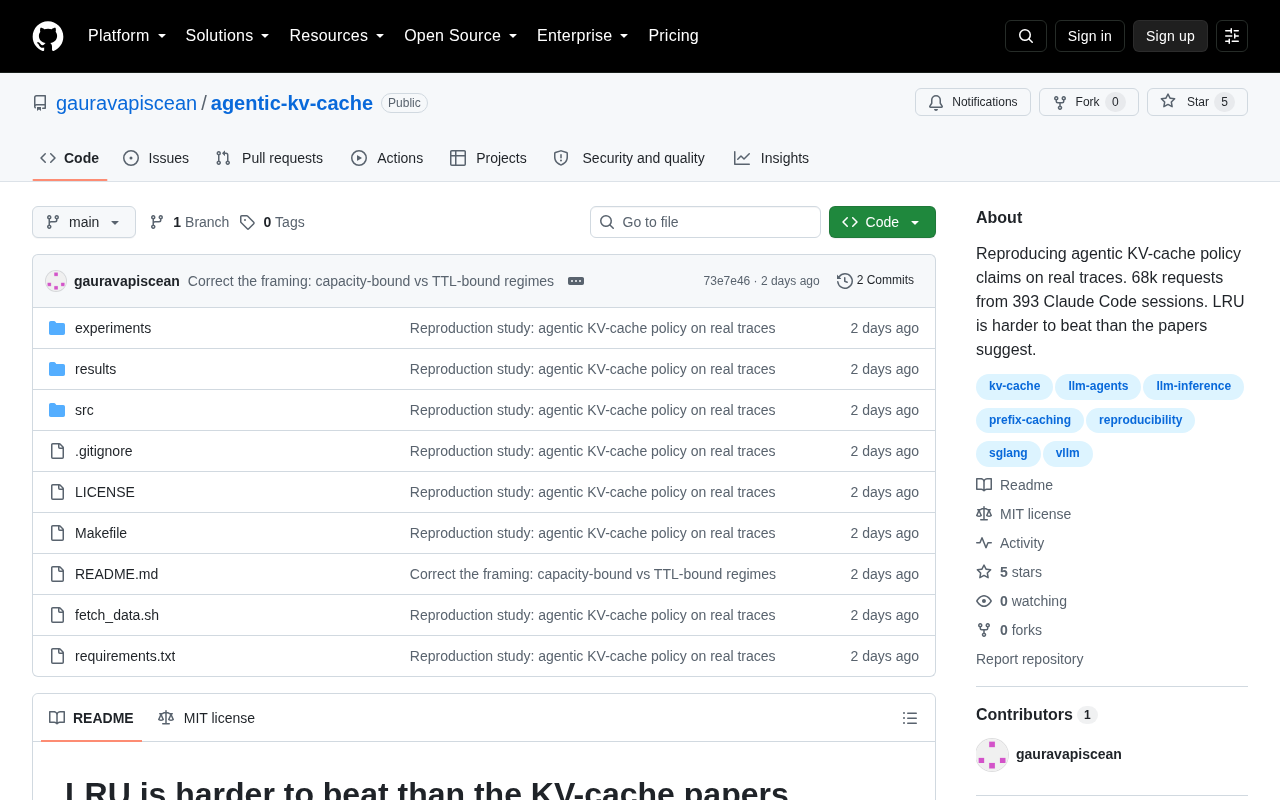
LRU缓存淘汰算法为何难以被超越:KV-Cache论文的盲点
一篇Hacker News讨论指出,经典LRU缓存淘汰算法远比众多KV-Cache优化论文所暗示的更难被超越。本文剖析基准测试偏差、隐藏工程成本等问题,为大模型推理缓存优化提供审慎视角。
阅读全文 →