#网页抓取
共 8 篇相关文章

Scrapling:全能Python网页抓取框架,单请求到大规模爬取
Scrapling是一个GitHub上热门的Python网页抓取框架,支持从单个请求到大规模爬取,拥有92k+星标。了解其核心功能、社区生态和适用场景。

CleanWeb MCP服务器:网页抓取省87%Token并防提示注入
Reddit开发者展示CleanWeb MCP服务器,可将网页抓取Token噪音削减87%,并为Claude Desktop和Cursor提供提示注入防护。本文解析其机制、集成方式与待验证的局限。
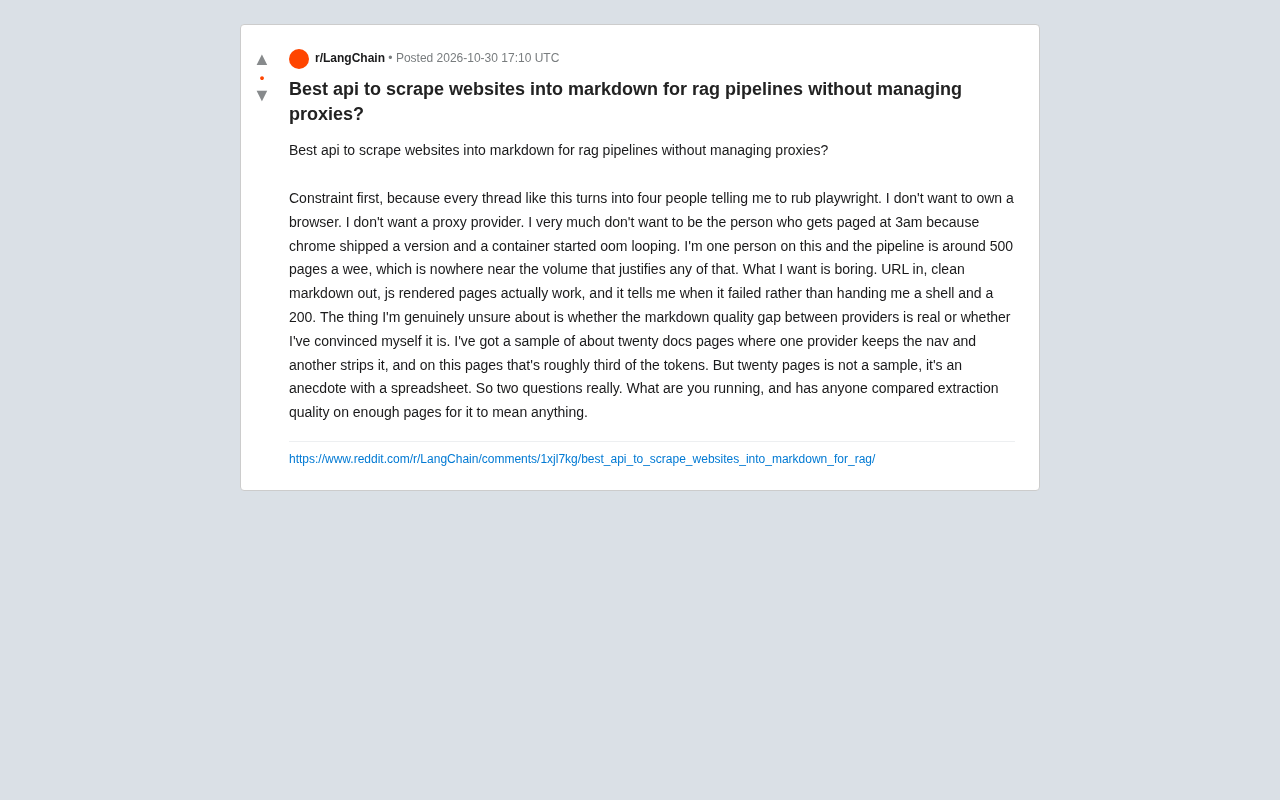
免代理网页转Markdown API:RAG管道实战选型
探讨RAG管道中免代理网页转Markdown API的选型:对比自建与托管方案的成本,分析Markdown提取质量差距,提供基于JS渲染、失败语义和输出一致性的实用评估清单。

用MCP服务器为AI编程助手接入实时网络访问
介绍如何通过MCP服务器为Claude Code、Cursor等AI编程助手接入实时网页抓取能力,涵盖XCrawl MCP工具、托管与本地两种配置方式,以及控制token消耗的实用技巧。
网页转JSON工具:为AI Agent提供带证据的结构化数据
Apify 推出 Webpage to JSON for AI Agents 工具,输入 URL 和自然语言指令即可返回带原文证据引用的结构化 JSON,支持 JSON Schema、列表模式和 MCP 集成,每页 0.03 美元起。

LangChain Agent 网页抓取:自建方案 vs 托管 API 实战对比
LangChain Agent 网页抓取该自建还是用托管 API?本文对比 Playwright/bs4 自建方案与 Firecrawl、context.dev 托管服务,分析成本、反爬维护与适用场景,帮你找到切换拐点。
 产品体验
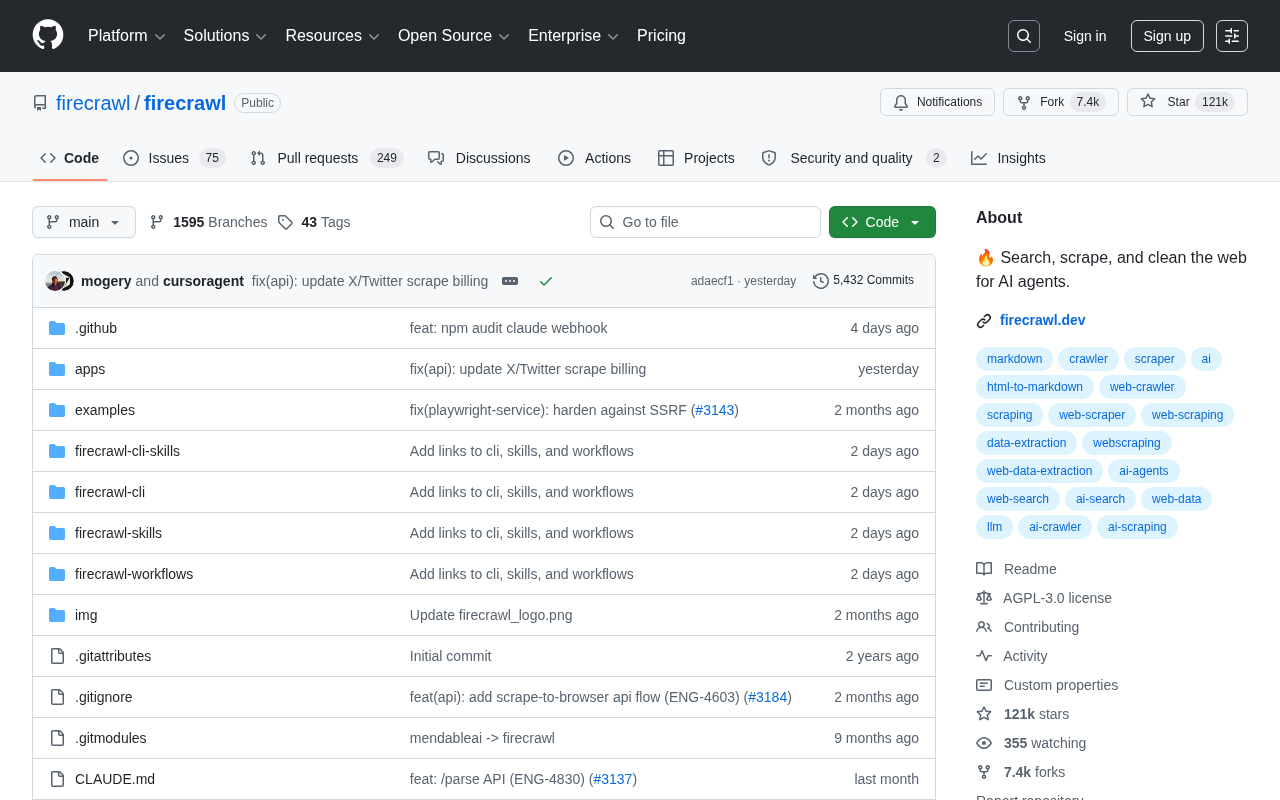
Firecrawl:12万Star的AI网页抓取神器,RAG开发必备
深度解析Firecrawl开源项目:专为AI Agent设计的网页搜索、抓取与数据清洗工具,支持JavaScript渲染、智能内容提取和Markdown输出,是构建RAG系统和AI自动化应用的核心基础设施。
 产品体验
Agent-Reach:零API费用让AI Agent浏览全网的开源工具
Agent-Reach是一款开源Python工具,支持Twitter、Reddit、YouTube、B站、小红书等中外平台的免费数据抓取,一行CLI命令即可集成到LangChain等AI Agent框架中,已获GitHub近19000 Star。