#LLM测试
共 4 篇相关文章

·5 分钟
免费模型可信吗?先跑个A/A测试再下结论
免费模型评测前先跑A/A测试:用同一提示词重复调用,测量模型自一致性(modal_share),区分采样噪声与真实回归,避免单次运行造成的错误判断。附Python探针脚本与分诊表。
阅读全文 →

·7 分钟
AI Agent每次回答都不同?用约束测试取代输出匹配
AI Agent每次输出都不同,传统单元测试彻底失效。本文提出用行为约束取代输出匹配,通过结构契约、护栏断言和LLM-as-Judge三层测试金字塔,让非确定性Agent变得可部署、可衡量。
阅读全文 →

·15 分钟
测试调用大模型的代码:用 pytest Mock OpenAI 客户端的实战指南
如何测试调用大语言模型的代码?本文详解如何在 pytest 中 Mock OpenAI 客户端,构建快速、确定、免费的单元测试,涵盖 fake 客户端、重试、JSON 解析、流式响应与线上冒烟测试的完整实战方案。
阅读全文 →
·4 分钟
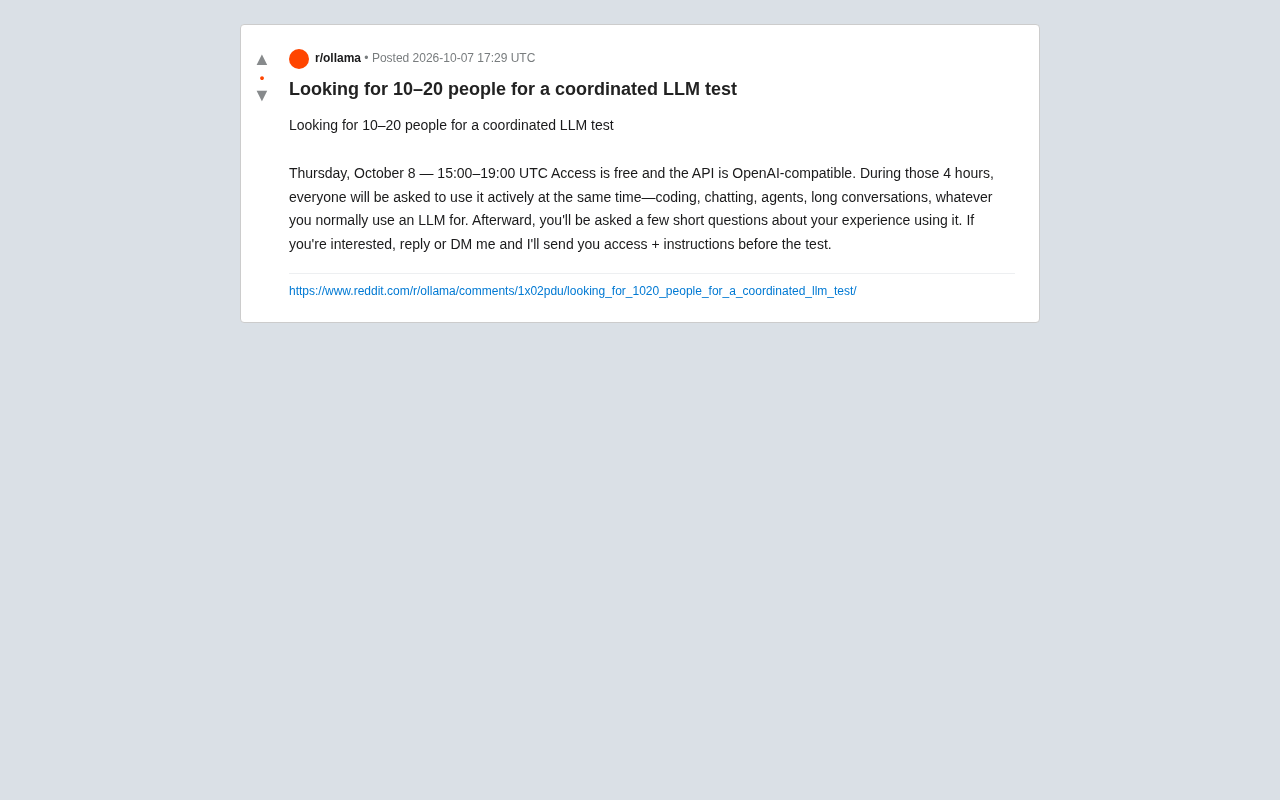
一场协调式LLM压力测试招募:4小时并发实测意味着什么
一则Reddit招募帖寻找10-20人参与4小时协调式LLM并发测试,采用OpenAI兼容接口。本文解析这类同时集中测试背后的并发压力验证逻辑、技术信号及参与注意事项。
阅读全文 →