#NPU
共 4 篇相关文章

·6 分钟
无GPU训练大模型:推理专用NPU跑通反向传播
VIDRAFT在推理专用NPU上从零预训练了46M参数语言模型VKORE-46M-NPU,损失轨迹与GPU训练相关系数达0.99。本文解析其工程方法、技术限制与实际意义。
阅读全文 →
·5 分钟
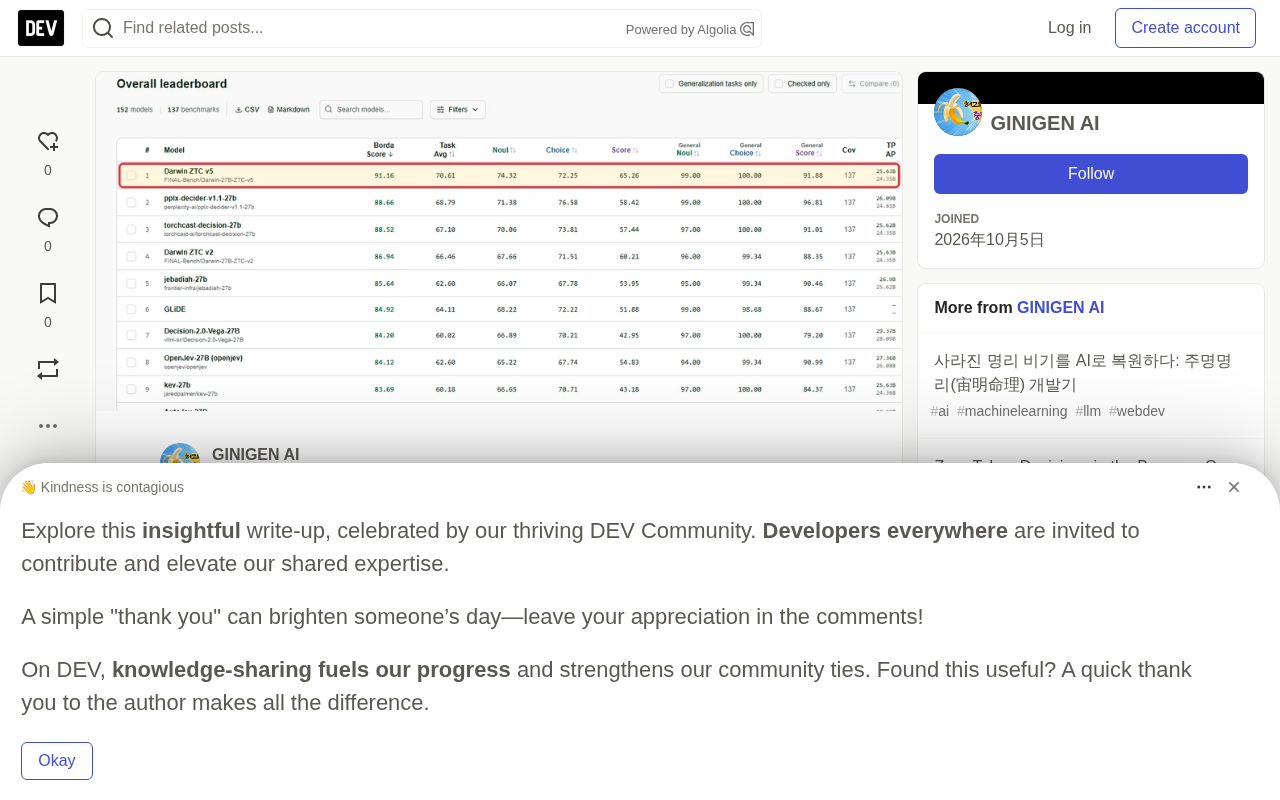
VKORE:让推理专用NPU跑起AI训练
VIDRAFT 推出 VKORE 软件加速层,让推理专用 NPU 无需换硬件即可支持 AI 训练与推理。单用户推理吞吐提升 3.8 倍,训练吞吐达 CPU 基线约 170 倍,硬件无关且已提交 16 项专利。
阅读全文 →
·5 分钟
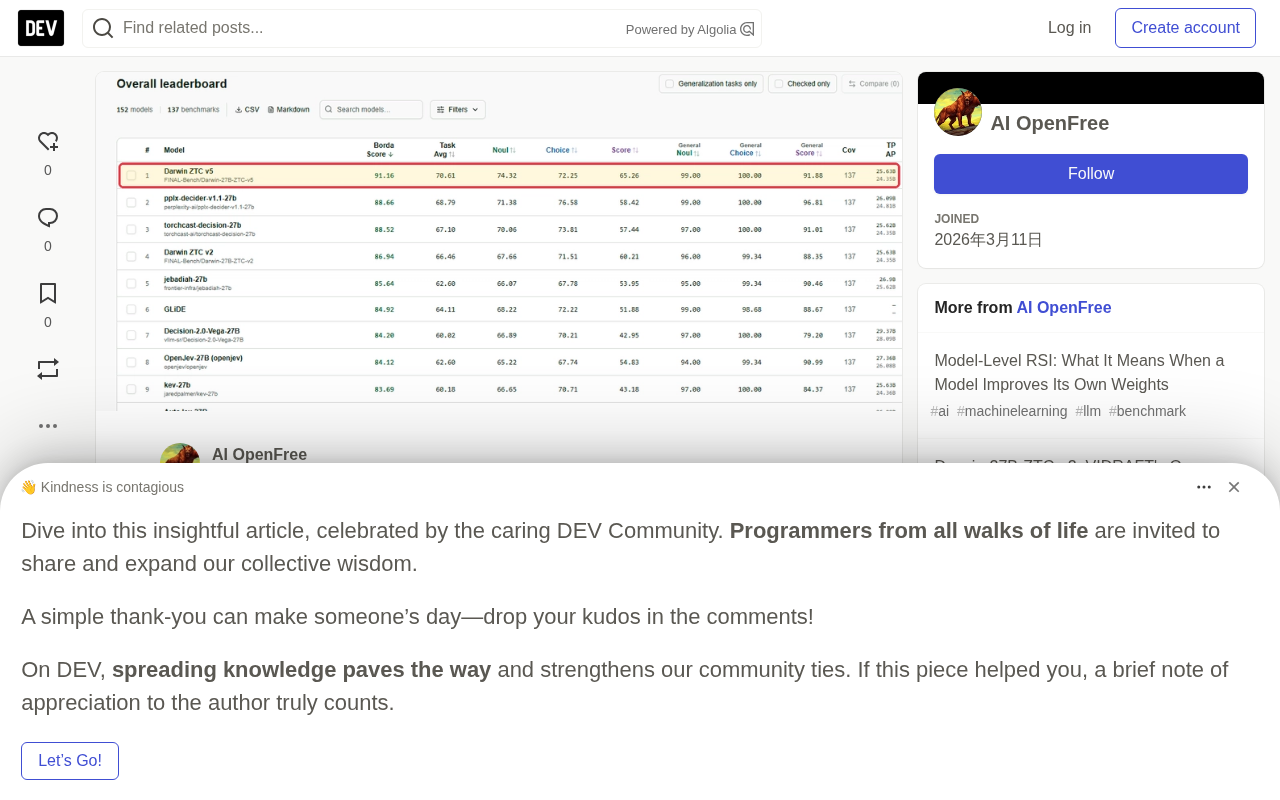
NPU也能预训练:VKORE让国产芯片吞吐达H100的170%
VKORE软件加速层让NPU支持预训练,实测吞吐达单块H100的170%、B200的75%,推理提升3.8倍,为主权算力提供不依赖Nvidia的完整训练闭环方案。
阅读全文 →
·6 分钟
推理专用NPU也能训练Transformer:VKORE实现0.9999精度对齐
VIDRAFT推出VKORE软件加速层,在不改动芯片的前提下让推理专用NPU实现Transformer LoRA训练,精度与PyTorch达0.9999对齐,推理吞吐提升4.1倍,训练速度达同服务器CPU的170倍。
阅读全文 →