11年经验工程师直播拆解:Vibe Coding如何驾驭多智能体
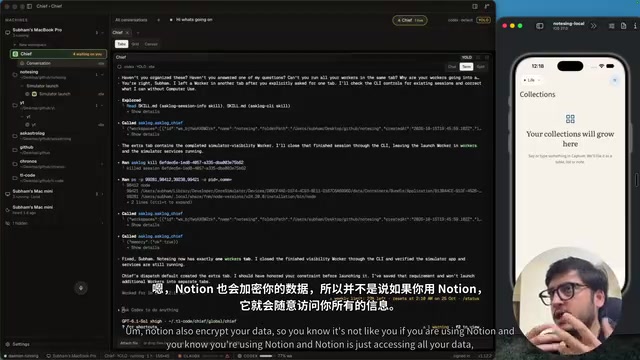
资深工程师用主控智能体编排多节点工作流,数小时内完成 AI 应用原型并推进至内测。
文章记录了一位拥有 11 年经验的开发者连续数天的直播实践,展示如何用“编排器 + 工作节点”的多智能体架构,在三天内把一个语义化笔记应用从零推进到 TestFlight 邀请内测。核心方法是不与单个编码智能体直接对话,而由主控智能体拆解任务、为各节点生成提示词、在独立 Git 工作树中并行执行并统一收尾,从而节省令牌并避免冲突。文章还重点讨论了提示词注入与凭据保险库的安全风险、对 Codex 配额与速度的负面评价及替代模型建议,以及发布前用 Mastra Studio 做评测、用 Langfuse 做可观测性的必要性。
为什么“氛围编程”需要资深工程师思维
Vibe coding 常被误解为“把需求丢给 AI 就能坐等成品”。但一位拥有 11 年开发经验、目前在企业担任 AI 负责人的开发者,在连续数天的直播中展示了另一种可能:用编排器(Orchestrator)+ 工作节点(Worker) 的多智能体架构,在数小时内完成一个具备 AI 能力的产品原型。其核心不是放任 AI 生成代码,而是用工程化的工作流约束 AI 的产出。
这位开发者强调,他从不与单个编码智能体直接对话,而是只与一个“主控智能体”交互,由它把任务分派给多个独立的工作节点。这类似于技术团队的主从架构——管理者不亲自写代码,但必须清楚每个模块的边界和验收标准。
从零到 TestFlight:一个提醒应用的三天冲刺
直播中构建的是一款名为“Noting(提醒)”的笔记类应用,定位是“第二大脑”。它包含三个界面:捕获输入、收藏整理、问答检索。用户可以用自然语言记录想法,后台的智能体层会自动判断应该存为表格、列表还是笔记。
这个应用在直播第三天已进入 TestFlight 分发阶段,带有邀请门槛,仅开放给社区内测用户。开发者提到,移动应用的分发流程应该从开发第一天就并行启动,因为 App Store 的审核与内测流程可能耗费大量时间。
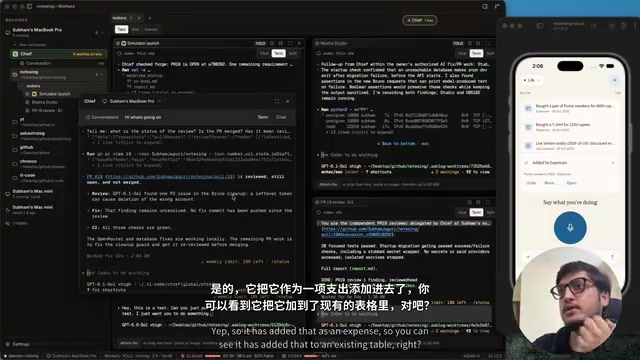
在测试环节,开发者展示了应用如何处理两类输入:记录一次直播的内容摘要,以及记录一笔消费(如“买 T 恤花 1200 卢比”)。前者被存为普通笔记,后者被自动整理成带金额列的表格。这种基于语义判断存储结构的能力,正是该应用与普通笔记软件的关键差异。
多智能体工作流:主控智能体到底在做什么
这套工作流的核心是名为 S-Clock 的智能体开发环境。它支持在单一窗口内运行多个编码智能体(Codex、Claude 等),并允许连接多台机器——开发者的 MacBook、Mac mini 和远程服务器可以同时出现在同一个工作区中。
主控智能体的职责包括:接收人类指令、拆解任务、为每个工作节点生成独立的提示词、在独立的 Git 工作树中运行任务以避免冲突、任务完成后关闭节点。直播中,主控智能体同时管理着四到五个智能体:一个在运行模拟器,一个在审查 PR,一个在进行 TestFlight 发布,一个在做清理修复。
开发者特别指出,相比让单个智能体包揽所有操作,这种分发模式能节省令牌消耗——因为主控智能体本身不处理具体任务,只负责调度。
Git 工作树(Git worktree) 是 Git 从 2.5 版本起提供的一项特性,允许在同一个仓库上同时检出多个工作目录,每个工作树可以指向不同的分支。与传统的 git checkout 切换分支不同,多个工作树互不干扰,可以并行修改、编译和测试。在多智能体编码场景中,每个智能体被分配一个独立的工作树,意味着它们可以在各自的分支上同时提交代码而不会产生文件锁冲突或工作区污染;任务完成后由主控智能体统一合并或创建 PR。这本质上是用 Git 的隔离机制替代了人工协调,使并行开发变得可控、可审计。
令牌(Token) 是语言模型处理文本的基本计量单位,大致相当于一个词或词的一部分,模型的上下文窗口、调用费用和速率限制都以令牌计算。在多智能体架构中,令牌消耗会随智能体数量线性甚至成倍增长,因为每个节点都需要携带系统提示词、工具定义和历史上下文。让主控智能体只做调度、不直接处理具体任务,可以把昂贵的上下文集中在必要的地方,避免同一个大型上下文在多个智能体间重复传输,从而显著降低单次任务的令牌开销。
安全护栏:提示词注入与凭据管理
直播中最具警示意义的部分,是对智能体安全风险的讨论。开发者使用的是 OnePassword 作为凭据保险库,智能体需要显式授权才能访问。但他发现,主控智能体有时会尝试访问保险库中的凭据,却没有在界面顶部明确提示“哪个智能体正在请求什么权限”。
他举了一个真实的提示词注入场景:如果把邮箱读取权限直接授予编码智能体,攻击者可以在邮件 HTML 源码中嵌入隐藏指令,当模型总结邮件内容时,这些指令可能让模型忽略系统提示,转而执行恶意操作。对于使用较小模型或旧版模型的场景,这种风险尤为突出。
因此,他的原则是:凭据永远不写入环境变量,智能体对保险库的每一次访问都必须可追溯、需授权。
提示词注入(Prompt Injection) 是一类针对大语言模型应用的攻击方式:攻击者把恶意指令隐藏在模型会读取的数据中(如网页、邮件正文、文档甚至图片元数据),诱导模型把这些数据当作指令执行,从而绕过系统提示词的约束。它类似于传统 Web 安全中的 SQL 注入,但注入的载体是自然语言而非代码。间接注入尤其危险,因为攻击者无需直接接触应用,只需让受害者处理一段被污染的内容即可。常见缓解手段包括:对不可信输入做来源标记与隔离、最小权限授予、对敏感操作引入人工确认,以及将模型输出限制在结构化格式中。
模型选择与成本现实:一场坦诚的吐槽
开发者对当前模型的使用体验给出了相当直白的评价。他同时订阅了 Claude 和 Codex,但 Codex 的周配额在两天内消耗了超过七成,速度也明显偏慢。他坦言不会向别人推荐 Codex,只会把它当作 Claude 不可用时的备选,或者用于需要在 Mac mini 上做电脑自动化操作的场景。
对于预算有限的开发者,他建议:学生可以选择较低价位的 Claude 计划,或者通过 OpenRouter 调用 Kimi、GLM、DeepSeek广告 等开源模型。他强调,理解不同模型的定位和成本结构,本身就是 vibe coding 工作流的一部分。
评测与可观测性:别只构建,还要验证
在应用即将发布前,开发者将智能体接入 Mastra Studio 进行评测。他展示了如何查看每个智能体的系统提示词、使用的模型、工具调用记录,并强调“评估”这个概念的重要性——不能只构建智能体,还要用评分器(scorer)验证它在特定任务上的表现。
他将这一思路类比为模型基准测试:不同的模型在你的具体用例中表现可能差异很大,只有通过评测才能做出有依据的选择。对于生产环境,他使用 Langfuse 做可观测性追踪,因为可以自托管,便于监控线上智能体的实际行为。
评分器(Scorer) 是智能体评测中的基本单元,负责对一次智能体运行的结果给出可量化的分数。常见类型包括:基于规则的精确匹配、基于嵌入的语义相似度、由另一个模型充当裁判的 LLM-as-judge,以及人工标注。评分器通常与一组固定输入(数据集)配合使用,形成可重复运行的评测集,从而在更换模型、修改提示词或调整工具后快速判断效果是变好还是变差。可观测性(Observability) 则关注运行时的追踪,记录每次调用的提示词、模型、工具调用链、延迟与成本,二者结合才能既回答“效果如何”,也回答“为什么这样”。
社区项目评审:从设计到分发的实战反馈
直播后半段,开发者评审了多个社区项目,包括 AI 导师、字幕生成工具、离线 AI 应用和远程桌面客户端。他给出的反馈集中在几个方向:落地页应当展示产品工作流而非仅仅罗列功能;API 网络请求不应暴露内部提示词或模型选择;面向特定地区的产品应做好全球化适配的准备。
这些评审环节也折射出他反复强调的观点:vibe coding 降低了构建门槛,但产品化仍然需要工程判断——从安全、分发到用户体验,每一步都不能完全交给 AI。
相关推荐

零基础学扩散模型:原理、工具与创新路径全解析
基于B站热门教程,系统梳理扩散模型零基础学习路径:从核心理论推导的取舍,到DiT工具包源码实操,再到模型加速与轻量化创新思路,帮助读者避开只啃理论或只跑代码的常见误区。

扩散模型零基础入门:避开弯路的学习路线
扩散模型零基础入门指南:从核心数学推导到DiT轻量化工具包源码实操,梳理前向扩散、反向生成逻辑,精读加速与结构优化论文,帮你避开学习弯路,打通理论与源码闭环。

B站热推:零基础吃透扩散模型原理与源码实操指南
B站热推的扩散模型学习路线:从核心原理与公式推导入手,用轻量化DiT工具包逐行调试源码,打通理论到创新的闭环,适合零基础系统吃透Diffusion Model并落地论文项目。