14K Star开源桌面端cc-haha:5个AI Agent自主分工协作
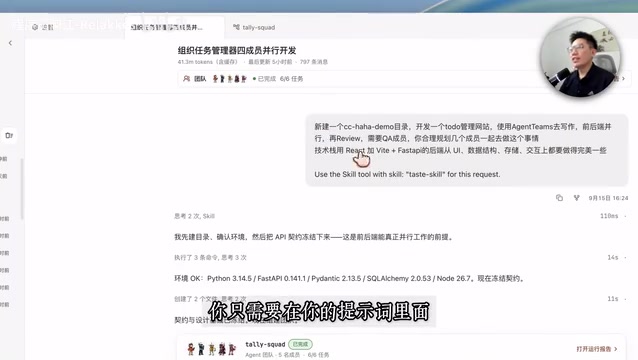
cc-haha开源项目新增Agent Teams功能,一条指令让五个AI自主分工协作完成复杂开发任务。
cc-haha 是一款拥有 14K Star 的开源 Claude Code 桌面端,其最新版本(0.6.3)引入了 Anthropic 官方实验性功能 Agent Teams 的可视化实现。用户只需在提示词中加入"使用 agent teams 协作",模型便会自动扮演"队长"角色,拆解任务、建立依赖关系图、创建多个成员 Agent 并分配工作。各成员 Agent 拥有独立上下文,通过内置通讯协议互相汇报进度,完成任务后自动领取下一项工作,形成自组织工作流。演示任务消耗约 4000 万 token,但因缓存命中率高达 99%,实际成本大幅压缩。该功能目前仍属实验阶段,更适合天然可并行的复杂开发场景,而非所有编程任务的万能解法。
一次命令,五个AI自己把活分了
传统的AI编程助手往往需要人类逐条下达指令:让它写前端、再让它写后端、然后手动安排测试。而在这个名为 cc-haha 的开源 Claude Code 桌面端里,情况变得不太一样——UP主阿江只下了一次命令,剩下的分工全部由 AI 自己完成。
据阿江的演示,五个 AI Agent 同时干活,谁写前端、谁写后端、谁做测试、谁做 code review,都不是人工逐个安排的,而是它们自己在协商分工。更有意思的是,这些 Agent 完成手上任务后,还会主动去"领"下一件事情,形成了一种自组织的工作流。
Agent Teams:队长带队的协作机制
这套机制的核心是 Anthropic 官方首次提出的实验性功能 Agent Teams。它的组织结构颇有点"团队作战"的味道:
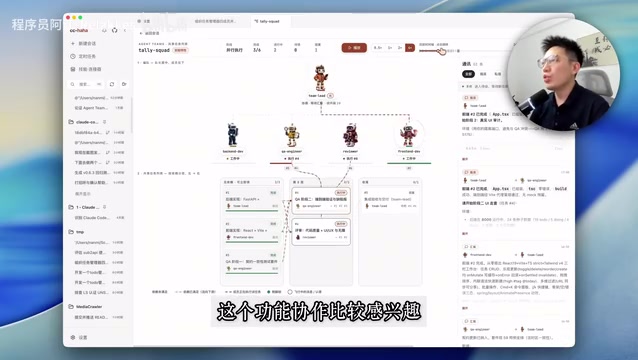
- 队长(Team Leader):负责创建团队成员,并搭建整个共享任务列表;
- 成员(Members):各自领取任务并执行,完成后打上标记,再自动去领下一个任务;
- 任务依赖关系:整个任务列表清晰呈现出哪些任务互相依赖、执行顺序如何。
更关键的是 Agent 之间存在一套通讯协议。队长会给成员下达指派、发送私信,成员则会向队长汇报进度,系统消息也在其中流转。这让多个 AI 的协作不再是黑箱,而是可以被观察和追踪的过程。
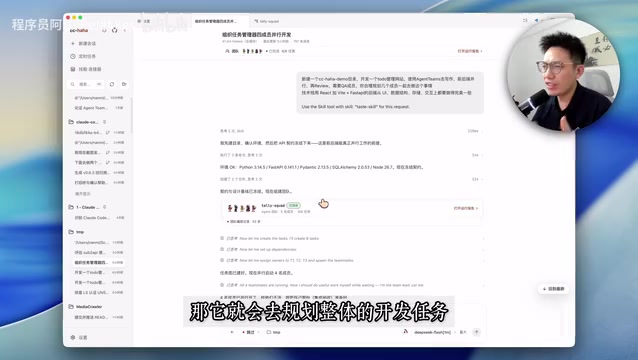
Agent Teams 背后的理论基础是"多智能体系统"(Multi-Agent System,MAS)。在传统软件工程中,将大任务拆解给多个专职角色并行处理是成熟的工程实践;Agent Teams 将这一思想移植到 LLM 领域:每个 Agent 实例拥有独立的上下文窗口和工具调用能力,彼此通过消息传递协调,而非共享同一个对话流。这种设计的核心优势是上下文隔离——前端 Agent 只需关注前端相关信息,不必"看见"后端实现细节,从而减少干扰、降低出错概率。队长 Agent 本质上充当"协调器"(Orchestrator)角色,负责任务分解(Task Decomposition)和依赖图(Dependency Graph)的构建;成员 Agent 则是执行单元(Executor)。这一架构与 LangGraph、AutoGen 等多智能体框架的设计思路一脉相承,但 Anthropic 将其直接内置于 Claude Code 的 SDK 层,省去了用户手动搭建编排层的成本。
cc-haha 里怎么用?操作其实很简单
cc-haha 是一个已获得 14K Star 的开源项目,Agent Teams 的可视化页面是它最近上线的新功能。使用步骤并不复杂:
- 将 cc-haha 更新到最新版本(演示中用到的是 0.6.3);
- 进入设置的"通用"选项,确认 Agent Teams 配置项处于开启状态(默认开启,不用可关闭);
- 在提示词里加上一句"使用 agent teams 让它去协作"。
阿江提到,稍微聪明一点的模型接到这个指令后,就知道要用 Agent Teams 去做后续规划。以前后端开发这类任务为例,它会先把"契约"定好——也就是先完成设计文档、明确 API 如何设计、前后端如何协作,然后再拆分具体任务、创建对应成员。规划完成后,界面上会生成一张卡片,点击即可回到团队协作的可视化页面。
4000万Token的代价与适用边界
强大的协作能力背后是不小的开销。阿江坦言,这次演示任务大约消耗了 4000 万 token,好在缓存命中率高达 99%,一定程度上缓解了成本压力。
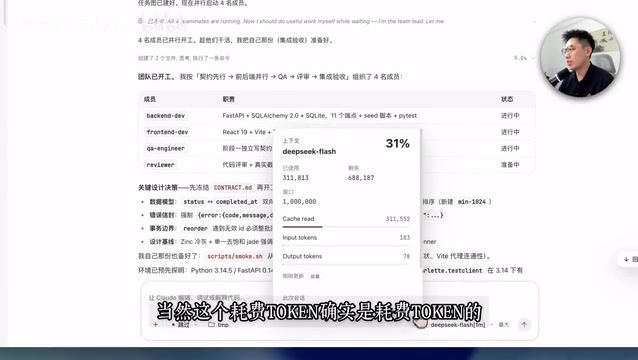
这也引出一个务实的判断:并非所有任务都适合用 Agent Teams。很多任务用普通的 subagent 就能搞定,还有一些本质上是串行开发的任务,强行套上多 Agent 协作框架反而是浪费。Agent Teams 更适合那些天然可并行、需要多角色分工的复杂开发场景。换句话说,它是一把利器,但要用在对的地方。
4000 万 token 的消耗量看起来惊人,但"缓存命中率 99%"这一数字才是理解成本结构的关键。Claude API 支持**提示缓存(Prompt Caching)**机制:当多个 Agent 反复读取同一份设计文档、代码库上下文或系统提示时,这部分内容只在首次请求时计费全价,后续命中缓存的 token 费用约为原价的 10%。在多 Agent 并行场景下,各成员 Agent 共享大量公共上下文(如 API 契约文档、代码规范),正是缓存发挥作用的典型场景。因此实际账单往往远低于"原始 token 数 × 全价"的简单估算。对于成本敏感的开发者,在启用 Agent Teams 前,建议先评估任务中可共享的上下文比例:共享内容越多、并行轮次越多,缓存收益越显著。
想深挖原理?代码全部开源
对于想理解底层机制的开发者,Agent Teams 的相关代码——包括其 SDK 层代码以及 cc-haha 的可视化代码——都在开源仓库中。阿江建议感兴趣的人可以直接克隆下来,甚至让 AI Agent 帮你分析这套协作机制的实现原理。
需要提醒的是,Agent Teams 目前在 Claude Code 上仍属于实验性功能,cc-haha 中的可视化实现同样处于探索阶段。它代表了 AI 编程从"单兵作战"走向"团队协作"的一个方向,但离生产级稳定应用还有距离。对于愿意尝鲜、也能接受较高 token 消耗的开发者来说,这无疑是一个值得动手把玩的开源项目。
相关推荐
Ollama 换盘安装指南:告别默认C盘占用
Ollama 默认安装到 C 盘怎么办?本文详解通过命令行参数指定安装路径、配置环境变量实现命令全局调用,以及用 where 命令定位软件安装位置的完整方法,适用于 Windows 10/11。
Dify本地部署实战:Docker+Ollama+RAG全流程搭建指南
Dify 本地部署实战教程解析:从 Docker 环境搭建、Ollama 本地大模型部署,到工作流设计、变量管理与 RAG 知识库应用,全流程覆盖,帮助开发者搭建私有化 AI 应用。
本地部署大模型完全教程:Ollama+Qwen 隐私免费方案
手把手教你在本地免费部署大模型:通过 Ollama 运行引擎加载 Qwen 通义千问开源模型,搭配图形客户端实现类豆包体验,数据不外泄、零费用,附完整安装步骤与硬件建议。