#多智能体
共 216 篇相关文章

LangChain 1.3系统教程:RAG/Agent/MCP/LangGraph实战落地
B站UP主楼兰发布LangChain 1.3系统教程,覆盖架构入门、RAG、Agent、MCP、LangGraph多智能体项目实战。课程强调重体系不重功能、重实战不重理论,帮助学习者摆脱追工具的疲惫,建立可迁移的AI应用开发能力,并涉及token成本规划与本地大模型部署。
从零构建多智能体系统:架构模式与设计思路
从零构建多智能体系统的架构模式解析,涵盖中心调度、层级式与对等式协作模式,以及通信协议、状态管理与错误隔离等工程实践要点。

AgentScope 2.0框架深度解析:从玩具到工业级智能体开发
AgentScope 2.0是阿里通义实验室开源的多智能体框架重大升级,从玩具级走向工业级。本文解析其六大核心改进(事件系统、安全拦截、人工介入、效率优化、工作区、服务托管)、架构设计以及ReAct与Plan-and-Execute两种智能体设计范式,帮助开发者快速理解2.0的破坏性变更与生产可用性。

自主智能体如何重塑电力系统规划
最新研究提出自主规划框架,让智能体完成电力系统规划中提案、数值评估、反馈解读与方案选择的完整闭环。在五个电力系统、四个国家的四十条碳约束轨迹中,全部保留满足物理与碳预算校验的候选方案,其中二十八条匹配参考设计超出新情景上限。

TandemBench:多智能体协作决策模型基准
TandemBench 基准包含 1,200 个多智能体烹饪场景问题,评估决策模型在团队计划选择与最优性验证上的表现。最佳原生模型决策准确率 62.50%,但在最优性验证上接近随机水平,揭示系统性判断偏差。

英伟达工厂运营蓝图:AI智能体协同排查产线故障
英伟达工厂运营蓝图通过工厂经理智能体协调多个专用AI智能体,协同调查产线非计划停机问题。本文解析其分工架构、可解释性设计与制造企业落地时的现实考量。
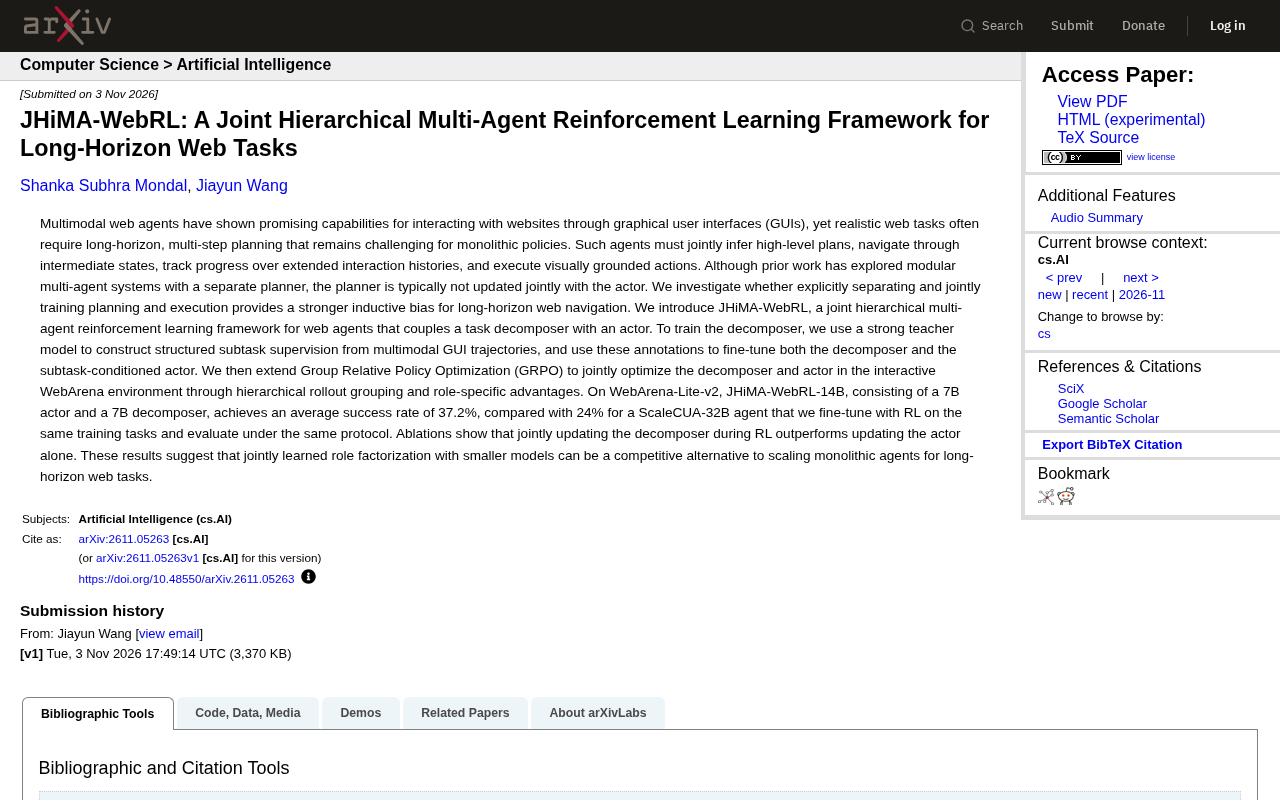
JHiMA-WebRL:分层多智能体RL突破长程Web任务
JHiMA-WebRL提出分层多智能体强化学习框架,将任务分解器与执行器联合训练,7B+7B组合在WebArena-Lite-v2上取得37.2%成功率,优于32B单体模型,为长程Web任务提供新思路。

DeepSeek开源Super Agent:为何仍点不了你的APP?
DeepSeek开源的Super Agent采用Router/Worker多智能体架构,但演示场景集中在有API的系统。本文拆解其能力边界:为什么微信、银行等只有界面的APP仍然点不了,以及Andy如何用网格编号和三次即停机制攻克无接口界面。

NextRole托管上线:多智能体求职助手免费体验
NextRole 多智能体求职助手已托管上线,基于 LangGraph 与 DeepAgents 构建,通过 supervisor 调度招聘侦察、简历定制和面试辅导三个子智能体,支持多用户隔离与本地自托管,免费试用。

Teamily AI:在同一个信使里与智能体和真人协作
Teamily AI在Product Hunt发布,主打个人智能体、智能体团队与真人在同一个AI原生信使中协作。本文分析其多用户多智能体定位、持久记忆与主动智能能力,以及企业集成和实际体验中待验证的问题。
多AI智能体桌面协作实验:Bangstick让AI角色分工合作
开发者分享Bangstick多智能体桌面协作实验:多个AI智能体以桌面角色形式分工合作,支持ChatGPT、Claude Code、本地LLM等多种后端,探索AI优先的桌面环境新形态。
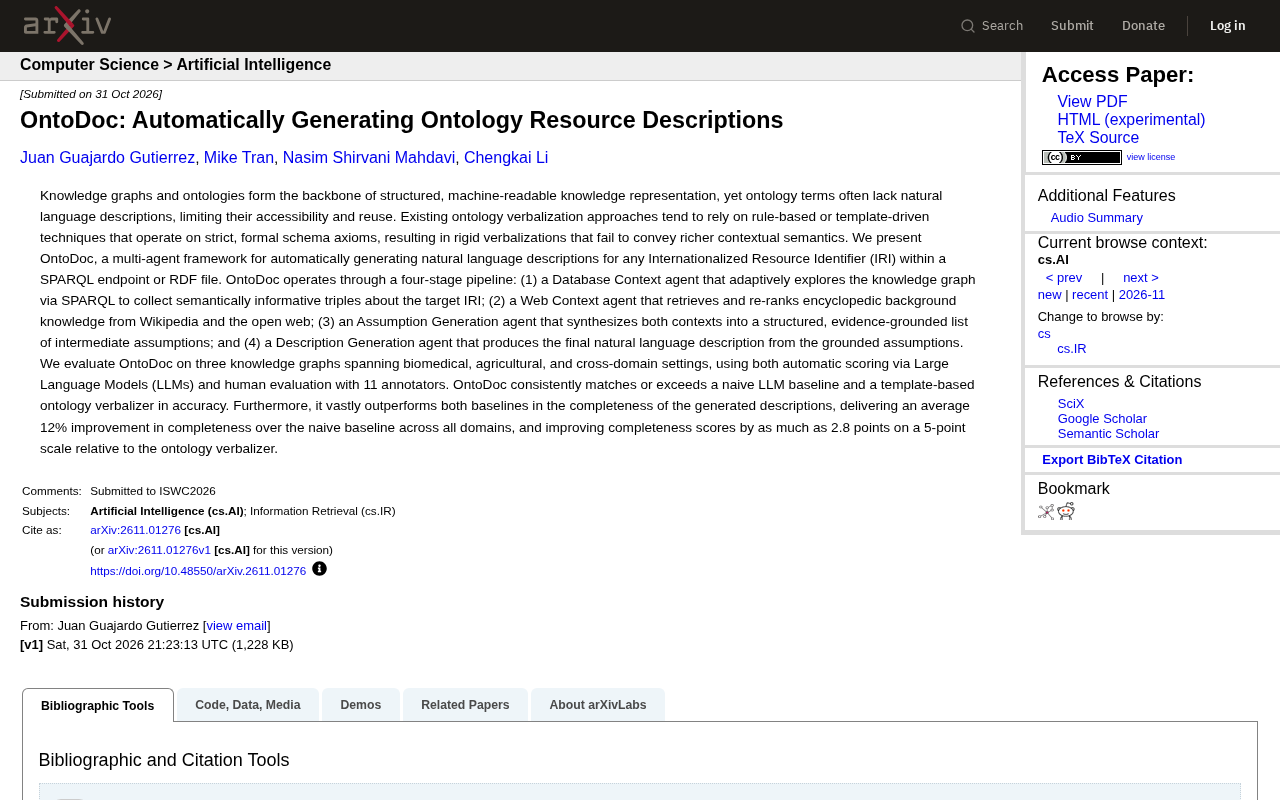
OntoDoc:多智能体框架自动生成本体资源描述
OntoDoc 是一个多智能体框架,可自动为知识图谱中的任意 IRI 生成自然语言描述。它通过四阶段流水线整合 SPARQL 查询与网络百科知识,在生物医学、农业和跨领域评估中,完整性显著优于基线方法。

50个AI智能体在《我的世界》建文明,为何败给官僚主义?
Reddit热议实验:50个AI智能体在《我的世界》中协作建立文明,却因陷入官僚主义而失败。本文分析多智能体系统的协调成本与规模扩展难题。

AI写完代码如何安全上线?拆解Claude Code团队审查流程
Anthropic分享Claude Code团队的代码审查流程:从本机验证、CI、多智能体AI审查、安全审核到按风险分级的人工审批与快速回滚,合并PR翻倍增长而回滚比例下降超40%。本文拆解各环节细节,并分析人的注意力应放在哪些关键判断上。

半年前爆火的小龙虾去哪了?拆解代码发现只是Claude Code子集
半年前爆火的多智能体框架「小龙虾」去哪了?B站UP主拆解代码发现,其核心能力只是Claude Code的一个子集,拆解问题与操控接口两大功能已融入主流开发工具。本文还探讨了AI编程效率提升的真实幅度、AI定义边界的移动,以及多智能体权限安全的社会化解法。

从评估到进化:WeGenEditBench重构图像编辑评测范式
解读 WeGenEditBench 图像编辑评测基准:2,740 个实例、148 种任务类型,通过原子级清单识别局部失败,并借助 WeGenEvoStudio 多智能体框架将诊断转化为模型进化,含 GPT-Image-2、Seedream-5.0-Pro 横评与 FLUX.2 [dev] 进化数据。

5个Qwen3.8-27B组团击败Fable 5:Memdoor多智能体解法
Memdoor 开源项目展示 team-solve 工作流:5 个 Qwen3.8-27B 模型通过角色分工与记忆层协作,在 LiveCodeBench Hard 上击败 Fable 5,探讨多智能体编排如何以小博大。

五个小模型组队,为何能击败大模型?Memdoor的启示
Reddit热帖讨论Memdoor用5个Qwen3.8-27B模型组队在LiveCodeBench Hard上击败Fable 5,引发关于多智能体并行与串行协作、算力约束下模型使用方式的深度讨论。

