#多智能体
共 218 篇相关文章
Kotlin手写AI客服:RAG、MCP与多智能体的工程化实践
深入解析Kotlin Multiplatform手写AI客服项目DSupport:不用Agent框架,通过RAG相关性阈值、MCP远程工具、多智能体编排与代码级护栏,实现模型负责理解、代码负责保证的工程化架构。

多智能体协作三大模式与防死循环三法则
Reddit 实践者分享多智能体协作的三种协调模式(中心化调度、对等协商、流水线接力)和三条防循环规则(最大轮次限制、状态收敛检测、角色职责边界),帮助开发者构建高效稳定的多智能体系统。

腾讯IntelliScene:多智能体推理驱动游戏场景布局
腾讯游戏AI团队在B站展示IntelliScene多智能体游戏场景布局系统:1.0用LLM集群与慢思考实现叙事驱动布局,2.0引入视觉语言模型与概念艺术引导,3.0提出分层放置架构,关键物体恢复率超90%,放置速度显著优于现有方案。

AI应用落地教程:从Copilot到Agentic AI的演进与实战
B站AI应用落地教程梳理AI从ChatGPT到Agentic AI的三阶段演进,解析多智能体协同与自主决策框架,涵盖JManners、Agent Scope、ReAct、MCP等热门技术栈,帮助开发者把握不被淘汰的AI架构能力。

大模型做编排为何失败?消费级硬件实测
消费级硬件跑大模型系列实测:77GB 协调者模型跑稳后,编排仍会丢步骤、空返回、把委派当文本输出。根因不在模型规模,而在 agentic loop 结构。确定性编排把循环交给脚本、模型只做规划与评估,同一计划从五步完成三步变为全部完成。

为什么一个AI Agent不够用?Anthropic动态工作流解析
Anthropic团队深度解析动态工作流:单智能体为何在长任务中崩溃?多智能体编排如何用1000个Agent解决OS级工程?涵盖成本配比、安全架构与Linux式分层维护的启示。
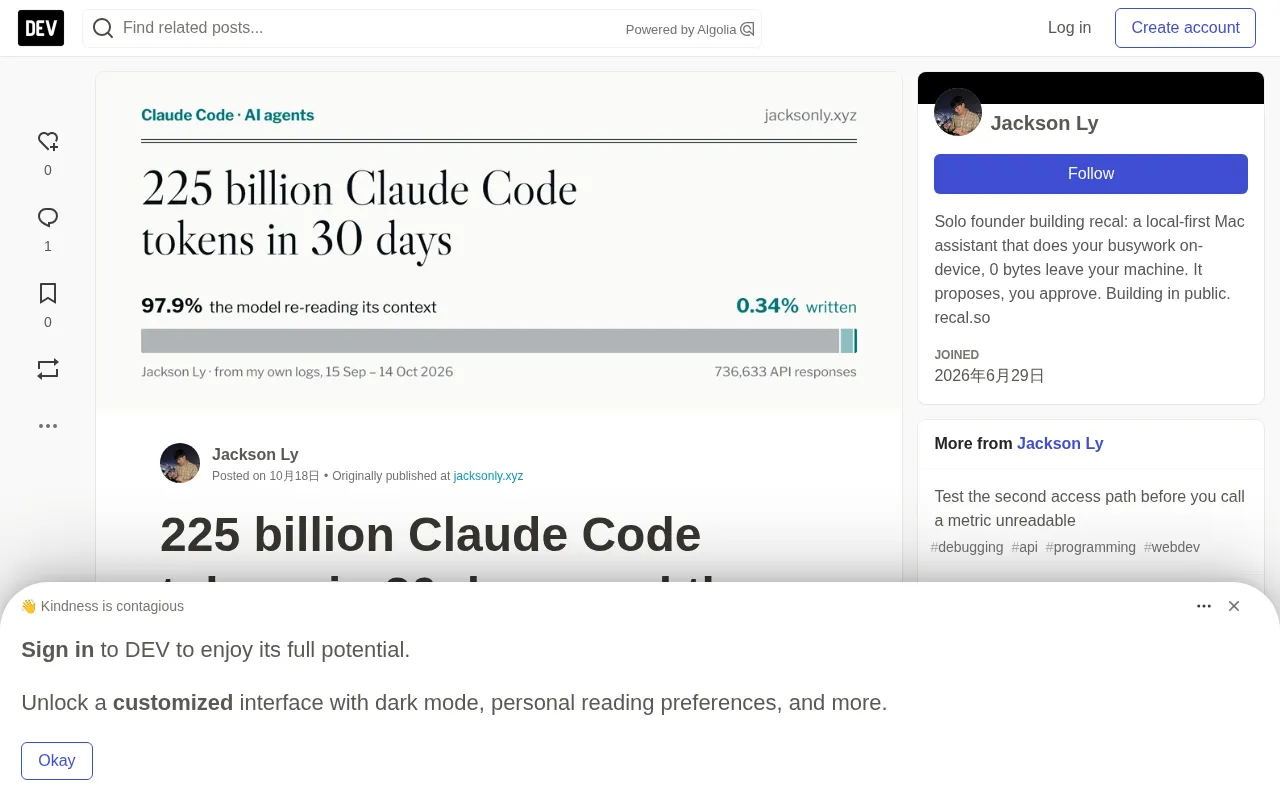
2250亿Token实测:Claude Code成本与多智能体真相
一位开发者30天实测Claude Code:2251亿Token中97.9%是缓存重读,1029个合并PR,59%-80%子智能体未命名模型而继承昂贵Opus。含成本结构、多智能体管理半径与配置避坑指南。

拍卖取代编排:多智能体LLM工作流的市场机制
Google Research新论文提出用序贯拍卖替代中央编排器,让多智能体在MDP中通过经济激励竞标任务,实现动态分配与内建失败恢复。本文解析拍卖协议、竞价压价机制、部署形态与安全边界。
五个AI Agent合租一个窗口:261次提交后的多智能体启示
B站创作者记录五个AI Agent在Cursor单窗口合租25天、261次提交的实践:状态灯误报、书页排队、权限隔离等工程细节,揭示多智能体协作的真实成本与设计取舍。

GPT-6 Pro多智能体并行任务:效率提升还是新隐患?
OpenAI为GPT-6 Pro和ChatGPT引入多智能体并行处理架构,可将单个请求拆解给多个智能体同时执行。本文分析其工作原理、效率承诺缺乏数据支撑的问题,以及多智能体分歧时的监督难题。
多智能体编排七大模式图解与框架支持对比
图解七种多智能体编排模式:顺序链、路由、并行、监督者、层次化、群聊与交接,并对比 OpenAI Agents SDK、LangGraph、Mastra、AI SDK、ADK、CrewAI 与 A2A v1.0 的原生支持情况,帮助开发者按场景选择模式与框架。

多智能体系统为何86%失败?拆解规划器到执行者的规格漂移
多智能体系统生产失败率高达86.7%,根源在于规划器到执行者的规格漂移与静默工具错误传播。本文拆解三类交接瓶颈,结合10,000条工作流审计数据,解析确定性状态契约图如何将端到端成功率提升至96.9%。

多智能体协作新范式:用图数据库取代提示词传递上下文
多智能体系统常通过提示词传递上下文,导致信息有损且无法跨会话持久。Crew Memory Graph 用 FalkorDB 图数据库作为共享记忆层,实现无状态智能体间的精确交接。本文详解其三层记忆架构、证据路径查询与确定性规划器设计,并提供可验证的测试与基准结果。

基于Supabase、VAPI与Vercel构建多智能体语音指挥中心
Load Bearing Empire 分享多智能体语音指挥中心的生产架构:基于 Supabase Edge Functions、VAPI 语音 API 与 Vercel,用统一 Webhook 监听器和 8 表 Postgres schema 协调 8 个并发智能体与 8 条自动化工作流,并解决回调竞态问题。

多AI智能体并非系统更优解:协作开销的分布式系统工程启示
Vals AI研究显示多智能体团队成本高2-5倍但提升有限,根源在于协调开销。本文从分布式系统视角分析耦合度如何决定多智能体架构的合理性,并给出智能体设计的务实原则。

多智能体评审团自信出错:实测百万token的教训
实测158个智能体、2800万token的多智能体代码评审流水线:一次全体一致的错误裁决暴露了框架效应、成功型失败、以及组合重新评分缺失。四个可复用的修复规则。

让LLM智能体不再跑偏:全新Steering Agent监督框架
论文提出Steering Agent监督框架,通过快慢双路径与强化学习联合训练,解决LLM智能体与多智能体系统在长程任务中的目标漂移问题,并验证其跨任务泛化与可控干预频率。

用LangGraph打造开源AI对冲基金引擎:7人投研团队与TimesFM预测
Reddit开发者开源Lumina Capital:基于LangGraph的七角色投研委员会、Qlib Alpha158量化因子库、Google TimesFM概率预测与10秒ATR哨兵止损,探索LLM与确定性量化计算分离的多智能体对冲基金架构。