从零到百万行:一个独立开发者6个月自建Agent框架的解剖
一位开发者6个月独自打造多智能体框架,融合分层记忆与Q-Learning,核心价值在于工程思路而非代码量。
一位Reddit开发者历时6个月独自构建了一套以北欧神话角色命名的多智能体AI框架,采用"决策—编排—执行"三层架构。该框架最大亮点是复杂的记忆子系统,将情景记忆、语义记忆、候选事实过滤与Q-Learning动作选择融合,试图逼近"世界模型"的设计目标。工具治理方面,tool_governor实现了动态能力门控,浏览器操作与代码修改等高风险动作引入人工审批环节。从workers目录规模来看,实际应用场景集中于YouTube视频内容自动化生产流水线。尽管"百万行代码"更多是调侃,项目已出现命名冲突、废弃模块等技术债,但其"记忆分层+能力门控+人工审批"的工程思路,对当前Agent系统从Demo走向可用产品具有参考价值。
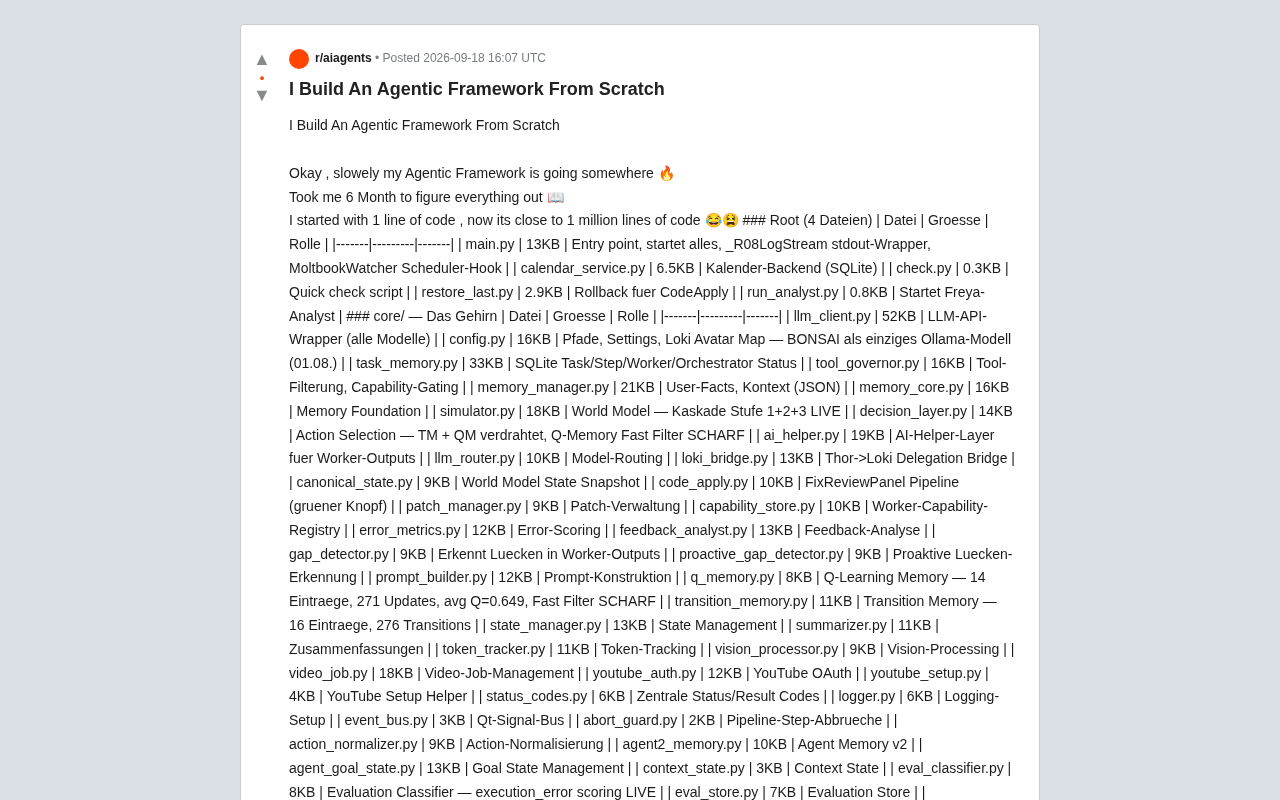
一位Reddit开发者在 r/aiagents 社区分享了他历时6个月、独自打造的多智能体(Multi-Agent)AI框架。从最初的一行代码,到如今接近百万行的庞大代码库,这个项目以北欧神话中的角色命名——Thor(雷神)、Loki(洛基)、Freya(芙蕾雅)、Heimdal(海姆达尔)、Ratatoskr(拉塔托斯克),构成了一套分工明确的Agent协作系统。抛开夸张的行数说法,这套框架的模块设计值得拆解,它折射出当下自建Agent框架的普遍思路与工程难点。
架构总览:五个命名角色的分工
从作者贴出的文件目录看,整个系统按职责划分为若干层次,每一层都对应一个神话角色或功能命名:
- core/(大脑):包含LLM客户端、任务记忆、决策层、世界模型模拟器等核心逻辑;
- orchestrator/(流水线):负责规划、路由、重试与Agent循环;
- workers/(双手):执行具体任务,如视频渲染、浏览器自动化、图像生成;
- thor/(主Agent):系统的主控智能体,负责工具分发与系统提示;
- freya/(分析师):负责反思、事实学习与审批决策。
这种「大脑—流水线—双手」的三层划分,本质上是把一个复杂Agent系统拆成"决策"、"编排"与"执行"三个关注点。这也是目前多数生产级Agent框架(如LangGraph、AutoGen)的通用范式。作者用神话角色包装,虽然增加了理解成本,但内部职责边界是清晰的。
记忆系统:这个项目最有看点的部分
真正体现工程深度的,是这套框架的记忆(Memory)子系统。它没有停留在简单的对话历史拼接,而是分成了多种记忆类型:
分层记忆设计
- episodic memory(情景记忆):存储在
episodes.db,已累积1029条情景记录,并新增了execution_error、world_change、confidence三个指标列; - semantic memory(语义记忆):存储事实(Facts),已有约200条条目,支持
applicable_to与origin字段; - maybe_facts(候选事实/等候区):796个候选事实,其中只有7个获得两次以上确认才会被采纳——这是一个类似"事实可信度过滤"的机制;
- Q-Learning Memory:15条状态-动作条目、339次更新、平均Q值0.672,配合 Fast Filter 做动作筛选;
- transition memory(转移记忆):17条记录、344次状态转移。
这套设计把强化学习中的Q-learning、状态转移建模,和LLM Agent的记忆机制结合起来。decision_layer.py 中"TM + QM 打通"的注释,说明作者试图让转移记忆(TM)和Q记忆(QM)共同参与动作选择。这比多数只做向量检索(RAG)的记忆方案要复杂,也更接近"世界模型"(World Model)的思路——simulator.py 里就明确标注了级联三阶段的世界模型正在运行。
Q-Learning(Q值学习)是强化学习的一种经典算法,核心思想是让智能体通过与环境的交互,学习在特定状态下采取哪个动作能获得最大长期回报。Q值(Q-value)代表"在状态S下执行动作A的预期收益",取值越高代表该动作越优。将Q-Learning引入LLM Agent,意味着系统不再单纯依赖语言模型的一次性推理来选择下一步动作,而是累积历史经验,让高回报的动作路径在未来被优先选择。这在需要重复执行相似任务的场景(如自动化发布流程)中,能有效减少低效试错。状态转移记忆(transition memory)则记录"从状态A执行动作X后到达状态B"的历史模式,与Q记忆结合,使决策层能更准确地预测动作后果,而非每次都从零推断。
工具与能力治理:Governor 与 Gating
框架里反复出现 tool_governor.py 和 "Capability-Gating" 的概念,说明作者意识到了Agent系统的一个核心痛点:如何在众多工具中限制Agent的可用工具集。
tool_governor 承担的是工具过滤与能力门控的角色。配合 capability_store.py(Worker能力注册表)和 tool_registry.py(工具注册表),系统可以根据当前任务上下文,动态决定某个Agent能调用哪些工具。这种设计在工具数量膨胀后尤为关键——如果不加约束,把几十个工具的定义全塞进提示词,既浪费token又容易导致模型误调用。
此外,browser_tools_neu.py 中提到的 Approval Gate(审批门),以及 code_apply.py 的"绿色按钮"确认管线,都指向一个负责任的设计取向:涉及浏览器操作、代码修改这类高风险动作时,引入人工确认环节,而非让Agent完全自主执行。restore_last.py 提供的回滚能力也是同一思路的延续。
Capability-Gating(能力门控)是Agent工程中应对"工具爆炸"问题的常见策略。当一个系统集成了几十乃至上百个工具时,若将全部工具描述一次性塞入LLM的上下文窗口,会带来三重问题:一是消耗大量token导致成本上升;二是过长的工具列表会降低模型的注意力精度,使其更容易误选工具;三是某些高权限工具(如文件写入、网络请求)在无关任务中暴露给Agent存在安全隐患。门控机制的本质是在运行时根据当前任务的语义或阶段,动态裁剪Agent可见的工具子集,只呈现"此时此刻相关"的能力。这与操作系统的权限最小化原则(Principle of Least Privilege)同源,是Agent系统从实验性Demo走向生产部署的必要工程实践。
实用能力:媒体自动化是主战场
从 workers/ 目录的文件大小能看出这个框架的实际用途偏向内容与媒体自动化生产:
remotion_worker.py(89KB):基于 Remotion 的视频渲染,是最大的Worker文件;thumbnail_worker.py(63KB):缩略图生成;sd_worker.py:Stable Diffusion 图像生成;youtube_worker.py+youtube_auth.py:YouTube上传与OAuth;pexels_video_researcher.py:Pexels素材检索;browser_worker.py:浏览器自动化。
这套组合基本勾勒出一条自动化视频内容生产流水线:检索素材→生成图像→渲染视频→制作缩略图→上传发布。对独立创作者而言,这是一个非常实际的应用场景,也解释了为什么作者要在Agent能力上投入如此多的工程量。值得一提的是,模型侧作者选择了本地部署的 Ollama(BONSAI 27B 作为唯一模型),兼顾了成本与隐私。
冷静看待:百万行代码与真实价值
"从1行到接近100万行"的表述更多是社区式的自我调侃,从目录里最大的文件(loki_planner.py 72KB、thor_tools.py 59KB)来看,实际核心代码量远达不到百万级。真正让人在意的,不是行数,而是这类单人自建框架的可维护性问题。
目录中已经出现了明显的技术债信号:northstar.py 被标注为"过时——第一个月的遗物",sync_source.py 已被停用,core/ 和 orchestrator/ 下各有一个 decision_layer.py 造成命名冲突。这些都是快速迭代六个月后典型的架构侵蚀现象。对于想借鉴的开发者来说,这个项目的价值不在于直接使用,而在于它展示了一套记忆分层 + 能力门控 + 人工审批的Agent工程思路——这三点恰恰是当前从Demo走向可用产品最需要补齐的环节。
技术债(Technical Debt)这一概念由软件工程师Ward Cunningham提出,比喻开发过程中为了快速交付而采用的次优方案,如同借债,日后需要付出额外成本来偿还。在个人快速迭代的项目中,技术债尤为普遍——命名冲突、废弃模块未清理、核心逻辑分散在多处,都是典型表现。文中提到的 northstar.py 被标注为"第一个月的遗物"、两个同名 decision_layer.py 并存,正是这类现象的缩影。对于希望借鉴此项目思路的开发者,更值得关注的是其架构设计模式而非具体实现代码——后者在未经重构的快速迭代产物中往往可读性和可维护性都较低,直接复用的风险较高。
相关推荐
认知行为疗法 vs 精神分析:谁赢得了心理治疗之争
认知行为疗法(CBT)如何战胜精神分析成为心理治疗主流?历史学家Andrew Scull揭示了从二战、联邦经费到循证医学的深层原因,并客观评估CBT在轻度与重度精神障碍上的真实疗效。
Opus 5.5泄露定价更低!Qwen4、Kimi K3.1等国产大模型集中来袭
Anthropic Opus 5.5泄露:性能对标GPT-6 Astra但定价更低。同期StepFun Step5、MiniMax M3.1、阿里Qwen4与Kimi K3.1等国产大模型集中来袭,本文梳理这波密集发布背后的降本与开源趋势。
DGX Spark部署Qwen3 27B实测:三种模式怎么选
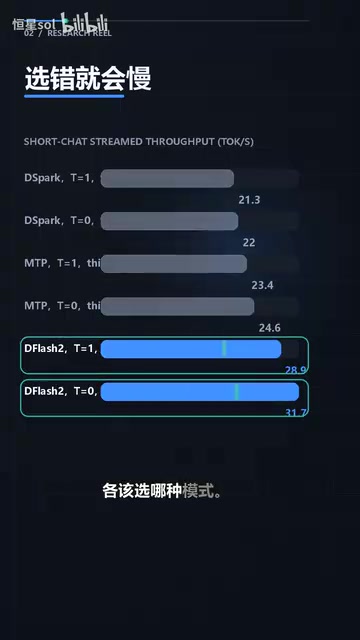
DGX Spark部署Qwen3 27B实测:D-Spark、MPP、D-Flash2三种模式在代码、短聊、长文场景下的吞吐对比。D-Spark代码51.5,D-Flash2长文25.4、16路并发总吞吐227.6,MIT开源可一行Curl调用。