#Ollama
共 105 篇相关文章

Ollama v0.40.13 更新:LFM3 音频模型登陆 Linux 与 Windows
Ollama v0.40.13 发布,Liquid AI 的 LFM3 模型(含 lfm3-audio 与 lfm3-omni 文本转语音能力)不再限于 Apple silicon,现已支持 Linux 和 Windows,本地音频模型部署门槛进一步降低。
导演大师配置Ollama本地模型全流程教程
B站教程完整演示导演大师配置Ollama本地模型的方法:从Ollama安装、模型路径设置、千问模型下载,到在导演大师Agent设置中接入本地模型,并用本地千问3.8跑通选题、大纲、剧本和分镜全流程。
导演大师接入Ollama本地模型:配置与全流程创作实战
B站教程详解导演大师如何接入Ollama本地模型:从安装Ollama、设置模型存储路径、命令行拉取千问模型,到在Agent设置中添加提供方,并用本地千问3.8跑通选题、大纲、剧本、分镜的短片创作全流程。

Ollama发布v0.40.12-rc1,新增LFM3与d1模型支持
Ollama发布v0.40.12-rc1候选版,提交信息显示新增LFM3与d1模型的MLX后端支持。本文解读这一变更对Apple Silicon本地推理的实际意义与开发者可关注的点。

Ollama v0.40.10 更新 Gemma 渲染器,支持投机解码
Ollama v0.40.10 新增 gemma4-nemotron 渲染器,调整助手内容与工具调用的渲染顺序,并在 MLX 后端支持 Gemma 4 搭配 DFlash 草稿模型的投机解码,同时解耦目标精度与量化草稿权重。
Ollama v0.40.10-rc0:Gemma 4渲染器更新与MLX推测…
Ollama v0.40.10-rc0:Gemma 4渲染器更新与MLX推测解码增强
Ollama v0.40.10-rc0 更新 Gemma 4 渲染器:新增 gemma4-nemotron 渲染顺序变体,并为 MLX 后端加入 DFlash 推测解码支持,暴露隐藏态与原始 logits。

Ollama本地大模型部署教程:从安装到图形化客户端
Ollama本地大模型部署完整教程:三平台安装、GGUF与SafeTensors模型导入方法、图形化客户端接入OpenCode与WebSearch实测,以及模型存储路径等关键设置和选型建议。

Ollama v0.40.9-rc0:WoA 支持切换至正式版 CUDA 工具包
Ollama v0.40.9-rc0 将 CI 从预发布版 CUDA Toolkit 切换至正式发布版本,以提升 Windows on Arm 构建稳定性。本文解析这次变更的动机、对 WoA 推理支持的影响,以及预发布依赖在 CI 中的风险模式。

Ollama v0.40.7-rc1:MLX与GGML共享CUDA运行时,打包体积瘦身
Ollama v0.40.7-rc1 提交去重 MLX 与 GGML 共享的 CUDA 运行时库,将其移入同级 CUDA payload 目录,保留 MLX 私有库与 JIT 头文件,并完整打包 OpenBLAS Fortran 运行时闭包、在发布阶段增加依赖校验,从而缩减发行包体积并简化依赖解析。
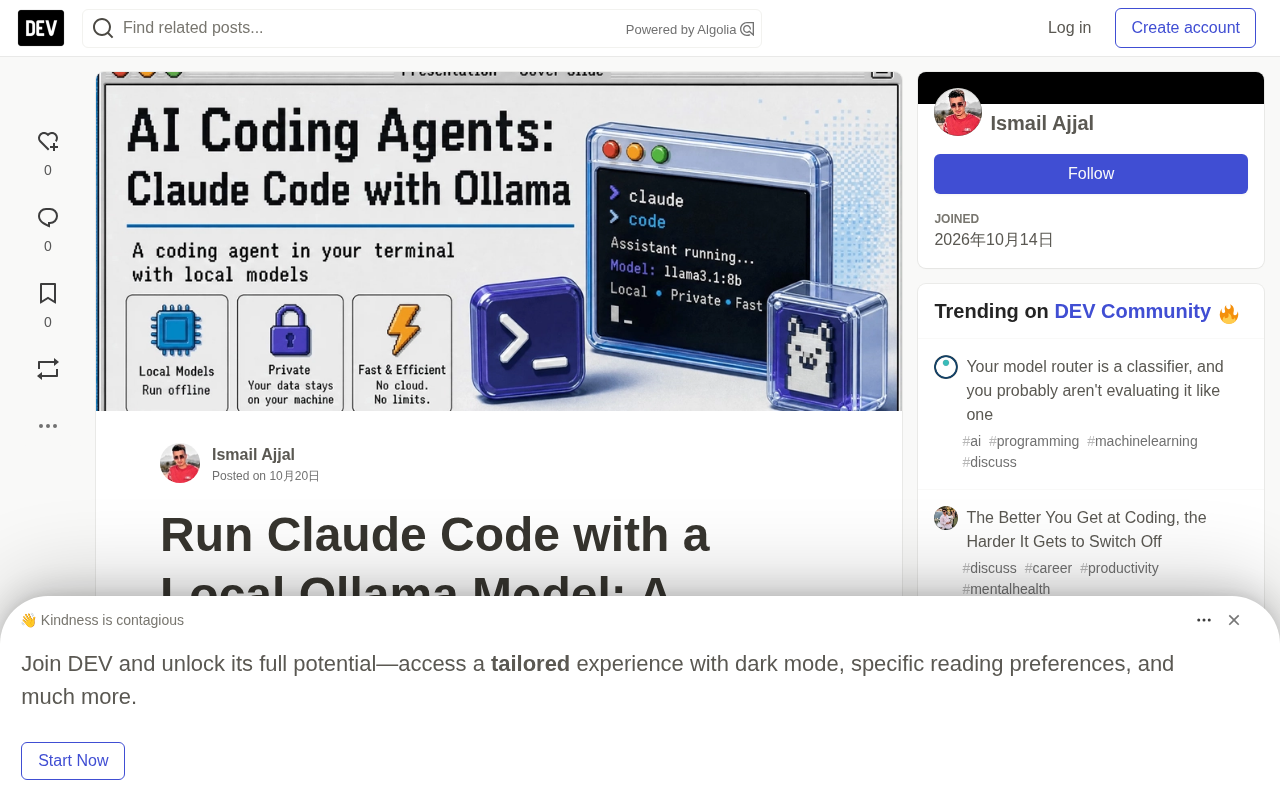
用本地Ollama跑Claude Code:完整实战指南
手把手教你将 Claude Code 连接到本地 Ollama 模型,覆盖 Windows、Linux、macOS 安装配置,含 ollama launch 与环境变量两种接法,并附 8GB 内存实测结论与排错清单。

Meta开源模型Muse Spark Open登陆Ollama:100万token上下文
Meta开源权重模型Muse Spark Open正式上线Ollama,主打编码与工具调用,拥有100万token上下文窗口。本文介绍其定位、运行命令、可用范围及实际应用观察。

Ollama进军首尔:牵手FriendliAI拓展韩国AI市场
Ollama宣布11月前往首尔,会见韩国用户、客户与合作伙伴,并确认与当地AI基础设施公司FriendliAI合作。本文分析此次拓展的市场背景、合作互补逻辑及Ollama从开源工具向区域生态转型的信号。

DeepSeek-V4.1-Flash登陆Ollama:Agentic任务更强且更省钱
DeepSeek-V4.1-Flash-1017正式上线Ollama及Ollama Cloud,主打agentic任务能力强、每任务成本更低,并提供美国托管与零数据保留。本文解析其接入方式、成本口径与合规卖点,并指出模型参数、上下文长度等关键信息仍待官方补充。

欧盟自托管开源大模型:一份可落地的GDPR合规清单
面向欧盟团队的实操指南:用Ollama在欧盟境内自托管开源权重大模型,规避GDPR跨境传输难题,附Docker Compose部署代码、硬件选型表与10项合规清单。

Ollama在K3s上龟速?GPU直通配置实战指南
Ollama在K3s上推理慢如蜗牛?根源是容器看不到NVIDIA GPU,默认回退CPU。本文拆解原因并提供完整GPU直通配置:NVIDIA Container Toolkit、containerd模板、Device Plugin部署与Ollama资源声明,附验证方法与故障排查,速度从每秒1个token提升到60-90个token。

PrintBrief:本地AI把混乱消息变成印刷订单
PrintBrief 是一款面向小型印刷店的本地 AI 助手,通过 Ollama 运行 Gemma 3 4B 解析混乱客户消息,提取印刷参数、检测缺失信息并生成确定性报价,客户数据不出本机。

Ollama是什么?把免费AI大模型装进自己电脑
Ollama 不是大模型,而是本地运行 AI 模型的工具。本文讲清 Ollama 的定位、四步上手流程、本地 AI 的三大优势与硬件约束,并解释“免费”的真实含义,帮你判断它能否替代 ChatGPT 等云端服务。

Open WebUI实战:给本地大模型装个聊天界面
Open WebUI实战教程:为本地Ollama模型搭建网页聊天界面,分清8080网页服务与11434模型服务端口,完成安装、连接检查、聊天记录保存与重启验证,附分层排错思路。

Codex接本地模型:8G到24G显卡各能跑什么
把Codex和Claude Code接到本地模型,关键是一句减法:显存减模型文件大小,剩下留给上下文。本文按8G、12G、16G、24G四档显卡列出可跑模型、实测余量、Ollama接入四步法和四个常见卡点,并说明Claude Code官方不支持本地模型的限制。

Ollama决策模型实测:本地推理速度远超Claude
实测 Ollama 决策模型:0.8B 小模型在本地完成邮件分类与评分任务,速度比 Claude API 快两倍以上,还能在 Dell Pro Max 上做图像分类。本文整理部署步骤、速度对比数据与多模态实测结果。