导演大师接入Ollama本地模型:配置与全流程创作实战
用 Ollama 部署本地千问模型,接入导演大师 Agent 跑通短片创作全流程。
文章介绍了如何用 Ollama 在本地部署千问模型,并将其接入 B 站教程演示的 Agent 工具“导演大师”,从而搭建一条数据不出本机、不消耗 token 的视频创作流水线。配置分三步:安装 Ollama 并指定模型存放目录、通过命令行拉取千问模型、在导演大师的 Agent 设置中添加 Ollama 提供方并设为默认。随后作者以“三岁小孩动画片”为主题,演示了选题、大纲、剧本、分镜四个环节的完整流程,每一步都经由草稿确认卡人工审核后保存为正式内容。文章也指出本地模型输出稳定性有限、分镜后的资产生成尚未覆盖等边界。
本地大模型正在成为内容创作者的"私有引擎"——数据不出本机、调用不计 token、可离线运行。但要把模型真正插进创作工作流,光有 Ollama 还不够,还需要一个能编排选题、大纲、剧本、分镜的 Agent 工具。B 站这期教程演示的"导演大师",正是把这两件事连了起来:用 Ollama 跑本地千问模型,让 Agent 走完一支短片从选题到分镜的全流程。
为什么视频创作者盯上了本地模型
教程一开场就点出了需求来源:不少人喜欢用本地模型来写选题、写剧本、写台词。这类创作任务的特点是"高频、长文本、反复改"——如果每次都走云端 API,成本和使用限制都会成为瓶颈;而本地部署后,模型常驻本机,随时调用不受网络波动影响。
Ollama 的价值在于把本地模型的部署门槛压到了很低:一个安装包、一条拉取命令,就能把主流开源模型跑起来。对不熟悉命令行的创作者来说,这套流程已经足够"傻瓜化"。
Ollama 是一个开源的本地大语言模型运行框架,核心作用是把模型下载、量化、加载、推理服务等环节封装成简单命令。用户只需执行 ollama run <模型名>,框架就会自动拉取模型权重并启动一个本地 API 服务(默认监听 11434 端口)。它支持 Llama、Qwen、Gemma 等主流开源模型系列,并兼容 Windows、macOS 和 Linux。对创作者而言,Ollama 的意义在于把“部署本地模型”从需要配置 Python 环境、CUDA 驱动和推理框架的工程任务,简化成安装加一条命令的操作。导演大师之所以能直接“获取可用模型”,正是因为它调用了 Ollama 暴露的本地模型列表接口。
三步搭好本地模型环境
安装 Ollama 与设置模型目录
教程的第一步是去 Ollama 官网下载安装程序。页面提供"手动下载"入口,下载下来是一个 exe 文件,双击安装即可。
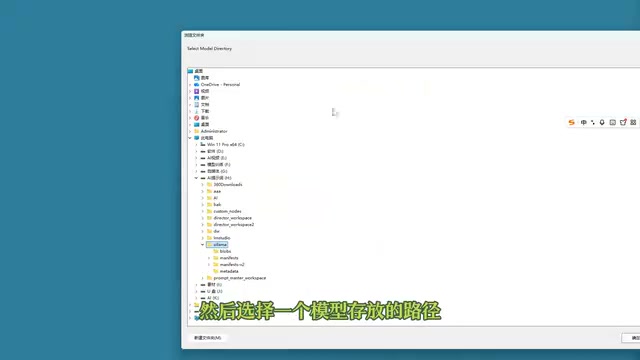
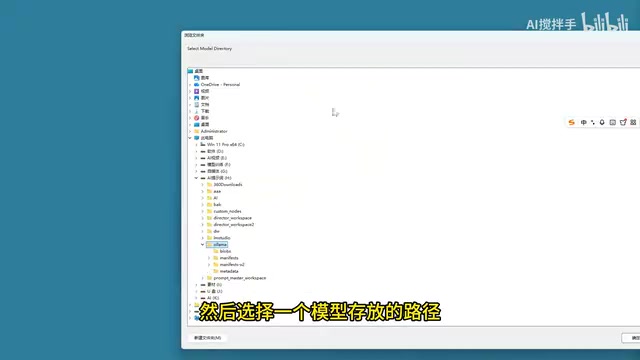
安装完成后,先别急着拉模型——要在设置里指定本地模型的存放位置。点击"浏览"选择一个空间较大的磁盘目录,因为模型文件体积可观,放在系统盘容易吃紧。
用命令行拉取千问模型
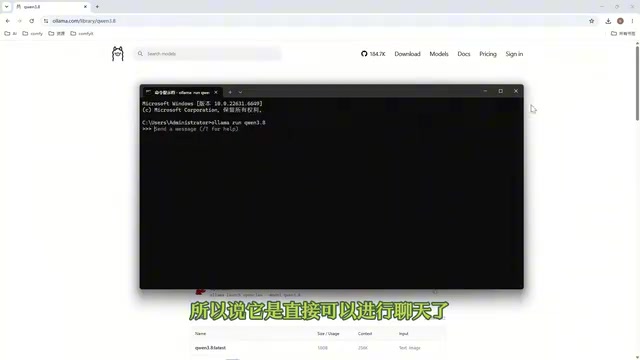
环境就绪后,进入模型页面选择要用的模型。教程以千问 3.8 为例,复制页面给出的运行命令,在终端里输入 cmd 回车,粘贴命令执行。
这里有个细节值得说明:第一次运行某个模型时,本地还没有对应文件,命令会自动触发下载过程;下载完成后再次运行,就直接进入对话状态。教程演示时模型已经下载过,因此跳过了等待环节。
Qwen(千问) 是阿里云广告通义千问团队开源的大语言模型系列,提供从 0.5B 到 72B 以上多种参数规模,并有基础模型与对话微调版本。文中提到的“千问 3.8”应指 Qwen 系列中某一版本的对话模型(如 Qwen2.5 的 3B/7B 等规格在本地场景较常见)。开源模型通常以量化格式分发(如 4-bit 量化),以降低显存和内存占用——这也是模型文件动辄数 GB、需要提前规划磁盘空间的原因。选择较小参数量的版本,可以在消费级显卡甚至纯 CPU 上运行,但输出质量和长文本连贯性会相应下降,这正是后文强调人工审校的原因。
在导演大师中添加 Ollama 提供方
本地服务跑通后,回到导演大师:打开设置 → Agent 设置 → 添加提供方,在提供方列表中选择 Ollama,然后点击"获取可用模型"。教程作者本地装了两个模型(3.5 和 3.8),选中 3.8 添加,保存并设为默认,配置就完成了。
这一步的关键是"获取可用模型"——它让导演大师直接读取 Ollama 本地服务暴露的模型列表,不需要手动填地址和参数。
提供方(Provider) 是 Agent 工具中抽象模型来源的配置单元。一个提供方代表一种模型服务后端,例如 OpenAI、Anthropic、DeepSeek广告 或本地的 Ollama。每个提供方包含服务地址、鉴权方式和可用模型列表等字段。导演大师把 Ollama 作为一种提供方接入,意味着它并不绑定特定模型,而是通过标准接口读取本地服务上有哪些模型可选。这也解释了为什么作者能同时看到 3.5 和 3.8 两个版本,并按任务复杂度切换——切换模型只需在提供方下更换默认模型,无需改动工作流本身。
用本地千问跑通一支短片的全流程
配置完成后,教程用本地千问 3.8 演示了一次完整的视频制作流程,主题是"做一部三岁小孩的动画片"。
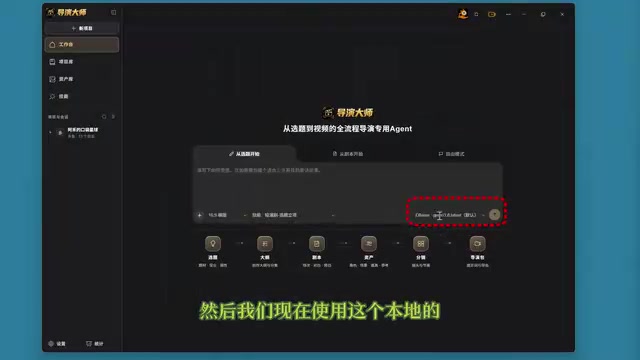
选题阶段:输入需求后,Agent 返回几个选题选项,任选其一。系统给出选题草稿确认卡,创作者检查无误后点击"保存为正式选题",短片制作正式启动。
大纲阶段:点击智能 Agent 生成创作大纲,大纲输出后同样需要在确认卡上保存为正式大纲。
剧本阶段:先生成第一集剧本,点击智能 Agent 直接发送生成请求;拿到剧本草稿并确认后,保存为正式剧本。
分镜阶段:把第一集剧本拆成分镜,生成并发送。第一场分镜拆完后,可以选择自动拆完剩余场次,也可以只写入当前分镜。
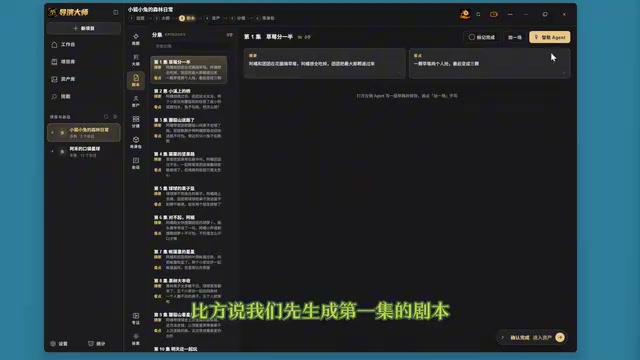
教程在这里明确收尾:生成资产等后续环节不在本期范围内,会用专门的视频讲解。
这套组合的实用价值与边界
从流程设计看,导演大师的"草稿确认卡"机制值得一提:每一步 Agent 输出都先进入草稿态,人工确认后才落为正式内容。这在本地模型场景下尤其重要——开源小模型的输出稳定性不如云端旗舰模型,人工卡点能避免错误在流程中层层放大。
另一个值得注意的设计是模型可切换:作者本地同时装了 3.5 和 3.8 两个版本,意味着可以按任务复杂度选择不同规模的模型,比如大纲用大模型、分镜拆解用小模型。
边界同样清晰:本地模型的能力上限取决于硬件和模型规模,教程演示的是流程跑通,而非输出质量的横向对比;分镜之后的资产生成环节也未展开,整条链路的完整性还有待后续验证。
适合谁上手
如果你已经有 Ollama 使用经验、手头有存储空间充裕的机器,这套配置流程的实操成本很低——核心操作就是"装 Ollama、拉模型、在导演大师里添加提供方"三步。真正需要投入时间的是流程本身:选题、大纲、剧本、分镜每一环都要人工审校,Agent 负责起草,创作者负责判断。
相关推荐
导演大师配置Ollama本地模型全流程教程
B站教程完整演示导演大师配置Ollama本地模型的方法:从Ollama安装、模型路径设置、千问模型下载,到在导演大师Agent设置中接入本地模型,并用本地千问3.8跑通选题、大纲、剧本和分镜全流程。
本地大模型部署三条路线:个人、企业、专用引擎怎么选
本地大模型部署分三条路线:个人端 Ollama、LM Studio、LLaMA.cpp 如何取舍;企业端 vLLM 与 SGLang 的内存复用模式差异;专用引擎 NIFL、Halogen、Strix 的适用边界。用三个问题帮你选对工具。

本地大模型写一周代码实测:能否替代云端Claude
一台64GB内存的消费级迷你主机,能否用开源本地大模型替代云端Claude写代码?一周实测覆盖Qwen 3.8、Muse Glimmer、GLM 4.7 Flash在VS Code、CLI与AI代理中的表现,揭示本地模型当前真正的可用边界与混合架构方案。