本地大模型部署三条路线:个人、企业、专用引擎怎么选
本地大模型部署分个人单机、企业并发、专用引擎三个战场,选错战场努力白费。
文章借用 B 站 UP 主的谱系图,把本地大模型部署划分为三个递进战场。个人单机端 LLaMA.cpp、Ollama、LM Studio 同源不同层,分别是引擎、服务封装和桌面 GUI,选型取决于愿意付出的学习成本。企业并发端的分水岭从“能否跑起来”变成“KV Cache 怎么分配”,vLLM 用 PagedAttention 管显存广度,SGLang 用 RadixAttention 复用重复前缀,流量杂而广选前者,前缀密集选后者。专用引擎 NIFL、Halogen、Strix 主动放弃通用性换取极致性能,但隐性成本高,只适合做第二引擎。最终选型只需回答三个问题:几个人用、流量是否重复持前缀、是否有值得牺牲通用性的固定模型加硬件组合。
很多人第一次尝试本地大模型,都会遇到同一个困惑:同样的模型,有人五分钟就跑起来了,有人折腾五天还在报错。问题通常不在操作者水平,而在于本地部署其实藏着三个完全不同的战场——个人单机、企业并发、专用引擎。选错战场,再努力也是白费力气。
B站UP主用一张谱系图把这件事讲清楚了:从左到右,能力越来越强,但路也越走越窄。理解这条谱系,至少能少走半年弯路。
个人单机:LLaMA.cpp、Ollama、LM Studio 不是竞品
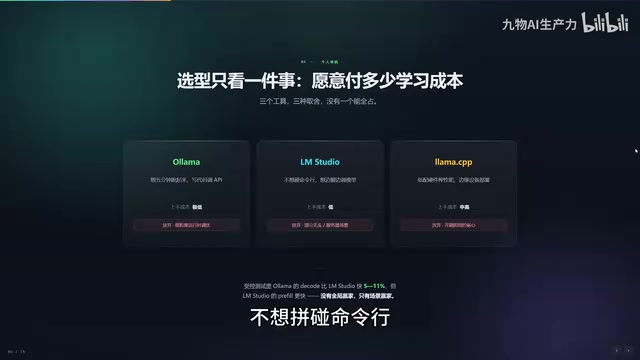
最左边是个人端的三件套:LLaMA.cpp、Ollama、LM Studio。很多人误以为它们是三个互相竞争的产品,实际上它们跑在同一个底层上。
据UP主解释,LLaMA.cpp 本身是推理引擎,负责跑 GGUF 格式的模型,所有控制权都在你手里。Ollama 是架在引擎上面的后台服务加模型管理器,替你管模型、管生命周期。LM Studio 则是桌面图形应用,替你把可视化打包全包。打个比方:LLaMA.cpp 是发动机,Ollama 是装好发动机的车,LM Studio 是带仪表盘和中控屏的车——底下跑的是同一套东西。
那个人端怎么选?主要看你愿意为它付多少学习成本。
- 想五分钟就跑起来、顺手写代码调 API:选 Ollama,上手门槛极低,一句
ollama run就能把模型跑起来。代价是没办法对细颗粒度的运行进行调优。 - 不想碰命令行、想边聊边把模型调一调:选 LM Studio,可视化程度最高。代价是部分无头场景、服务器场景没那么顺手。
- 想榨干硬件性能、或者上边缘设备:用 LLaMA.cpp,控制权最大。但开箱即用的那份省心就没了。
还有一个反直觉的点:虽然 Ollama 和 LM Studio 都基于 LLaMA.cpp,但 Ollama 的 decode 比 LM Studio 快 5% 到 10%,而 LM Studio 的 prefill 填充会更快。所以没有全局赢家,只有场景赢家。
企业并发:vLLM 与 SGLang 的分水岭在内存复用模式
什么时候该从个人端切到企业端?UP主给出的判断很简单:当你开始锁并发的时候。Ollama 的服务模式天生是给一个人、一个请求的低并发场景设计的。一旦变成十个人同时使用,或者 agent 在循环里反复打同一个模型,瓶颈立刻换位置——从“能不能跑起来”变成“显存里每一块 KV Cache 到底怎么分配”。这道断崖就是整个企业端的体验。
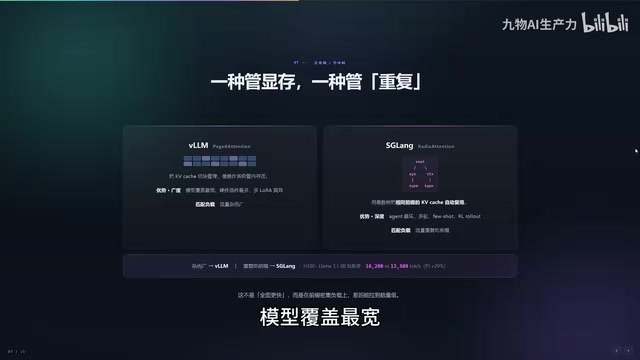
到了企业端,先别急着站队。vLLM 和 SGLang 的共识比分歧更基础:都是 Apache 2.0 协议,都提供 OpenAI 兼容接口,都支持 Prefix Cache、投机解码、多卡并行等等。所以根本不是“有没有”的问题。真正要问的是:把钱压在哪一种内存复用模式上。
vLLM 管显存。 它的 PagedAttention 把 KV Cache 切成一块一块来管,思路跟操作系统管内存页一样。优势是广度和可预测性:模型覆盖最宽,硬件插件从 TPU 一路到昇腾,多 LoRA 也很高效。如果你的流量杂而广,选 vLLM。
SGLang 管重复。 它用 RadixAttention 把相同前缀的 KV Cache 复用起来。Agent 循环、多轮对话这些反复持同一段前缀的操作,能把它的剩余价值榨干。如果你的流量重复持前缀,选它。
UP主给了一个参考数据:在 i7-100 上跑 Llama 3.1 8B 模型时,SGLang 大概 16200 tokens/s,vLLM 大概是 12500 tokens/s,差了约 30%。但注意,这不是全面更快,而是它擅长的前缀密集负载更快——差距可以拉到数量级。所以结论是:杂而广选 vLLM,复杂持前缀选 SGLang。
KV Cache(Key-Value 缓存)是理解企业端选型的关键。大模型在自回归生成时,每生成一个新 token 都要重新计算之前所有 token 的注意力 Key 和 Value 矩阵。如果不做缓存,生成第 N 个 token 就要重算前 N-1 个,计算量随长度平方增长,完全不可接受。KV Cache 就是把已算过的 K、V 存在显存里,后续直接复用。代价是它非常吃显存——上下文越长、并发越高,占用越大。因此企业端的核心矛盾不是算力不够,而是显存里 KV Cache 怎么分。vLLM 的 PagedAttention 和 SGLang 的 RadixAttention 都是在解这道题,只是思路不同:前者像操作系统分页一样管理碎片,后者像字典树一样共享相同前缀块。
前置填充(Prefill)与解码(Decode) 是推理过程两个阶段,性能特征完全不同。Prefill 阶段模型一次性处理用户输入的整段 prompt,所有 token 并行计算,属于计算密集型,能吃满 GPU 算力,所以常以 tokens/s 衡量吞吐。Decode 阶段则是逐 token 串行生成,每步只算一个 token,但每步都要读取全部模型权重和 KV Cache,属于内存带宽密集型,延迟敏感。这也解释了前文的现象:Ollama 与 LM Studio 虽同源,却因调度策略不同而在两个阶段互有胜负。企业选型时,长 prompt 场景看 prefill 吞吐,长输出场景看 decode 速度,两者要分开评估。
专用引擎:用不兼容换取极致性能
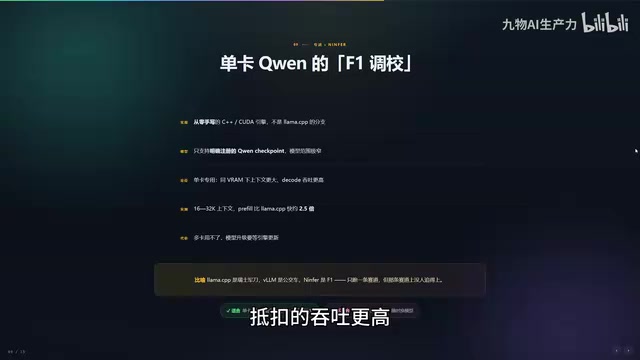
最右边是专用引擎。它们不是更快的通用引擎,准确说,是主动放弃了通用性的引擎。UP主举了三个例子:
NIFL:纯 C++ 写的推理引擎,不是 LLaMA.cpp 的分支,也不是它的替代品。定位就是专卡专用,价值在极端单卡场景——同样的显存能开到的上下文更多,decode 吞吐更高。实测 16 到 32K 上下文预填充比 LLaMA.cpp 大概快 2.5 倍。代价也很明确:多卡用不了,模型范围极窄,模型升级你还在等引擎更新。LLaMA.cpp 是瑞士军刀,vLLM 是公交车,NIFL 是 F1——只跑一条赛道,那条赛道上没人追得上它。
Halogen:专一性更极端。它精确为 AMD 的 Strix Halo 芯片(GFX1151)加一个模型家族优化,没有浏览器 UI,纯 API 后端,原生实现了 Anthropic API,Cloud Code 可以直接连本地模型。32K 上下文下,端到端比同平台最快的公开方案快 1.4 到 2.1 倍,精度还更高。它的权重是自有的 .HGN 格式,vLLM 和 LLaMA.cpp 都加载不了。官方描述很赤裸:没有通用 Runtime,没有可移植层,没有 fallback 路径。所以它能做通用引擎做不到的事,也因此只能在一块硅片上跑。
Strix:逻辑又不一样。NIFL 和 Halogen 优化的是速度,Strix 优化的是“能不能”的问题——比如一个 125B 参数的模型能在 12 到 20G 显存的消费级显卡上跑。它主要做三件事:MoE 专家按频率分层缓存(高频专家放显存,全量专家放内存),静态路由表放 SSD,再叠上稀疏注意力和投机解码。它几乎是给一个模型量身定做的,不是通用框架。
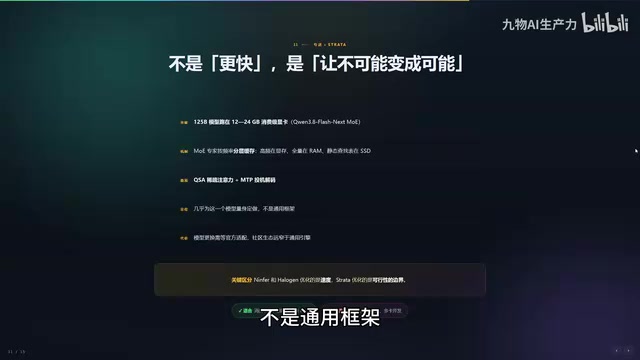
目前它支持的也比较少,主要是一个模型家族,解决的是能不能跑,但不一定跑得特别快。尤其是某些新模型,速度非常慢,但至少能跑。
MoE(混合专家) 是 Strix 能突破消费级显卡显存天花板的前提。传统稠密模型每次推理都要加载全部参数,125B 模型即使量化后也远超 20G 显存。MoE 把模型拆成多个专家子网络,每个 token 只激活其中少数几个,因此单次计算量远小于总参数量。但全部专家权重仍需存放,Strix 的思路正是利用“专家激活频率不均”这一特性做分层缓存:高频专家常驻显存,低频专家留在内存甚至 SSD,配合静态路由表预判激活路径,从而用有限显存跑起大模型。代价是路由和换入换出带来额外开销,所以速度不一定快,但至少“能跑”。
专用引擎的隐性成本与选择逻辑
专用引擎的隐性成本其实比较高,不然的话科普就变成推荐了。UP主列出了三条:模型升级你得等引擎更新,不是换个模型文件就完事;硬件一换,引擎直接不可用;多卡、多用户、动态模型路由压根不在设计目标里。社区生态和文档路径也远比 LLaMA.cpp 和 vLLM 窄。
所以专用引擎最合理的位置是第二引擎。主力用通用引擎覆盖广度,专用引擎放在你确认会长期复用的极窄场景上做加速端点。判断标准非常简单:如果你需要问它“能不能跑别的模型”,答案已经是否定的了。
专用引擎与通用引擎的本质区别在于是否保留可移植层。通用引擎如 vLLM、LLaMA.cpp 会在模型格式、硬件后端、调度策略之间保留抽象层,牺牲一点峰值性能换取广泛兼容。专用引擎则把这一层整个删掉:Halogen 只认 Strix Halo 的 GFX1151 指令集和自有 .HGN 权重格式,NIFL 只针对特定单卡和窄模型范围,Strix 几乎为单一模型家族定制。删掉抽象层后,编译器可以做更激进的算子融合、内存布局和内核特化,这是它们能快出数倍的真正来源。但这也意味着任何一层变化——换卡、换模型、加并发——都可能导致整个引擎不可用,而不是简单配置调整。
三个问题决定你的路线
最后别问哪个最好,先回答三个问题:
- 几个人用? 一个人用,留在个人端;一群人用,往下走。
- 你的流量重复持前缀吗? 是,就选 SGLang;扎尔广、多劳尔,就优先 vLLM。
- 你手上有没有一个值得为它牺牲通用性的固定模型加固定硬件组合? 有而且能接受生态窄,那专用引擎就做加速端点;没有,就老老实实待在通用引擎。
本地部署的成熟,不是找一个万能工具,而是知道在什么边界上换什么工具。UP主最后用一张速查卡总结了:Ollama 是一行命令的模型服务化封装,LM Studio 是桌面实验台,LLaMA.cpp 是能亲手拧每一颗螺丝的推理引擎,vLLM 是广度优先的通用高吞吐服务器,SGLang 是前缀复用深度优化,NIFL 是单卡极致的专用端点,Halogen 是 Striker Halo 的硅片专属引擎,Strix 是用 MoE 分层缓存打破消费级显卡天花板。
相关推荐
导演大师配置Ollama本地模型全流程教程
B站教程完整演示导演大师配置Ollama本地模型的方法:从Ollama安装、模型路径设置、千问模型下载,到在导演大师Agent设置中接入本地模型,并用本地千问3.8跑通选题、大纲、剧本和分镜全流程。
导演大师接入Ollama本地模型:配置与全流程创作实战
B站教程详解导演大师如何接入Ollama本地模型:从安装Ollama、设置模型存储路径、命令行拉取千问模型,到在Agent设置中添加提供方,并用本地千问3.8跑通选题、大纲、剧本、分镜的短片创作全流程。

本地大模型写一周代码实测:能否替代云端Claude
一台64GB内存的消费级迷你主机,能否用开源本地大模型替代云端Claude写代码?一周实测覆盖Qwen 3.8、Muse Glimmer、GLM 4.7 Flash在VS Code、CLI与AI代理中的表现,揭示本地模型当前真正的可用边界与混合架构方案。