16GB显存跑27B大模型:Qwen3与MiniMax H3本地视频生成实测
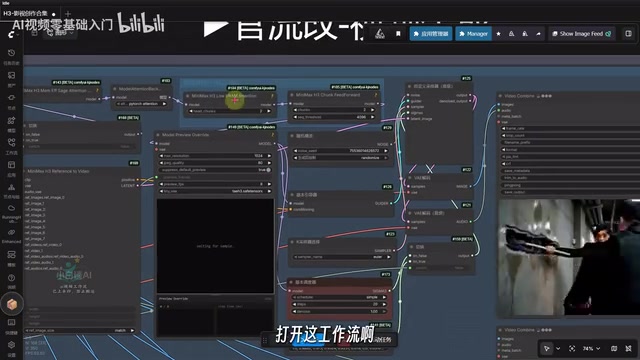
一套可在16GB显存中端机上本地运行的ComfyUI工作流集合,整合视频生成、文生图与图像编辑。
本文介绍了一套基于ComfyUI的开源AI创作工作流集合,核心亮点是将Qwen3语言模型与MiniMax H3视频生成模型整合到可在消费级硬件(16GB显存)上运行的完整pipeline中。集合提供两套视频生成方案:速度优先的"二采"工作流和质量优先的"关流改造"工作流,后者在中端配置下生成一段视频约需11分钟。视频生成模块内置加速节点,用户可在速度与画质之间灵活取舍。此外,集合还涵盖文生图和人脸替换等图像编辑功能,支持中文提示词但英文效果更佳。对于预算有限、希望摆脱付费闭源工具的本地AI影视创作者,这套方案提供了一条可行的替代路径。
低显存也能玩转大模型创作
开源AI创作工具的门槛正在快速降低。这套结合了Qwen3系列语言模型与MiniMax H3视频生成能力的ComfyUI工作流集合,最引人注目的地方在于它对硬件配置的宽容度——UP主用一台配备5060Ti显卡、16GB显存、32GB DDR4内存的中端机器,就能完整跑起来。
对于大多数没有专业工作站的创作者来说,这个配置门槛意味着本地部署不再是遥不可及的事情。视频中特别提到,工作流里设置了两个专门服务于低显存用户的节点,通过调节数值参数就能控制资源占用。
需要说明的是,视频标题中出现了"Qwen3.6""Qwen3.8"等表述,实际指向的是Qwen3系列开源模型的不同版本,读者在获取资源时需注意版本对应关系。
视频生成模块:速度与质量的权衡
这套集合的核心是两份视频生成工作流,分别对应不同的使用场景。据UP主实测,在其16GB显存配置下,将关键参数填为2,即可生成80万像素、15秒的长视频。
这里有个值得关注的画质判断标准:视频中提到,像素总量在0.7(约70万像素)往上就属于中高像素画质,而实测输出普遍在70万到80万像素之间,画面没有出现"崩脸"现象,人脸参考的精准度也保持得不错。
工作流中有一个加速节点值得留意——开启它可以显著缩短生成时间,关闭后生成质量会更好,但耗时可能翻倍。这是一个典型的速度与质量的取舍,创作者可以根据实际需求灵活选择。
视频生成中提到的"加速节点",在ComfyUI生态中通常指基于一致性蒸馏或流匹配加速技术(如LCM、TCD或Hyper系列LoRA)实现的推理步数压缩方案。传统扩散模型需要20至50个去噪步骤才能生成高质量图像或视频帧,而加速节点可以将步数压缩至4至8步,生成时间大幅缩短,代价是细节还原度和动态一致性有所下降。在视频生成场景中,这一取舍尤为明显:加速模式下人物面部细节和运动流畅度往往会打折扣,而关闭加速后虽然耗时翻倍,但输出质量更接近模型的理论上限。创作者可以先用加速模式快速验证构图和动作是否符合预期,再用高质量模式出最终成片。
MiniMax H3:中文可用,英文更佳
视频生成部分依赖MiniMax H3模型。据UP主介绍,H3支持中文提示词输入,但对英文的理解会更加到位,因此实际操作中仍推荐使用英文提示词。
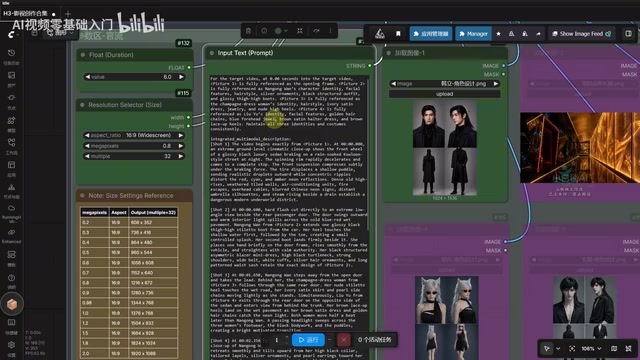
在实际操作层面,使用者拿到集合后需要先重新选择模型路径,因为作者的模型放置路径与他人不同。视频参考、音频参考、参考图等节点的使用逻辑基本一致:放入参考图、填写提示词、设置视频比例(9:16或16:9均可)与秒数,然后运行即可。
对于打戏这类复杂动作场景,UP主表示只要提供一个足够优质的提示词,运气好时甚至不需要反复"抽卡"就能得到不错的效果,这在过去往往需要付费的商业视频生成模型才能实现。
MiniMax H3 是由国内AI公司MiniMax推出的视频生成基础模型,属于其Hailuo系列产品线中的开源版本。H3在架构上采用了线性注意力机制(Linear Attention),相较于主流的Transformer扩散模型,在长视频生成和时序一致性上具有一定优势,同时对显存的占用也相对可控。作为开源模型,H3可以在本地部署,这使其成为不愿依赖云端API的创作者的重要选择。与Sora、Kling、即梦等闭源商业模型相比,H3的本地化特性意味着无需按时长付费,生成成本理论上只有电费。其对中文的支持虽然有限,但已优于大多数同期开源视频模型,这使其在中文内容创作场景中具备实用价值。
文生图与图像编辑:一站式创作
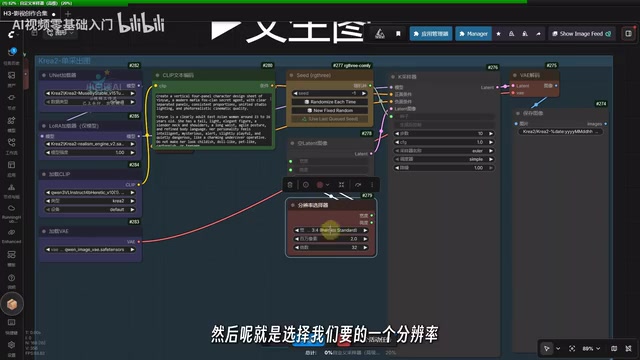
除了视频生成,这套集合还整合了文生图和图像编辑模块。图像生成模块支持中文提示词(同样英文效果更好),使用者选择模型、输入提示词、设定分辨率和百万像素即可快速出图。UP主提到出图速度非常快,像素设置不必太高,一到二百万像素就够用。
图像编辑模块支持人脸替换等操作,视频中演示了将一个角色的脸替换到另一个图意角色上,最终能保持与参考图一致的效果。UP主坦言,部分角色设计参考图是直接用闭源模型生成的,图方便;没有闭源模型的用户则可以使用集合中提供的开源图像编辑模型作为替代。
两份视频工作流怎么选
集合中提供了两套视频生成方案,选择逻辑其实很清晰。
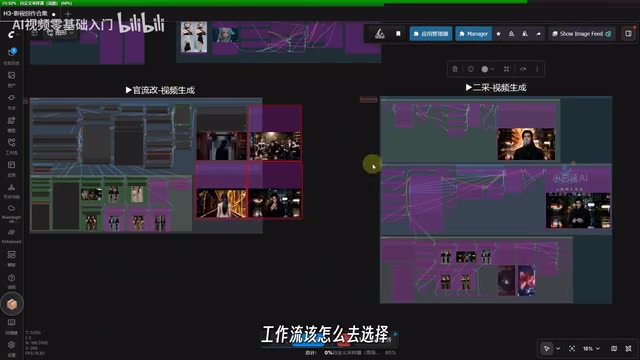
据UP主给出的结论:追求速度就用"二采"视频生成工作流;追求高质量则用基于关流改造的视频生成工作流。他个人更中意后者,认为其效果更出色。在其配置下,这份高质量工作流生成一段视频耗时约11分钟——考虑到硬件并不算高端,这个表现相当令人满意。
值得一提的是,视频中的提示词大量借助Codex(代码/文本生成工具)来撰写。这也提示了一个实用技巧:当自己不擅长写提示词时,可以借助能力更强的大语言模型来生成,从而提升出图和出视频的质量。
写在最后
这套工作流集合的价值,在于它把语言模型、文生图、图像编辑和视频生成整合到了一个可在消费级硬件上运行的方案里。对于预算有限、又想尝试本地AI影视创作的用户而言,它提供了一条替代付费闭源工具的可行路径。
当然,实测内容基于单一UP主的演示,实际效果会因硬件、模型版本和提示词质量而有较大差异。建议感兴趣的读者在部署前确认好模型版本与显存需求,再结合自身设备做调优。
ComfyUI 是一款基于节点图(Node Graph)的Stable Diffusion图形化操作界面,用户可以将不同的模型、预处理器和后处理模块以拖拽连线的方式组合成"工作流"(Workflow),并保存为JSON文件分享给他人。与WebUI等线性操作界面相比,ComfyUI的优势在于流程高度可定制,支持将语言模型调用、图像生成、视频生成等完全不同类型的AI能力串联在同一个画布上统一调度。"集合"通常是指多个相关工作流和所需模型路径的打包分发,用户导入后只需调整模型路径即可复用他人搭建好的完整pipeline,大幅降低了从零搭建的技术门槛。
相关推荐
Pangolin 1.23发布:开源VPN与反向代理迎来高可用集群
Pangolin 1.23 为开源自托管 VPN 与反向代理带来多节点高可用集群,将 DNS 与证书管理内置化,并把 Newt 隧道连接器整合进统一 CLI,大幅降低部署复杂度。
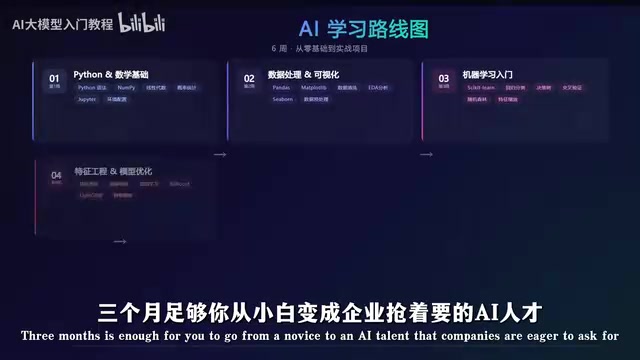
AI大模型零基础三阶段学习路线:从提示词到Agent实战
零基础AI大模型学习路线全解析:从提示词工程、API调用入门,到RAG知识库搭建,再到Agent智能体与多智能体协作实战,三阶段进阶框架帮你从小白到上手开发AI应用。
30天从零搭建AI Agent实战路线:认知、实战到接单全流程
一份AI Agent零基础30天实战路线图:从认知层理解感知决策执行记忆,到实战层搭建RAG问答、工具调用、工作流三类Agent,再到项目层跑通企业级全流程,帮你从小白到独立接单。