#本地部署
共 414 篇相关文章

本地运行AI模型全指南:推理引擎与工具栈解析
系统梳理本地运行AI大模型的完整工具栈:从PyTorch、GGML等计算库,到llama.cpp、vLLM、SGLang等推理引擎,再到Ollama、LM Studio等封装层,结合实测数据说明各工具的性能差异与选型逻辑。

Unsloth v0.1.913-beta 发布:自定义背景、性能翻倍与本地大模型体验升级
Unsloth v0.1.913-beta 发布,新增自定义背景、14 种语言与全新界面布局,应用更新时间减半,Qwen-Image 在 16GB 显存下渲染提速 2 倍,并引入 DeepSeek-V4.1-Flash-1017 与 Dynamic v3.1 GGUFs 预览。

大模型价格暴跌80%:开源本地AI正在改写行业规则
OpenAI与Anthropic将大模型价格下调高达80%,IBM称开源权重模型达前沿模型90%性能、仅10%成本。本文梳理价格战背后的补贴逻辑、本地部署与云服务的取舍,以及上下文工程、推理模型课程等AI工具链最新动向。

64GB内存+16GB显存,哪些开源模型限制少?
Reddit 用户提问 64GB 内存加 16GB 显存适合哪些限制少的开源模型。本文梳理社区常提到的 Mistral、Llama、Yi、Qwen 等低拒绝率微调方向,分析去对齐模型的实际风险与硬件瓶颈,帮你根据用途做出选择。

Ollama思考完不输出答案?原因与解决思路
Ollama运行Qwen 3.5 9B时思考过程结束却不输出答案?本文分析这一Reddit用户反馈的典型问题,从模型模板、停止词、生成参数等角度给出排查思路与解决方向,帮助本地部署用户定位思考型模型的输出截断问题。

狂烧10亿Token!IndexTTS 2.0开源语音工作台全解析
IndexTTS 2.0开源长篇台本工作台全解析:支持剧本导入、角色台词整理、参考音频批处理、多轨编辑与情感控制,可导出工程文件对接Reaper,附整合包安装步骤与适用人群分析。

零成本本地Jarvis:开源语音克隆与任务自动化实战
AI Workshop演示如何用Ollama与Voice Studio零成本搭建本地Jarvis:本地模型切换、开源语音克隆、文件检索与工具调用实测,附部署步骤与硬件取舍分析。

单卡12G跑本地实时语音AI:35B模型+语音对话全流程
国外开发者展示如何在单张12GB显卡上本地运行35B MoE语言模型、Whisper语音识别与Breeze TTS2语音合成,通过流式转录、并行合成与量化优化,将端到端语音对话延迟从8秒降至2-3秒,并接入Agent工具调用场景。

海外博主实测千亿MoE模型本地部署:量化与工具调用的关键教训
海外博主实测阿里 Quen 3.8 Flash Next 千亿 MoE 模型在 Strix Halo 迷你主机和 CUDA 工作站的本地部署,揭示量化精度对工具调用成功率的影响,以及 Strata、GUFO 推理引擎的实战表现。

巴掌大设备一键部署大模型:Token Router 实测
Token Router 是一款巴掌大的本地大模型部署设备,接上网线和电源即可运行对话、出图、视频、配音等开源模型。本文梳理其选型推荐、一键部署与接入 WorkBuddy 的完整流程,并分析这类对话式部署方案的实用价值与局限。
Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。

Ollama v0.40.13 更新:LFM3 音频模型登陆 Linux 与 Windows
Ollama v0.40.13 发布,Liquid AI 的 LFM3 模型(含 lfm3-audio 与 lfm3-omni 文本转语音能力)不再限于 Apple silicon,现已支持 Linux 和 Windows,本地音频模型部署门槛进一步降低。

Ollama对比OpenAI决策模型:本地推理速度实测
用真实邮件分类任务对比OpenAI Decisions API、Ollama本地模型与Jeff的推理速度:本地模型加载后约1.1秒,约为云端API的一半,且完全免费。分析决策模型场景下本地部署的速度与成本优势。

10月开源神器:Stable Diffusion本地部署全攻略
本文详细介绍Stable Diffusion本地部署全流程,包括安装准备、路径规范、模型迁移与启动创作。无需付费、无限制生成,一张消费级显卡即可拥有私人AI绘画工具,适合零基础新手。

NCM实测:比LLM快4倍还是更慢?本地测试揭示真相
斯坦福NCM模型宣称比扩散模型快31倍、解出86%困难数独。本地实测显示:单请求比同尺寸LLM快4倍,但64并发时反被超越;数独优势主要来自填格顺序而非架构本身。

云AI限流涨价?两行命令把大模型装进NAS
云AI限流涨价背景下,B站视频演示用两行命令在NAS部署本地大模型,接口开在本机11434端口,OpenAI兼容,35瓦功耗一天电费不到一块钱,并分析了本地部署的优缺点与适用场景。
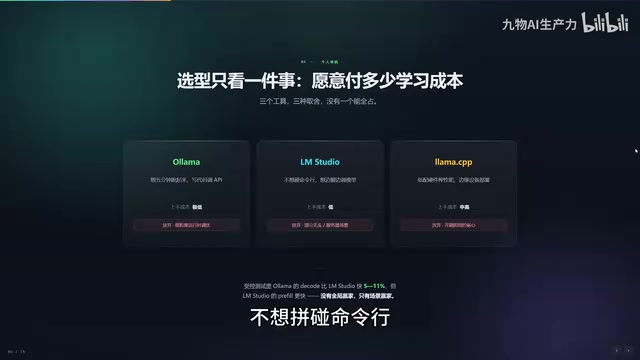
本地大模型部署三条路线:个人、企业、专用引擎怎么选
本地大模型部署分三条路线:个人端 Ollama、LM Studio、LLaMA.cpp 如何取舍;企业端 vLLM 与 SGLang 的内存复用模式差异;专用引擎 NIFL、Halogen、Strix 的适用边界。用三个问题帮你选对工具。

本地大模型写一周代码实测:能否替代云端Claude
一台64GB内存的消费级迷你主机,能否用开源本地大模型替代云端Claude写代码?一周实测覆盖Qwen 3.8、Muse Glimmer、GLM 4.7 Flash在VS Code、CLI与AI代理中的表现,揭示本地模型当前真正的可用边界与混合架构方案。

Ollama本地大模型部署避坑指南:从装好到用上只需几步
手把手讲解用 Ollama 部署本地大模型的完整流程:安装后如何修改 OLLAMA_MODELS 和 OLLAMA_HOST 环境变量避免占满系统盘并开放局域网算力,如何用 ollama run 拉取 DeepSeek、通义千问等模型,以及 list、ps、rm 三条常用管理命令和 Open WebUI 图形界面配置。