单卡12G跑本地实时语音AI:35B模型+语音对话全流程

单张12GB显卡本地跑通35B MoE语音对话栈,端到端延迟压到2-3秒。
一位开发者在单张12GB显卡上本地部署了完整的实时语音AI栈,包含Qwen 3.6 35B MoE语言模型、Whisper语音识别、Breeze TTS2语音合成和Celery VAD。他通过将MoE专家权重放到CPU、压缩上下文到32K,把全栈压进12GB显存。延迟优化分多层:流式转录让用户说话时后台已完成识别;按句切分并并行合成播放,消除长静默和句间停顿;首轮关闭思考让AI立刻开口。最大突破是语音模型的Q8量化和流式音频,速度提升2-3倍并释放显存,端到端延迟从约8秒降到2-3秒。接入Agent框架后,又用释放的显存提升micro-batch解决预填充瓶颈,并用预设短语播报填补AI工作时的沉默。
为什么要在本地跑实时语音AI?
OpenAI的Astra演示让很多人第一次感受到"和电脑自然对话"的震撼。但云端方案意味着延迟不可控、隐私外泄、费用累积。一位国外开发者在B站分享了他的尝试:把整套AI语音对话栈塞进一张12GB显卡,端到端全部本地运行。
他的目标很明确——不仅要能跑,还要快到"像和真人说话"。上一版方案还停留在5到6秒延迟,而且需要两台机器分别跑语言模型和语音模型。这次他要解决的问题是:单卡、低延迟、全本地。
模型选型:35B MoE + Whisper + Breeze TTS2
整套栈由四个核心组件构成:
- Qwen 3.6 35B(混合专家模型)负责语言理解与推理。开发者特别强调,2B或3B的小模型只是"玩具",真正能干活的Agent需要35B级别的模型。MoE架构的好处是:即使把所有专家权重放在CPU上运行,GPU上只需保留少量权重,就能维持约40 tokens/秒的生成速度——足够跟上对话节奏。
- Whisper负责语音转文字,体量很小,占用极低。
- Breeze TTS2(3.5B参数)负责语音合成。据开发者引用,该模型在Artificial Analysis排行榜上位列第一,超过Gemini和ElevenLabs,且为开放权重。
- Celery VAD负责语音活动检测,实现免提操作——判断用户何时开始说话、何时说完。
据B站UP主和YouTube频道对该项目的分析,这套组合的核心思路不是追求最强智能,而是用"够用"的模型搭配极致的工程优化。
混合专家模型(Mixture of Experts, MoE)是一种稀疏激活的神经网络架构:模型内部包含多个“专家”子网络和一个门控路由机制,每次前向计算只激活其中少数几个专家,而非全部参数。这使得总参数量可以做得很大,但单次推理的实际计算量远小于同等参数量的稠密模型。文章中的Qwen 3.6 35B即属此类,其优势在于可以把未被激活的专家权重放在CPU或系统内存中,GPU只保留路由和少量常驻权重,从而在有限显存下维持可用的生成速度。MoE的代价是显存/内存占用总量仍按全量参数计算,且推理框架需要支持专家权重的按需调度。
12GB显卡的内存分配算术
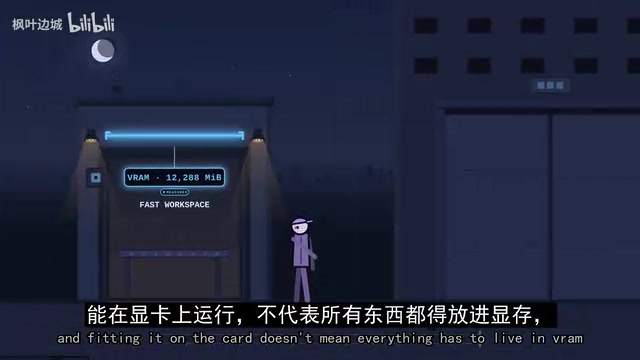
把所有模型塞进12GB显存需要精打细算。开发者的策略是:只把对速度敏感的部分放进VRAM,其余留给CPU和系统内存。
语言模型部分:专家权重放CPU,GPU上只保留不到2GB。加上上下文和计算缓冲区,整个LLM在128K上下文时约占近4GB。问题出在语音模型——Breeze TTS2需要约8.5GB(权重加运行时开销),而且必须全部在GPU上,否则响应太慢。两者相加超出12GB。
解决方式是压缩上下文:从128K降到64K,再到32K,上下文占用随之缩小。加上Whisper后,总量刚好压到12GB以下,留出少量余量应对峰值。
但这个配置下的第一版体验并不好:用户说完话到AI开口,大约需要10到11秒。更糟的是长回答——模型要写完整段文字、语音要合成完整段音频,才会播放第一个字。
延迟优化第一层:流式处理与并行化
开发者把延迟问题拆成两个:起始等待和句间停顿。
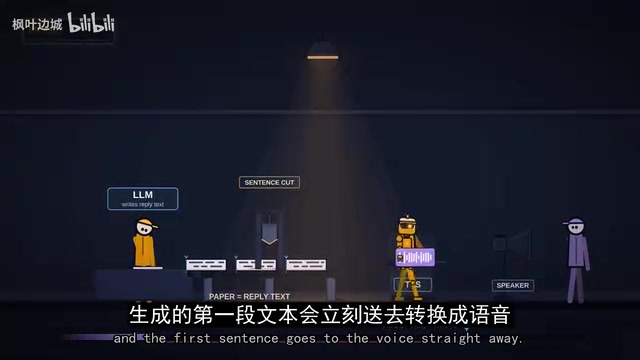
解决长静默:不再等模型写完整个回答。模型边写,文本按句切分(三个词以下的短句会并入下一句,避免语音听起来破碎),第一句立刻送去语音合成并播放,模型在后台继续写。这一步显著改善了"说一句话等半天"的问题。
解决句间停顿:语音播放第一句的同时,合成下一句。完成的句子进入队列,最多保留两句待播。模型写、语音合成、扬声器播放三件事并行进行。效果是句子之间基本能连贯衔接,只有遇到特别长的句子时偶尔出现短暂停顿。
开发者坦承,他的语音生成速度约为实时的1.1倍,刚好比播放速度快一点,所以偶尔仍有间隙。但这个速度是"能接受"的下限。
流式处理(streaming)指模型或组件不等完整结果生成完毕就分段输出,使下游环节可以提前开始工作。在语音对话链路中,它体现在三个层面:语言模型逐token输出而非等整段回复写完;文本按句切分后立即送入语音合成;语音模型边合成边把音频片段推给扬声器。与之配套的“并行化”是指写文本、合成语音、播放音频三个流水线阶段同时进行,用队列控制缓冲深度。流式处理能显著降低首字延迟和句间停顿,但对各环节的吞吐速度有下限要求——合成速度必须略快于实时播放速度,否则队列会被掏空,出现断续。
延迟优化第二层:流式转录与思考控制
起始等待的根源是串行流水线:等你停止说话→录音送去转录→模型阅读并思考→写出第一句→语音合成完整句→播放。每一步单看都很快,叠加起来就是七到八秒。
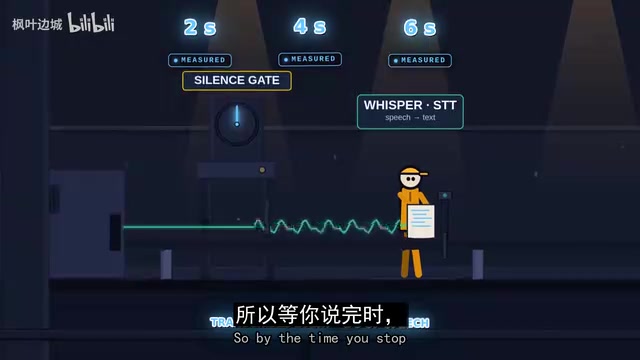
流式转录:用户还在说话时,每隔一小段时间就在后台转录,等用户停下,文字已经就绪。据开发者描述,这样转录环节几乎不再占用额外等待时间。
保留1秒静默判定:开发者刻意保留了约1秒的静默等待,避免用户思考时被打断。对习惯用"嗯""啊"填充停顿的人,这个等待可以调短。
首轮关闭思考:Qwen是思考型模型,回答前会先推理,有时仅为说一句"你好"也要想很久。他的做法是:用户说完后的第一轮响应关闭思考,后续的工具调用和实际工作仍保留思考能力。这样AI能立刻开口,而不是先规划怎么打招呼。
关键突破:语音模型量化与流式音频
一个意外发现带来了最大收益:开发者一直运行的是Breeze TTS2的完整BF16版本,官方代码不做量化。切换到audio.cpp和Q8量化版本后,音质听不出差别,但生成速度提升到原来的2到3倍,释放出可观的显存空间。
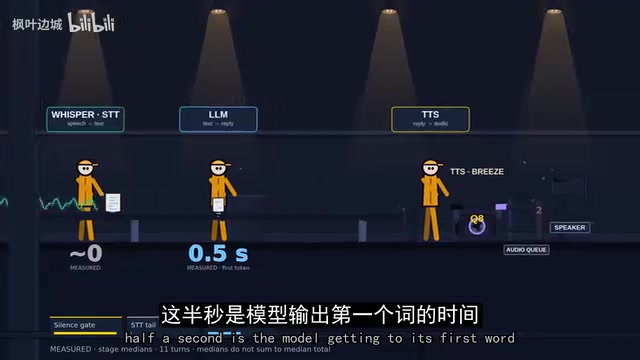
audio.cpp支持流式音频输出,扬声器不再等整句合成完毕,语音一开始生成就能播放。这一改动几乎消除了句间停顿问题。综合优化后,端到端延迟从约8秒降到2到3秒,测量中位数在3.5秒以内。
延迟的构成也清晰了:约1秒是刻意保留的静默判定,很短时间是模型产出第一个词,剩下大部分是语音模型生成第一个音节的时间。
量化(quantization)是把神经网络权重从高精度浮点(如BF16、FP16)转换为低精度整数(如INT8)的过程,目的是减少显存占用并利用更快的低精度计算指令。Q8量化即把权重量化为8位整数,通常配合缩放因子在推理时反量化或直接以整数运算。对语音合成模型而言,量化能在几乎不损失听感的前提下把权重体积压缩到原来的约一半,同时提升生成吞吐。文章提到的audio.cpp是一个面向音频模型的C++推理框架,类似llama.cpp之于语言模型,它支持GGUF等量化格式和流式音频输出,使得语音模型可以脱离官方PyTorch代码、在消费级显卡上高效运行。
Agent场景的新挑战:预填充与"说话"
语音聊天只是起点。开发者把这套系统接入了自己的Agent框架Pythagoras,给AI配了浏览器、终端和画布,并加入工作面板,让用户能看到AI在做什么。
预填充瓶颈:聊天消息只有几百token,网页动辄上万token。原配置的预填充速度低于200 tokens/秒,仅一个YouTube页面就有约15000 token,模型读了近一分半钟。原因是micro-batch size设为128。利用语音量化释放出的空间,他把micro-batch提升到1024,并把部分专家层移回GPU,预填充速度提升到约800 tokens/秒。剩余空间还放入了MTP(加速工具调用预测)和视觉编码器,上下文从32K提升到100K。对话缓存保存在磁盘上,切换会话再回来无需重读。
用语言填补沉默:Agent工作时不出声,用户无法判断它是在工作还是卡住了。解决方案不是提速,而是让AI说话。每条来自语音界面的消息都带标签,系统提示要求回复简洁、调用工具前先说出要做什么。对于读工具输出或思考时的静默,系统会从预设短语中随机挑选一句播报。上下文压缩时,AI也会直说"上下文快满了,让我压缩一下对话"。
这套方案的可复制性
开发者强调,所有数字——权重、上下文、计算缓冲区、语音模型——都可以按自己显卡的容量重新推算。显存更少,就缩小上下文或换更小的语音模型,方法论不变。他最后让AI实际执行了一个任务:去r/LocalLLaMA看最新帖子并生成报告,AI完成得相当流畅。
这套系统离Astra还有距离,智能水平不如云端方案。但正如开发者所言,让体验"像未来"的往往不是原始智能,而是界面本身。模型是可以随时替换的那一块——本地模型每隔几个月就变强,换上新模型,周围所有工程优化都会跟着受益。
完整的代码以开源形式发布在开发者的GitHub上,他鼓励大家在自己的机器上尝试并提交PR。
背景补充
预填充(prefill)是大模型推理的两个阶段之一:输入提示词的所有token需要先一次性通过模型计算,生成KV缓存,之后才进入逐token解码(decode)阶段。预填充的计算量与输入长度成正比,且通常是计算密集型的矩阵运算,因此其速度(tokens/秒)决定了模型“读完”一段长文本要多久。聊天场景输入只有几百token,预填充耗时可忽略;但Agent读取网页时输入可达上万token,预填充就成为主要瓶颈。micro-batch size指一次前向计算中并行处理的样本数,适当增大可提高GPU利用率、加快预填充,但会占用更多显存,需要与上下文长度、模型权重争抢空间。
相关推荐

Microsoft Fabric数据库Agent实战:从被动救火到智能侦探
深入解析Microsoft Fabric数据库Agent的功能与配置方法:如何启用、支持的监控场景、阻塞问题演示,以及从被动响应到自主运维的产品路线图。
Zendesk用ChatGPT Enterprise打造千名日活销售Agent
Zendesk向全员开放ChatGPT Enterprise,员工自行构建约600个应用,其中销售扩张智能体日均约1000名活跃用户。本文分析其如何将内部数据转化为销售机会,以及“不要等待”的落地策略。

谷歌发布Gemini 4 Carbon:最强模型首发主打网络安全
谷歌发布Gemini 4 Carbon,称其为最强模型,主打网络安全能力,第三方综合排名以59分居首但领先优势仅一两分。本文解析其安全测试表现、分阶段开放策略、Token定价及自测与第三方测试在幻觉问题上的分歧。