Ollama思考完不输出答案?原因与解决思路

Ollama运行Qwen 3.5 9B时思考过程完整但答案缺失,问题根源在模板或参数配置而非硬件。
文章分析了一位用户在EndeavourOS上通过Ollama运行Qwen 3.5 9B模型时遇到的典型问题:模型完整输出思考过程后,最终答案却消失,仅剩光标等待输入。尽管硬件配置(AMD 6700 XT 12GB、i5-13600K、32GB内存)足以运行9B模型,但问题可能源于模型模板对思考结束标记处理不当,或停止词、最大生成长度(num_predict)等参数设置导致生成被提前截断。作者建议按顺序排查:确认模型版本与Modelfile模板、检查停止词与长度参数、对比非思考模式、查看运行日志。文章强调,思考型模型为本地部署工具链带来了思考段与回答段衔接的新挑战,硬件达标只是第一步,软件层面的匹配同样关键。
问题现象:思考过程结束,答案却“消失”了
一位用户在 EndeavourOS(Arch Linux)上通过 Ollama 运行 Qwen 3.5 9B 模型时,遇到了一个颇具代表性的问题:模型会完整地输出长篇的思考过程,计时显示耗时大约 15 到 30 秒,随后屏幕就只剩下一个闪烁的光标,等待用户输入下一个问题——真正的答案始终没有出现。
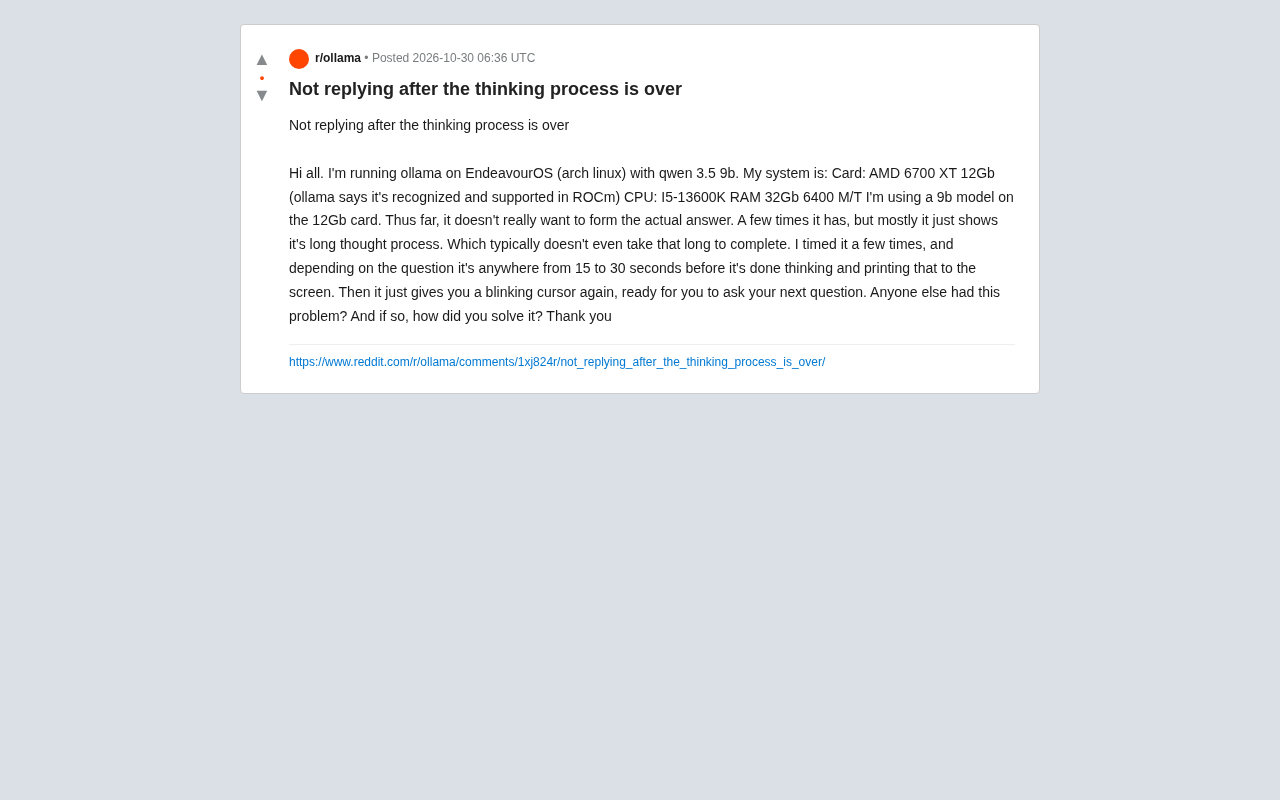
从硬件配置来看,这台机器并不弱:AMD 6700 XT 12GB 显卡(Ollama 报告已被 ROCm 识别并支持)、i5-13600K 处理器、32GB 6400 MT/s 内存。在 12GB 显存上跑 9B 模型理论上压力不大,所以问题大概率不在“算力不够”,而在于推理流程或配置层面的某个环节。
为什么会出现“只思考、不回答”?
思考型模型的输出现象
Qwen 3.5 这类带有显式思考(thinking)能力的模型,在生成最终答案之前会先输出一段推理过程。正常情况下,思考结束后模型应当继续生成正式回复。但在这位用户的场景里,思考结束即中断,说明模型在“思考段”和“回答段”的衔接处被切断了。
一个常见的诱因是生成被提前终止。当模型输出到某个特殊标记(例如思考结束标记)时,如果运行环境对该标记的处理不当,就可能把后续内容当作空回复,或者直接结束本次生成。
思考型模型(如 Qwen 3.5、DeepSeek广告-R1 等)在架构上通过特殊标记(如 Thinking 或 ``)来区分内部推理过程与最终答案。这些标记在训练时被注入,使模型学会在标记之间生成链式推理,标记之后输出正式回复。推理运行时(如 Ollama)需要正确解析这些标记:通常会在思考段结束时插入停止序列或切换生成模式。如果模板未对齐标记格式,或停止词误将思考结束标记视为终止信号,就会导致生成在衔接处被切断,从而出现“只思考、不回答”的现象。
上下文与参数设置
另一个方向是参数配置。生成参数中的停止词(stop tokens)、最大输出长度限制,以及上下文窗口大小,都可能影响最终答案是否被输出。如果停止序列恰好匹配到了思考段的结尾标记,模型就会在思考完成后立刻停止生成,表现为“只思考、不回答”。
此外,显存虽然够用,但模型的部分层可能因显存分配策略被放到 CPU 上运行,这会拖慢速度,不过通常不会导致答案消失。用户提到思考过程本身耗时不长,也从侧面说明推理速度不是瓶颈。
排查与解决思路
检查模型模板与版本
首先值得确认的是所用模型的 Modelfile 模板是否正确。Ollama 通过模板来组织对话格式,如果模板对思考标记的处理与模型本身不匹配,就会出现输出截断。建议拉取官方最新版本的模型,并检查是否存在对应的非思考(non-thinking)变体可用于对比测试。
Modelfile 是 Ollama 用于定义模型行为的配置文件,其中 TEMPLATE 指令规定了对话的格式(如系统提示、用户消息、助手回复的拼接方式),PARAMETER 指令则设置停止词、温度等生成参数。对于思考型模型,模板必须包含对思考标记的正确处理,例如在助手回复前插入思考起始标记,并在思考结束后切换至答案生成。如果模板缺失或错误,模型可能无法识别思考段的结束,导致输出截断。用户可通过 ollama show --modelfile <模型名> 查看当前模板,并与官方仓库中的最新版本对比。
调整生成参数
可以尝试在请求中显式设置停止词,避免误伤思考结束标记;同时适当提高 num_predict(最大生成 token 数),排除因长度限制导致的提前截断。如果问题依旧,可以临时关闭思考模式,观察普通模式能否正常输出答案,以此判断问题是否出在思考段的衔接上。
停止词(stop tokens)是生成时用于提前终止序列的标记,常见如 `
、<|im_end|>等。若停止词列表包含了思考结束标记(如 ``),模型在输出该标记后便会停止,后续答案无法生成。**num_predict** 参数限制单次生成的最大 token 数,若设置过小(如低于思考段长度),模型会在思考过程中被强制截断,同样表现为无答案。建议在请求中显式设置stop参数排除思考标记,并将num_predict` 调高至 2048 以上,以确保有足够空间生成完整回复。
关注社区反馈与日志
用户提到“有没有人遇到同样问题”,这其实是很好的排查起点。Ollama 与具体模型版本的兼容性问题往往会在社区中被快速反馈。查看 Ollama 的运行日志(提高日志级别)能看到生成在何处终止,是定位问题的关键线索。
Ollama 的日志级别可通过环境变量 OLLAMA_DEBUG=1 或启动参数 --debug 调整,启用后会输出详细的请求解析、模板渲染和生成步骤信息。日志中会显示实际使用的停止词、生成的 token 序列以及终止原因(如 stop、length)。若终止原因为 stop 且发生在思考标记处,即可确认是停止词配置问题;若为 length,则需调整 num_predict。结合日志与社区中类似案例(如 GitHub Issues 中搜索“thinking no answer”),能快速定位兼容性缺陷或模板错误。
对本地部署的启示
这个案例折射出本地大模型部署的一个现实:硬件达标只是第一步,模型模板、生成参数、运行时版本的匹配同样决定体验。思考型模型在带来更强推理能力的同时,也引入了新的输出边界问题——思考段与回答段之间的衔接,是工具链需要正确处理的新环节。
对于遇到类似情况的用户,建议按“确认版本与模板 → 检查停止词与长度参数 → 对比非思考模式 → 查看运行日志”的顺序逐步排查,通常能较快锁定原因。
常见问题
Q:12GB 显存跑 9B 模型够用吗? A:从这位用户的配置看,显卡被 ROCm 正常识别,显存容量对 9B 模型是够的,问题更可能出在软件层面而非硬件。
Q:思考过程正常输出,说明模型在工作吗? A:是的,思考段能正常生成说明模型加载和推理链路是通的,问题集中在思考结束后的输出环节。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。
PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。