16G显存跑Qwen3 27B:192K上下文+视觉实测
用Adaptive KV Streaming在16G显卡上实现27B模型192K长上下文推理的完整测试记录
本文围绕消费级显卡(RTX 5080,16G显存)跑长上下文大模型的核心瓶颈展开:KV缓存会随上下文长度线性膨胀,远超显存容量。文章介绍了llama.cpp的Adaptive KV Streaming方案——将KV数据完整保存在系统内存,推理程序通过循环缓冲区主动预取、让传输与计算重叠,从而替代系统统一内存的被动分页。实测选用IQ3_S量化配合192K上下文和视觉能力,短对话约48 token/s,长上下文生成降至约10 token/s,速度上限受内存带宽约束。代码生成、CTF解题、图像识别等任务表现正常;审查版(会会)能力相近但角色扮演速度明显更慢,日常推荐原版。
KV缓存:长上下文推理的真正瓶颈
很多人以为在小显存显卡上跑大模型的难点在于模型权重本身,实际上真正卡住长对话的是 KV 缓存。它保存前文计算得到的注意力数据,上下文越长占用越大——这也是为什么模型能加载、却在长对话中越跑越慢甚至跑不动的核心原因。
Raymond Fwine 的文章正是针对这个问题。他在一张 16G 显存的显卡上尝试用统一内存(Unified Memory)让系统自动搬运数据,但长上下文下频繁换页会拖垮推理效率。这种做法看似省事,实则把调度权交给了操作系统,而系统并不了解推理程序下一步需要哪些数据,结果就是反复换页把推理时间涂满。
KV 缓存(Key-Value Cache)源自 Transformer 的自注意力机制。每次生成新 token 时,模型需要计算当前 token 与所有历史 token 之间的注意力权重。为了避免对每个历史 token 重复计算 Key 和 Value 矩阵,推理引擎会将它们缓存起来直接复用。问题在于,KV 缓存的大小与序列长度成正比,同时还与模型层数、注意力头数及头维度有关。以一个 27B 参数的模型为例,在 192K 上下文下,KV 缓存本身可能就需要数十 GB 的存储空间,远超消费级显卡的显存容量。这也解释了一个常见现象:模型权重加载完全正常,但一旦对话延伸到足够长,系统便开始出现卡顿乃至崩溃——罪魁祸首往往不是权重,而是膨胀的 KV 缓存。
Adaptive KV Streaming 的思路
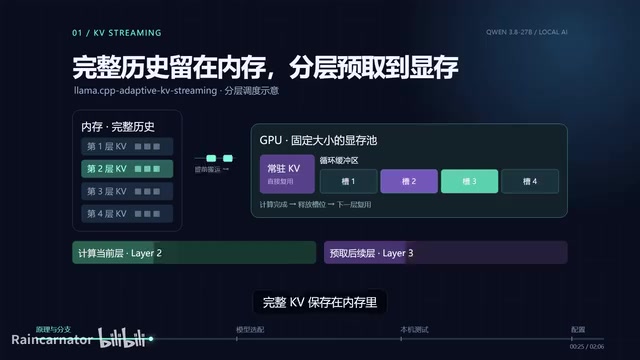
他做的改动叫 llama.cpp Adaptive KV Streaming,核心是把数据搬运从系统自动接管,改成由推理程序主动安排。
具体做法是:完整 KV 保存在内存里,显存只留一部分常驻数据,再用循环缓冲区提前把后续层需要的 KV 搬入显存。这样传输和计算可以重叠起来,避免了“算完一层才去搬下一层数据”的串行等待。当节分支还会在预填充(prefill)结束后,把空出来的计算空间交给 KV 使用。
这个方案的最大特点是保留完整历史,不靠阶段性截断上下文来省空间。代价也很明确:占用大量系统内存,且长上下文下的速度会受内存到显卡传输带宽的限制。换句话说,它用带宽换了完整性。
循环缓冲区(Ring Buffer / Circular Buffer)是一种固定大小的队列结构,写满后会从头覆盖最旧的数据。在 Adaptive KV Streaming 的实现中,它被用来维护一个"滑动窗口式"的显存暂存区:推理程序在计算第 N 层时,提前将第 N+1、N+2 层所需的 KV 数据从内存异步搬入显存中的循环槽位;旧槽位在数据被消费后随即释放以供后续层使用。这样一来,内存到显存的传输操作与 GPU 的矩阵计算操作在时间上形成重叠(overlap),GPU 不必空等数据到位,带宽利用率也更高。与操作系统的统一内存分页相比,这种方式的优势在于调度方拥有完整的计算图信息,能够做出精准的预取决策,而不是依赖通用的最近最少使用(LRU)页面置换策略。
量化版本怎么选:位数不是唯一标准
这次测试选的是 IQ3_S 量化(画面中标注为 GSQ RCO IQ3S)配 Q5_K 的混合方案,视觉投影器保持较大精度。
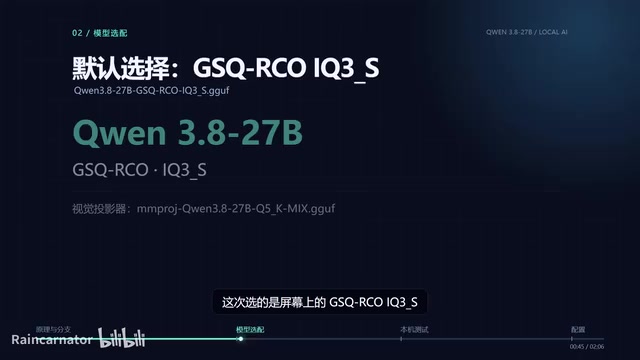
更小的 IQ3_XXS 能进一步省空间,但社区反馈中文表现有损失,这次没做同条件复测。Q4_K_M 精度更高、文件也更大,会挤占 KV 空间。一个容易被忽视的点是:不能只凭量化位数判断实际效果,代码实现同样影响表现。
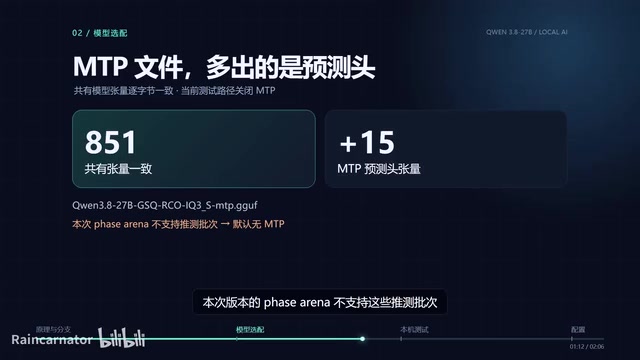
带 MTP(多 token 预测)的版本也做了核对——它共有的模型张量与普通版一致,多出的只是预测头,不能因此说它“更聪明”。而且本次的推理框架并不支持相关推测批次,开启 MTP 会直接报错,所以默认还是选普通版。
审查版(会会)也作为备用测了。需要说明的是,减少体积或做审查处理,不代表任务能力一定不变。
IQ(Importance Quantization)系列量化是 llama.cpp 引入的一种非均匀量化方案,与传统的 Q4_K、Q5_K 等 K-Quants 不同,它根据每个权重对模型输出的重要程度动态调整量化精度:对困惑度影响较大的权重保留更高精度,影响较小的则压缩更多。IQ3_S 和 IQ3_XXS 同属 3-bit 量化,但 IQ3_S 在量化策略上保留了更多关键权重的精度,因此在多语言任务(尤其是非英语场景)中通常表现更稳定,代价是文件略大。MTP(Multi-Token Prediction)是一种训练时引入的辅助目标,通过在模型末端附加若干预测头,让模型在训练阶段同时预测后续多个 token,以提升表征质量——它的存在主要服务于训练效率和表征优化,并不意味着推理时模型"更聪明"或具备额外能力,能否在推理阶段发挥作用还取决于推理框架的支持程度。
RTX 5080 实测:速度与占用
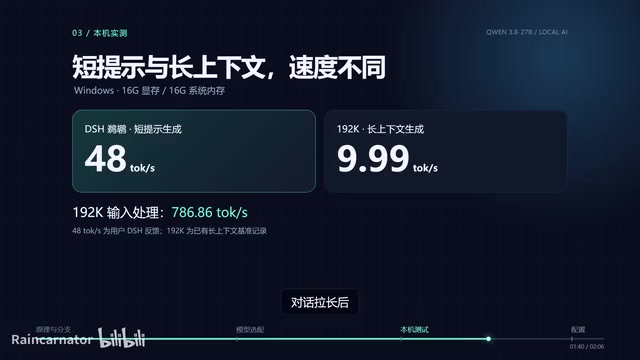
测试用 RTX 5080,最终保留的配置是 IQ3_S,192K 上下文并带视觉能力。
短对话场景下,在 DSH 里跑“提壶汽车”生成任务,速度约每秒 48 token,内存和显存占用比较平稳。
进入 192K 长上下文测试后,差异明显:输入处理约每秒 787 token,生成速度降到约每秒 10 token。对话拉长后,等待时间会显著增加——这正是前面说的带宽瓶颈在起作用。
任务能力横评
实际能力测试覆盖了几个维度:
- 代码生成:生成的程序通过了 6 项单元测试;
- CTF 教学题:给出了正确答案;
- 截图报错识别:能正确识别图中的报错信息。
审查版(会会)在这三项里同样答对,能力上没有明显退步。但在角色扮演任务中差异出现了:会会花了 86 秒,原版只需 35 秒,而且会会把内部的字典文字也一并输出了出来。基于这个结果,日常使用推荐原版,需要审查特性时再切换。
部署提醒
如果你的系统内存只有 16G,启动前务必关掉占内存的后台程序,否则完整 KV 保存在内存的方案很容易触发不足。这套方案本质上是在“显存不够、用内存补”的前提下做的工程优化,它让 16G 显卡跑 27B 级别模型+192K 上下文+视觉成为可能,但速度上限受硬件带宽约束,长上下文场景需要对等待时间有心理预期。
对于想在消费级硬件上榨出更长上下文的用户,Adaptive KV Streaming 的思路值得关注:它没有牺牲历史完整性,而是把调度权从操作系统手里拿回来,靠主动预取和计算重叠去缓解瓶颈。
相关推荐
Cursor 3.0 完整入门指南:从零上手 AI 编程 IDE
Cursor 3.0 完整入门教程:从下载安装、创建项目到并行子代理、云端开发、技能与自动化等高级功能。零基础也能上手这款 AI 编程 IDE,掌握模型选择、设计模式与 Git 版本控制的实用技巧。
Codex+Playwright封装测试Skill:UI自动化不再手敲命令
把 Playwright 封装成 Codex Skill,让 AI Agent 通过自然语言完成 UI 自动化测试。本文详解安装加载、Sauce Demo 实战、PO 分层模板,以及 MCP 与 CLI+Skill 的选型对照。
用Obsidian+AI智能体复刻2999元「得到大脑」全功能
用免费的Obsidian笔记软件搭配AI智能体,如何复刻年费2999元的得到大脑专家版?本文拆解发芽、点评、拷问、风格打磨、审稿、排版等核心功能的skills实现逻辑,助你搭建数据本地化、自由扩展的个人AI知识管理系统。