177B大模型跑在廉价显卡上?Qwen3 Flash Next本地部署实测
用50GB内存跑85GB模型:Ngram表卸载SSD让177B大模型在消费级硬件上达到22 tokens/s
一位B站UP主用两块廉价显卡(24GB显存)加32GB内存的消费级配置,成功以22 tokens/s的速度本地运行了177B参数的Qwen3 Flash Next模型。关键在于理解该模型的架构:177B总参数由125B核心神经网络权重与51B Ngram查找表组成,后者对内存带宽要求远低于前者,可直接从SSD流式读取而不显著降速。实际部署中,核心权重(IQ4_XS量化后约45.8GB)分布在显存与内存,而Ngram表(约39.1GB)被强制卸载到SSD,配合4-bit KV缓存和llama.cpp的惰性加载模式实现。这次实测的核心结论是:评估本地部署门槛时,应看「核心权重大小」而非「总参数量」,内置Ngram表的混合架构有望成为开源大模型在消费级硬件上普及的新方向。
用50GB内存跑85GB模型:一次反常识的实测
把一个体积接近本机总内存两倍的大模型跑起来,听上去像是天方夜谭。B站UP主用两块廉价显卡(合计24GB显存)加32GB系统内存,总可用内存约50GB的配置,成功在本地运行了一个占用约85GB的177B参数模型,并且拿到了22 tokens/s的可用速度,输出质量依然可观。
这套配置的核心思路,是重新理解「参数量」这件事。过去我们习惯用总参数量来估算硬件门槛,但新架构下这个直觉可能失效了。
177B参数≠177B都要塞进内存
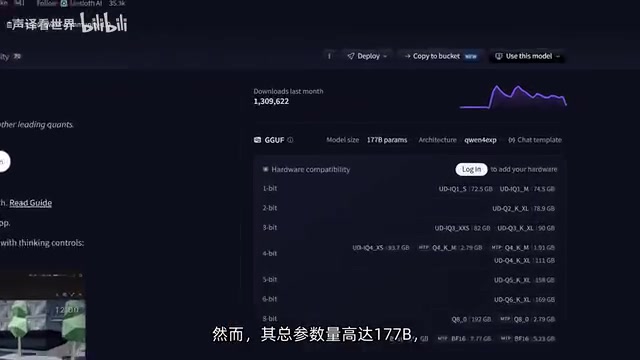
这次测试的主角是 Qwen3 Flash Next(视频中读作Qwen 3.8 Flash Next),一款发布不久便被视为新一代开源权重旗舰的模型。据UP主介绍,它的智能指数已经能与前沿闭源模型掰手腕,但177B的总参数量意味着即便是最激进的量化,也要占用约72.5GB,对没有高端硬件的人来说门槛极高。
关键转折在于它的架构。所谓177B总参数量,实际上是 125B核心模型权重 + 51B Ngram查找表 的组合。这两部分对硬件的需求完全不同:核心模型层需要尽可能快的内存带宽,而Ngram本质上只是一张查找表,理论上可以直接从SSD流式读取,速度损失并不严重。
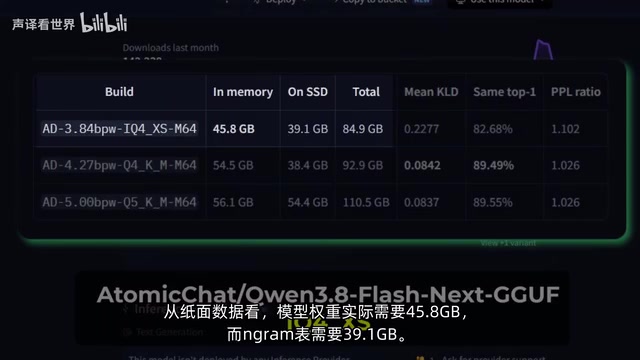
这个拆分很重要。用UP主使用的 IQ4_XS 量化版本来看,模型权重实际只需 45.8GB,而Ngram表需要 39.1GB。也就是说,真正需要塞进显存和内存的「快速部分」不到46GB,剩下近40GB可以扔给SSD。
Ngram查找表在这里指的是一种基于n-gram语言模型的辅助结构。传统n-gram模型通过统计语料库中连续n个词(或token)的共现频率来预测下一个词,本质上是一张巨大的条件概率索引表。在Qwen3这类混合架构中,Ngram表被用来辅助神经网络的预测,尤其在处理高频短语、固定搭配或重复性文本时能显著提升效率。由于Ngram表的访问模式相对规律——它更多是按key查value,而不像神经网络层那样需要密集的矩阵乘法——其对内存带宽的要求远低于核心Transformer层。这正是它可以被「降级」到SSD读取而不严重拖慢推理速度的根本原因:SSD的顺序读取速度(通常2-7 GB/s)足以满足查表操作的吞吐需求,而神经网络层的矩阵运算则对延迟极为敏感,必须依赖显存或高速内存。
部署细节:把Ngram表强行赶到SSD
实际部署使用的是 llama.cpp 服务器,启动参数值得关注:
- 4-bit KV缓存,压缩上下文的显存占用
- 上下文长度设为100,000,为长文本留足空间
- 将32层卸载到系统内存(offload到CPU侧)
- 启用惰性模式(lazy)+ 加载模式 None,强制llama.cpp直接从SSD读取Ngram表,而不是让它进入交换分区或虚拟内存
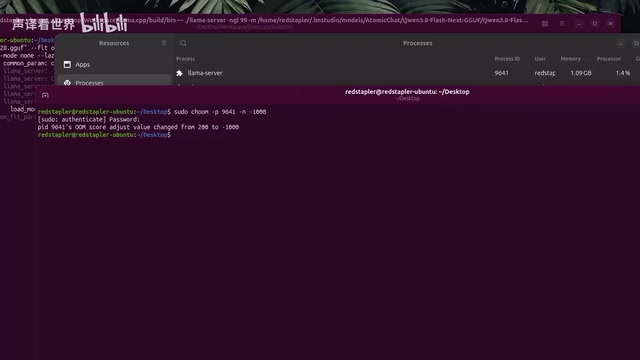
这里有个容易踩坑的地方:由于内存被压榨到极限,Linux的OOM机制会因RAM占用过高自动杀掉服务进程。UP主的解决办法是通过调整 oom_score_adj,将llama服务器的评分设为 -1000,避免被系统误杀。这类细节往往是本地部署能否跑通的关键。
IQ4_XS是llama.cpp生态中的一种非均匀4-bit量化格式(iQuant系列),与标准Q4_K_M等方案相比,它在每个量化块内使用了更精细的缩放因子分配策略,能在相近压缩率下保留更多原始权重的分布特征。「4-bit KV缓存」则是另一个独立的优化:KV缓存(Key-Value Cache)存储的是注意力机制中每一层每一个历史token的键值向量,上下文越长占用越大——100K上下文下这部分很容易超过10GB。将KV缓存本身也量化为4-bit,可以将其显存占用压缩到原来的1/4左右,是在有限显存下支撑超长上下文的必要手段。OOM(Out of Memory)是Linux内核在系统内存耗尽时触发的保护机制,会自动选择一个进程强制终止,oom_score_adj值越低越不容易被杀死,-1000是实际可设置的最低值,相当于给进程加了「免死金牌」。
实测速度:SSD并没有拖后腿
结果是这次测试最有说服力的部分。尽管超过一半的模型权重被卸载到内存、Ngram表被卸载到SSD,模型仍以 22 tokens/s 运行。即使上下文长度拉到76,000 tokens,平均速度依然维持在 14 tokens/s 这一完全可用的区间。
平台差异也被记录下来:Windows上运行会比Linux慢约20%,短上下文约16 tokens/s,长上下文约10 tokens/s。对追求本地推理性能的用户来说,操作系统选择依然值得纳入考量。
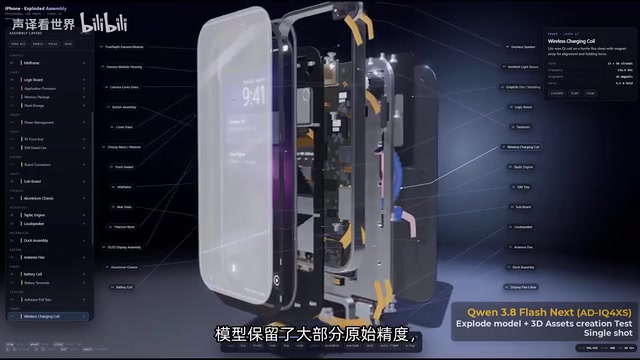
由于采用的是4-bit iQuant量化,模型保留了大部分原始精度,输出质量并未明显崩坏。能在如此「寒酸」的硬件上,以10万上下文、4-bit量化运行一个具备前沿智能水平的模型,本身就说明了架构创新带来的实际价值。
对开源AI的启示:别再被总参数量吓退
这次实测最核心的结论只有一句话:把Ngram表卸载到SSD,并没有像预期那样拖慢推理速度。
这背后是一个值得普及的判断逻辑——当你看到一个带有Ngram查找表(或类似稀疏/查表结构)的模型时,不要被总参数量直接劝退,而应该先看真正需要高速内存的核心模型有多大。对本地部署而言,「核心权重大小」远比「总参数量」更能反映硬件门槛。
UP主还提出一个更长远的观点:内置Ngram表的架构,可能会成为未来开源AI的新标准之一。它让大参数模型在消费级硬件上运行成为可能,把原本只能在昂贵服务器上跑的能力,下放到了普通玩家的桌面。
对于想在本地折腾大模型的用户,这套方案提供了一个可复制的路径:合理的量化选型(IQ4_XS)、精细的层卸载策略、以及把查表部分交给SSD。当然,本文数据来自单一UP主的实测环境,实际速度会随硬件、SSD读写性能和具体提示词而波动,仅供参考。
相关推荐
DeepSeek Harness渗透测试模式实测:AI辅助漏洞挖掘的能力与边界
本文解析基于DeepSeek Harness渗透测试模式与专用SKILLS技能包的AI辅助漏洞挖掘工作流,涵盖信息收集、后门RCE、数据库凭证泄露等实测结果,并探讨其成本控制与安全双刃剑效应。
Yue2 音乐模型 LoRA 实测:400 步复刻名人音色
一个基于 Yue2 音乐模型、用 AI-Toolkit 仅 400 步训练出的名人音色 LoRA 在 Reddit 走红。本文解析其技术意义、效果局限与背后的音色克隆版权伦理问题。
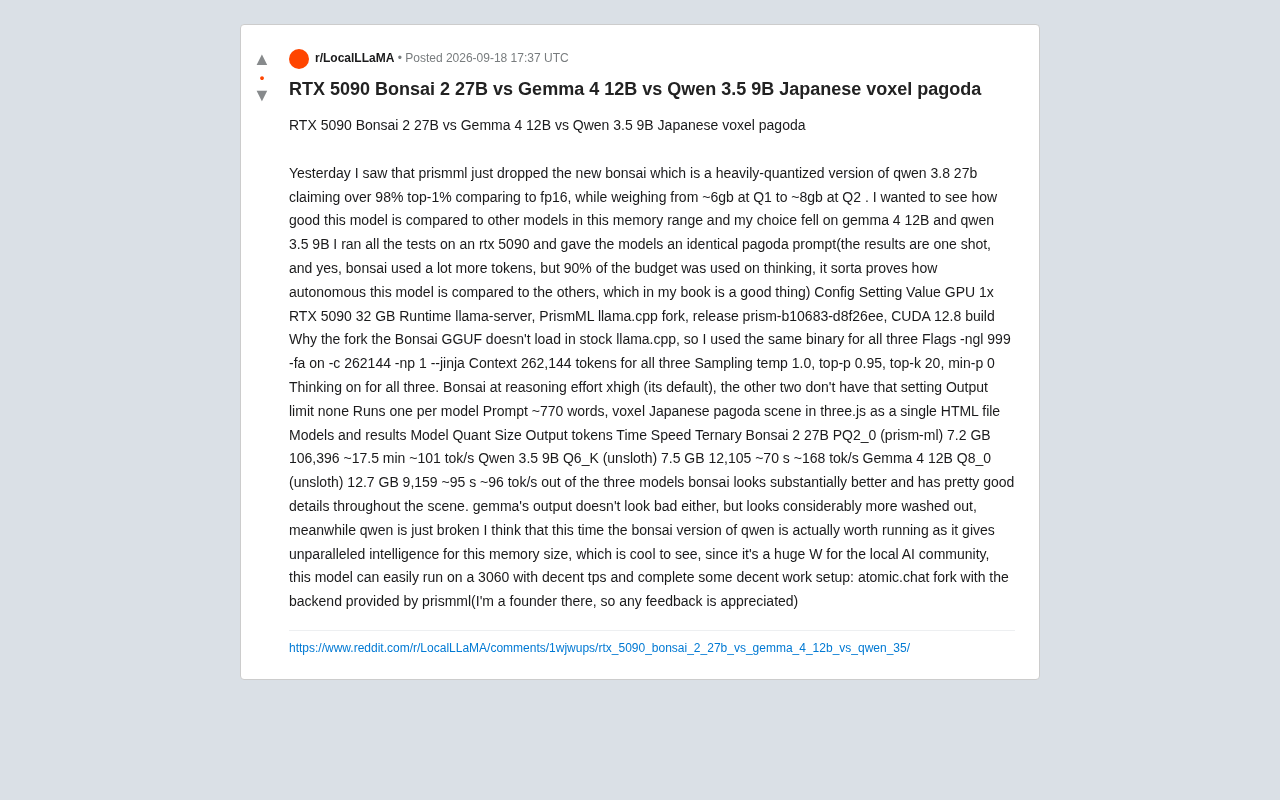
低显存本地大模型对决:Bonsai 2量化版为何胜出
Reddit 用户在 RTX 5090 上横评 Bonsai 2 27B、Gemma 4 12B 与 Qwen 3.5 9B。基于三元量化的 Bonsai 用 7.2GB 显存实现更优的日式体素宝塔渲染效果,展现低显存本地大模型的量化新趋势。