Yue2 音乐模型 LoRA 实测:400 步复刻名人音色
社区用Yue2+AI-Toolkit仅400步训练出名人音色LoRA,标志着低成本音色克隆进入音乐生成领域。
Reddit上流传的一个社区实验展示了当前音乐生成技术的新动向:有人将图像领域成熟的LoRA微调工具AI-Toolkit迁移到开源音乐生成模型Yue2上,仅用400步训练便得到了一个可辨识地模仿Samuel L. Jackson声线的音色适配器。这一案例的核心意义不在于成品质量,而在于它揭示了一个趋势:图像生成社区走过的「强力底座+LoRA生态」路径,正在音乐领域快速复现。低成本音色克隆的门槛已经触手可及,但与此同时,复刻真实公众人物声音所涉及的声音权、版权与滥用风险,也随着技术普及而同步放大,亟需社区自律与行业规范跟进。
用 400 步训练出的音色 LoRA
近期一个在 Reddit 上流传的项目引发了关注:有人基于 Yue2 音乐生成模型,训练出了一个模仿知名演员 Samuel L. Jackson 声线的 LoRA,而整个训练过程据称只用了 400 步(steps),工具则是社区常用的 AI-Toolkit。原帖作者说明,LoRA 与歌曲本身由社区成员 gueykhalamari 制作,自己主要贡献了一个交互式音乐播放器界面。
这类项目的价值不在于成品本身有多完美,而在于它把「低成本音色克隆」的门槛又往下压了一截。400 步在 LoRA 训练的语境里属于相当轻量的规模——放在图像领域,很多风格 LoRA 也需要上千步才能收敛。能在如此短的训练周期内让模型学到一个可辨识的声线特征,反映出 Yue2 的底座对音色/风格信息的捕捉效率不低。
Yue2 与 AI-Toolkit 的组合意味着什么
Yue2 是面向音乐生成的开源方向模型,而 AI-Toolkit 则是社区中广泛使用的 LoRA 训练脚手架,原本更多见于图像与视频扩散模型的微调场景。两者结合到音乐生成上,说明 LoRA 这种「轻量适配器」范式正在从视觉领域向音频/音乐领域快速迁移。
对于普通创作者来说,这套组合的吸引力很直接:
- 不需要从零训练一个庞大的音乐模型
- 只用少量目标素材 + 几百步训练,就能得到一个针对特定音色的适配器
- 训练成本(时间、算力)被压缩到个人消费级硬件也能承受的范围
换句话说,音乐生成正在复制图像生成走过的路径——先有强力开源底座,再由社区用 LoRA 玩出无数细分风格与音色。
LoRA(Low-Rank Adaptation)是一种参数高效微调技术,核心思想是在预训练模型的权重矩阵旁插入一对低秩矩阵,训练时只更新这两个小矩阵而冻结原始权重,从而用极少的可训练参数实现对模型行为的定向调整。相比全量微调,LoRA 所需的显存和时间成本可以压缩一到两个数量级。这项技术最初在语言模型微调领域(论文发表于 2021 年)证明有效,随后被 Stable Diffusion 社区大规模采用,成为图像风格与人物特征适配的主流手段。AI-Toolkit 正是社区在图像/视频扩散模型训练实践中沉淀出的脚手架工具,将 LoRA 训练流程封装为相对易用的界面与配置文件,使没有深度学习背景的创作者也能完成微调。此次将其迁移到 Yue2 音乐模型,意味着这套已在视觉领域高度成熟的工具链,正被直接复用到音频生成场景,创作者无需重新学习新的训练框架。
效果与局限:一次轻量实验
从原帖信息看,这更像是一次社区玩票性质的实验,而非严谨的产品级成果。作者本人也强调自己只是做了播放器,真正的模型与歌曲出自他人之手。因此在评估时需要保持克制:
- 积极面:验证了「短步数 + 开源工具」能产出可辨识音色的可行性,降低了尝试门槛。
- 不确定面:400 步能达到多高的相似度、在不同曲风下是否稳定、是否存在明显的伪影或音质损失,原帖并未给出量化对比。
- 可复现性:由于依赖具体的训练素材与参数,其他人复现时结果可能差异较大。
这类「短平快」的成果往往展示的是上限的存在性,而非稳定的平均表现,读者不宜据此推断所有音色都能被 400 步轻松复刻。
绕不开的伦理与版权问题
用 AI 复刻真实人物(尤其是公众人物)的声音,天然带有争议。名人音色属于其人格权益的一部分,未经授权将其用于音乐生成、二次创作乃至商业用途,可能触及肖像权、声音权乃至版权的红线。
技术门槛的持续下降,让「谁都能训练一个名人音色 LoRA」从设想变成现实,这也意味着相关的滥用风险同步上升。社区在分享这类项目时,值得同步明确使用边界:仅用于技术探索与非商业演示,避免将其包装成可对外发布的成品音乐或误导性内容。
在法律层面,声音权(voice rights)在不同司法管辖区的保护力度差异显著。美国已有多个州通过「人格权法」(Right of Publicity)保护名人的声音、肖像等可识别特征免遭未授权的商业利用;2024 年通过的联邦层面《NO FAKES Act》草案也明确将 AI 合成声音纳入规制范围。中国《民法典》同样规定声音参照适用肖像权的保护规则。即便是非商业的技术演示,若生成内容被传播并造成混淆或名誉损害,仍可能面临法律风险。值得注意的是,训练数据本身的合规性同样是问题所在——用于提取音色特征的录音素材,其录制、分发和用于模型训练是否均经过授权,往往是此类项目最容易被忽视的法律盲区。
小结
这条来自 Reddit 的分享,本质是音乐生成社区的一个技术切片:Yue2 提供底座,AI-Toolkit 提供训练框架,社区成员用极少的训练步数完成了一次音色适配实验。它的意义更多在于「趋势信号」——音乐领域的 LoRA 生态正在成型,低成本音色克隆已经触手可及。至于成品质量、可复现性与合规边界,则仍需更多严谨测试与行业规范来填补。
相关推荐
ChatGPT发明者推新型AI模型Jev,开发者为何兴奋
由ChatGPT核心研发者推出的新型AI模型Jev正引发开发者热议,主打更便宜、更快速的软件智能路径。本文解析其定位、开发者兴奋的原因及需审慎看待的信息盲点。
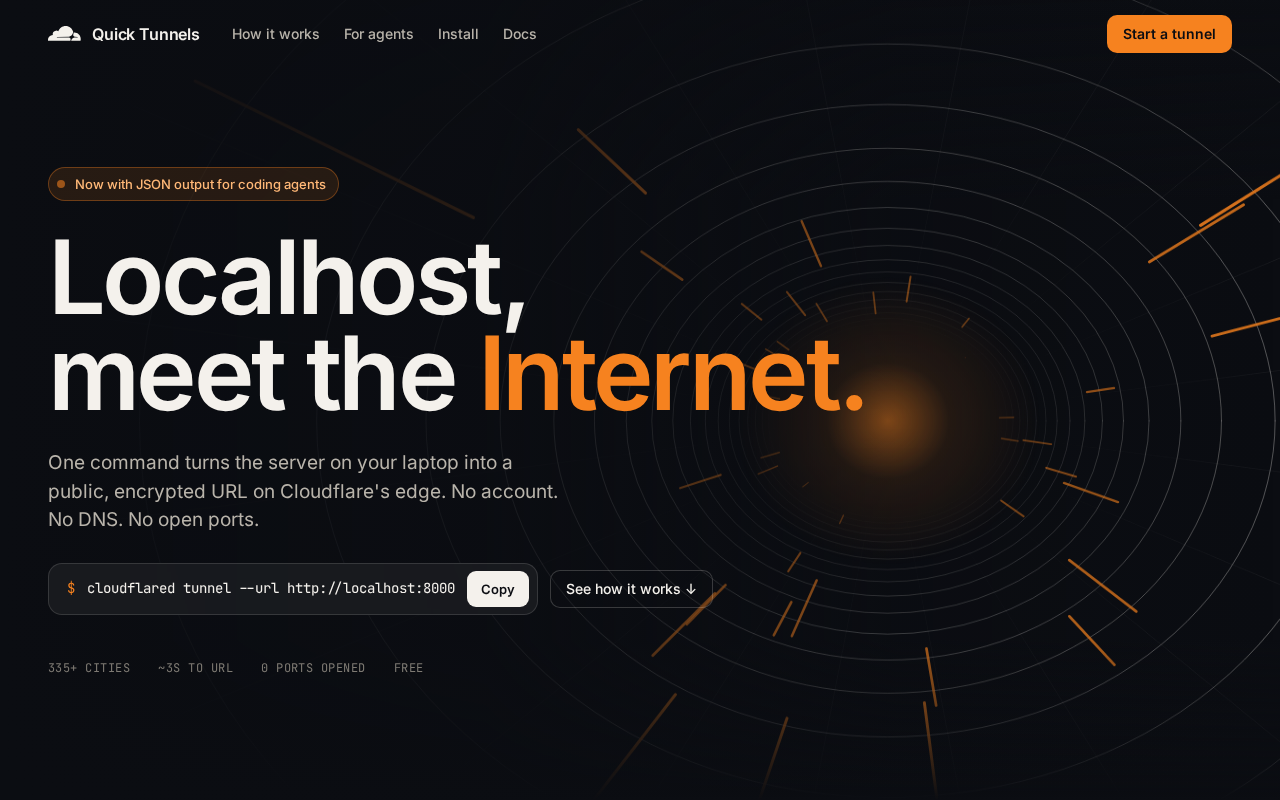
Cloudflare Quick Tunnels:一行命令把本地服务暴露到公网
Cloudflare Quick Tunnels 让开发者用一行 cloudflared 命令即可把本地服务暴露到公网,无需账号和域名,自带 HTTPS。本文解析其用法、应用场景、优势局限及与 ngrok 等工具的对比。
SCIM日志功能上线:直击身份供给调试痛点
SCIM目录新增Logs日志标签页,可查看IdP发送的每一次供给请求、完整payload及失败原因说明,大幅简化身份供给(provisioning)调试流程,提升企业身份集成的可观测性。