#LoRA
共 22 篇相关文章
高质量LoRA训练全流程指南
系统梳理高质量LoRA训练的端到端流程,涵盖数据集构建与清洗、基座模型与超参数选择、正则化图像争议、checkpoint评估与迭代策略,帮助开发者建立可复现的LoRA训练闭环。

LoRA微调溯源签名:黑盒检测扩散模型变体
论文提出一种黑盒溯源协议,利用图像内在维度作为签名,在开放世界场景下检测在线服务是否使用了扩散模型的LoRA变体,区分基础模型、适应版本与其他模型家族。

不改权重也能微调大模型:PEFT、适配器与前缀调优解析
解析 PEFT 参数高效微调三大路线:LoRA、适配器与前缀调优。说明不更新原始权重如何微调大模型、各方法的优劣与选型建议,以及落地时的调参与部署注意事项。

有限秩瓶颈:LoRA低秩适配的理论新解
无需线性化的LoRA理论新框架:冻结骨干诱导的有限秩瓶颈决定了低秩适配的秩上界,迹范数正则化与驻点秩亏从凸与非凸两侧共同解释低秩更新的有效性。

单卡3090微调Qwen:准确率提升为何不够?
单卡RTX 3090微调Qwen3.5的实测复盘:准确率从7/28升至13/28,NLL却从2.215恶化到3.916。揭示标签与问题不匹配、校准缺失、JevBench困难组暴露的泛化短板,以及训练恢复与数据隔离的工程实践。

8GB显存跑MiniMax H3角色替换LoRA:低配显卡的视频生成实测
一位Reddit用户在RTX 4070、8GB显存环境下,使用MiniMax H3模型配合角色替换LoRA完成视频生成实测。本文解析其硬件配置、渲染参数与角色替换LoRA的应用价值,探讨低配显卡玩转AI视频生成的可行性。

Krea 2 写实人像 LoRA 解析:AI 绘图微调的现状
Reddit 社区分享的 Krea 2 写实人像 LoRA 引发关注。本文解析 LoRA 微调技术、Krea 模型生态以及「1girl realism」现象背后的创作逻辑与使用方法。

AI视频生成实战:H3 T2V搭配LoRA打造奇幻战斗场景
一条Reddit分享揭示AI视频生成的组合式创作趋势:H3 T2V模型搭配combat LoRA与spectrum打造奇幻战斗场景。本文拆解T2V、LoRA微调技术及模块化工作流的价值。
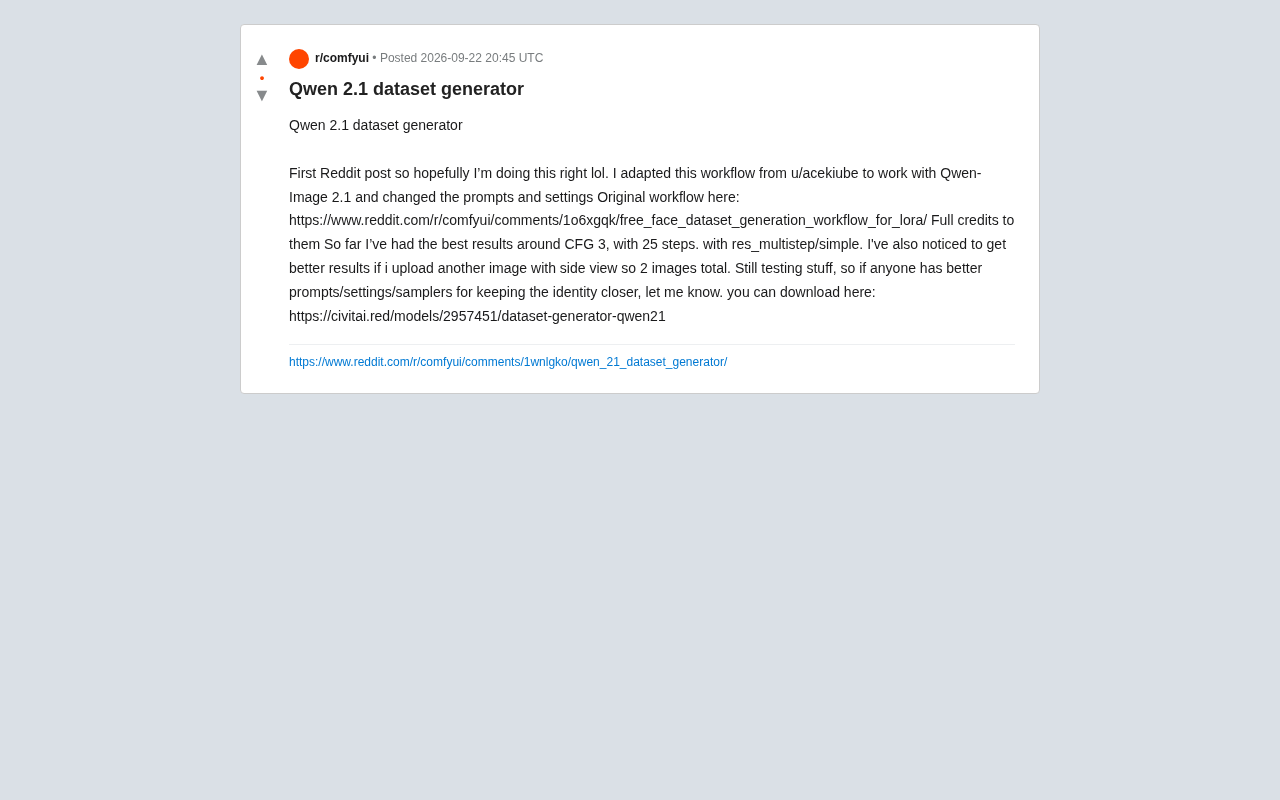
Qwen-Image 2.1 数据集生成器:LoRA训练人脸素材新工作流
一位Reddit用户分享了基于Qwen-Image 2.1的LoRA数据集生成工作流,改编自社区方案。文章解析其CFG 3、25步、res_multistep采样器等关键参数,以及双图输入提升人脸身份一致性的实用技巧。
VNCCS PoseStudio:Qwen Image 2.1 姿势控制LoRA发布
VNCCS PoseStudio 为 Qwen Image 2.1 推出首个姿势控制 LoRA,附带完整工作流,已在 Hugging Face 开源发布。本文解析其功能、获取方式与对AI图像创作的实际价值。
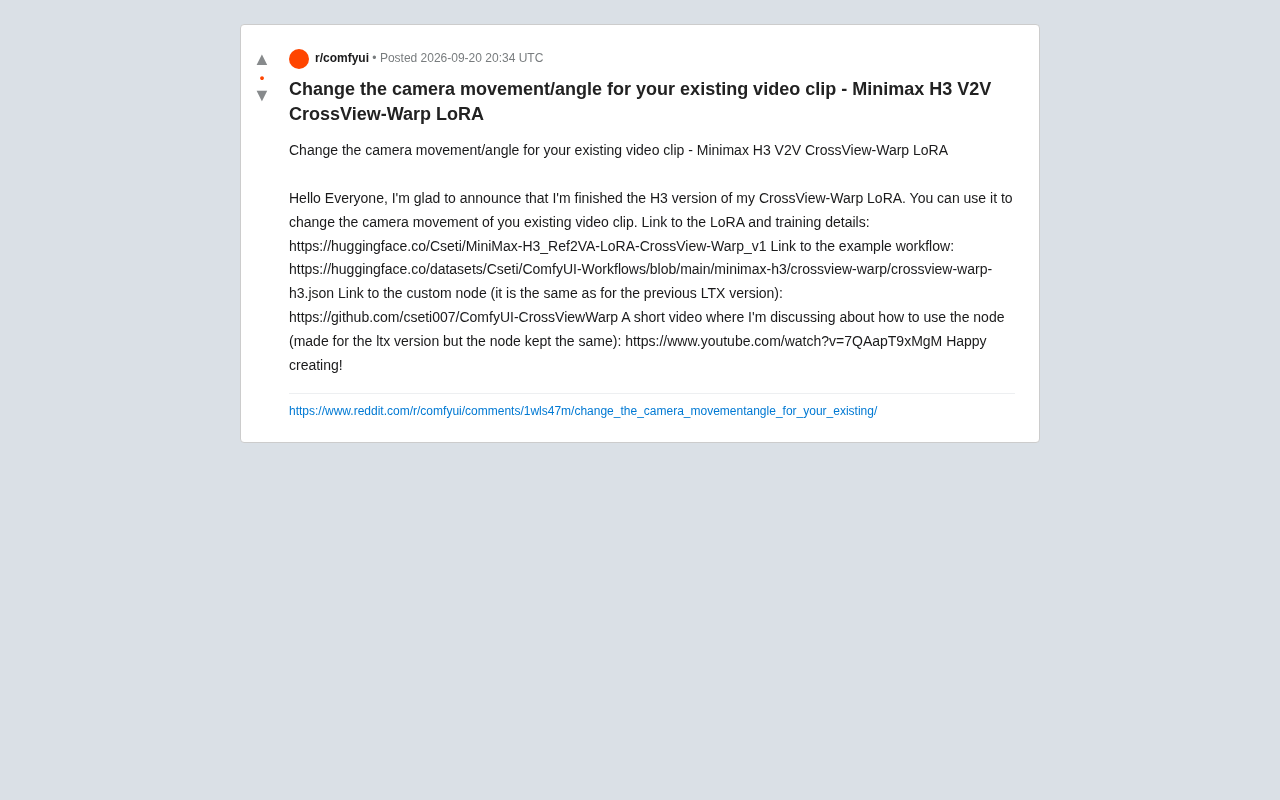
MiniMax H3 CrossView-Warp LoRA:一键改变已有视频的运镜与视角
开发者 Cseti 发布 MiniMax H3 CrossView-Warp LoRA,可对已有视频片段修改镜头运动与视角。本文介绍这款开源视频到视频工具的构成、使用方式与技术价值。

ComfyUI 新增 YuE2 LoRA 训练器:音乐生成模型的定制化探索
开发者 filliptm 与 MachineDelusions 合作推出 ComfyUI YuE2 LoRA 训练器,基于自研编码器与分词器脚本,让用户在节点环境中微调 YuE2 音乐生成模型。项目已在 GitHub 开源。

TaoMate H3 三步 LoRA 适配 ComfyUI:加速 MiniMax H3 生图
Reddit 用户将官方 TaoMate H3 3 Step LoRA 转换为 ComfyUI 兼容的 safetensors 格式,无需重新训练即可让 MiniMax H3 在 3 步采样下加速生图。附下载地址与部署方法。
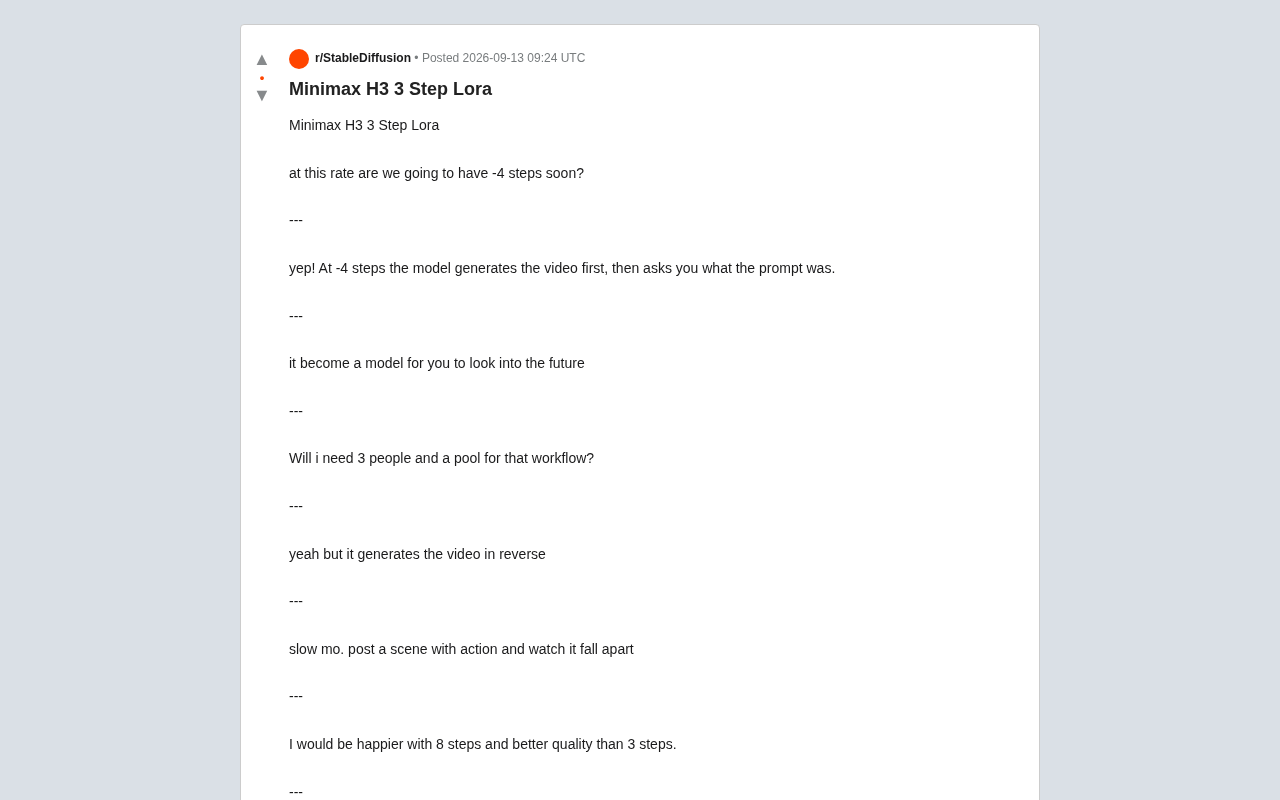
MiniMax H3 3步加速LoRA:极速生成与画质的博弈
MiniMax H3 3步加速LoRA在Reddit引发热议:它将视频生成推理压缩到3步,速度惊人但画质存疑。本文梳理社区实测反馈、参数经验与多LoRA混合工作流思路,分析极速与质量的博弈。

Krea2角色LoRA训练指南:如何精准还原脸型与体型
面对Krea2模型,如何训练能精准还原脸型和体型的角色LoRA?本文梳理数据集准备、打标策略、参数调优与避坑经验,并提供Hugging Face等资源检索方向。

AI绘图皮肤出现网格状纹理?成因与修复思路解析
AI绘图中角色四肢皮肤出现网格状纹理,脸部却正常?本文分析这一常见伪影的成因,涵盖VAE解码、LoRA过拟合、放大器等因素,并给出可操作的排查与修复步骤。
 教程攻略
4-bit QLoRA微调LLaMA 3实战:消费级GPU训练80亿参数大模型指南
详解如何使用QLoRA和Unsloth框架在消费级GPU上微调LLaMA 3 8B大模型。涵盖4-bit量化、LoRA低秩适配、Alpaca数据格式、训练流水线搭建到模型部署的完整流程,RTX 3090即可运行。
 教程攻略
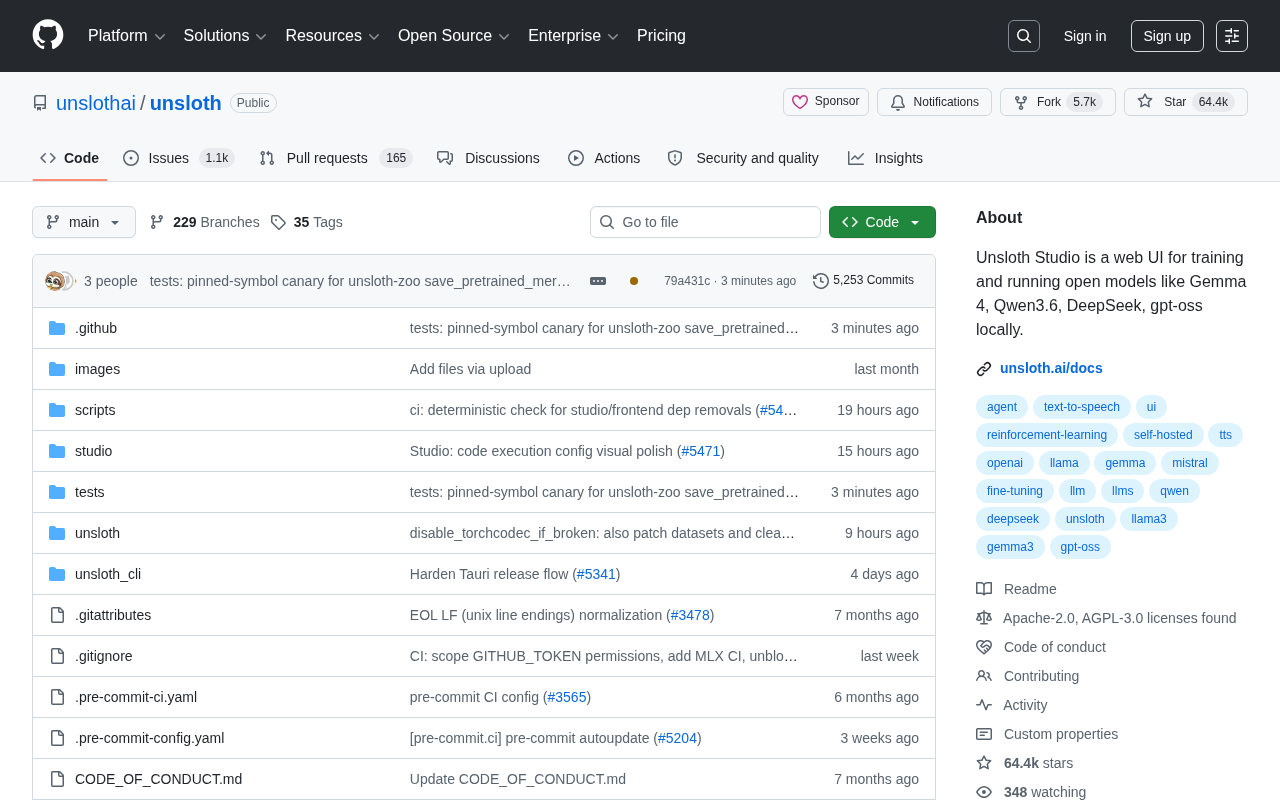
Unsloth教程:本地微调大模型省显存提速5倍
详解Unsloth开源工具如何通过LoRA优化和Web UI界面,让消费级显卡也能高效微调Gemma 4、Qwen3、DeepSeek等主流大模型,训练速度提升2-5倍,显存降低50%-70%。