200行Python代码从零搭建AI Agent:核心概念与实战路径

用200行Python代码拆解AI Agent的五大核心组件,帮助初学者建立智能体底层认知。
本文介绍了一套以约200行Python代码实现简易AI Agent的B站教程。教程采用"先讲术语、再看代码"的增量式教学方式,从第七节课起逐步拼装一个完整的智能体项目。文章系统梳理了Agent的五大核心组件:提示词(决定模型行为基调)、记忆功能(赋予上下文连续性)、工具调用(让模型从"说"变为"做")、RAG增强检索(引入外部知识缓解幻觉)以及技能模块(可复用能力封装)。教程适合有基本Python基础的学习者,能帮助其在上手LangChain等大型框架之前先建立底层直觉,但文章也明确提醒,"七天速成"等宣传话术需理性看待,200行代码更适合作为理解原理的最小样本,而非直接达到生产级水平。
用200行代码理解AI Agent的本质
很多人一提到AI Agent(智能体)就觉得门槛极高,需要庞大的框架和复杂的工程能力。但从这个B站教程的思路来看,一个可运行的简易AI Agent其实只需要约200行Python代码就能实现。整个项目基于纯Python语言,不依赖繁重的第三方封装,重点在于把Agent的每个核心组件拆开、讲清楚,再逐步拼装成完整系统。
这种做法的价值在于——它把"Agent到底是什么"这个抽象问题,变成了可以逐行阅读的代码。对于有基础Python能力的学习者来说,这条路径比直接上手LangChain、AutoGPT等大型框架更容易建立底层直觉。
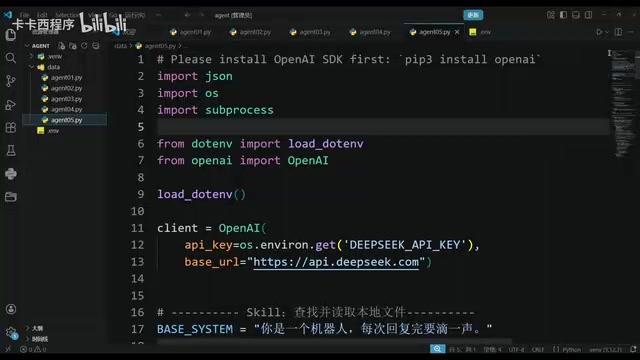
从概念到代码:教程的讲解方法
该教程采用了一种"先讲名词、再看代码"的教学结构。每节课先说明一个Agent相关的术语,然后立刻用代码演示这个概念在实际中起到什么作用。这种即讲即练的方式,避免了纯理论堆砌带来的枯燥感,也能让学习者直接看到抽象概念的落地形态。
从第七节课开始,教程会正式进入智能体的搭建与使用环节。整个过程强调"分步骤依次添加代码",即每引入一个新概念,就往已有代码里补充对应的实现,最终自然而然地形成一个完整的Agent项目。这种增量式构建对初学者非常友好,因为每一步的改动都是可理解、可追溯的。
AI Agent的五大核心组件
根据教程规划,一个基础Agent主要由以下几个关键部分构成,它们也代表了当前智能体开发的通用范式:
提示词(Prompt)
提示词是Agent与大模型沟通的接口,决定了模型如何理解任务、以什么角色和格式作出响应。设计良好的提示词往往是Agent行为质量的第一道分水岭。
记忆功能(Memory)
记忆让Agent具备上下文连续性,能够记住之前的对话或操作结果,而不是每次都从零开始。这是让智能体从"一问一答"进化为"持续协作"的关键。
记忆在Agent实现中通常分为两类:短期记忆指当前会话的对话历史,直接拼接在每次请求的上下文窗口中;长期记忆则将重要信息持久化存储(如写入数据库或向量库),下次会话时按需检索调入。由于大模型上下文窗口长度有限(例如几千到几十万token不等),如何在有限窗口内保留最相关的历史信息,是记忆模块设计的核心挑战。简易实现通常只保留最近N轮对话,生产级系统则需要更精细的摘要压缩或选择性遗忘策略。
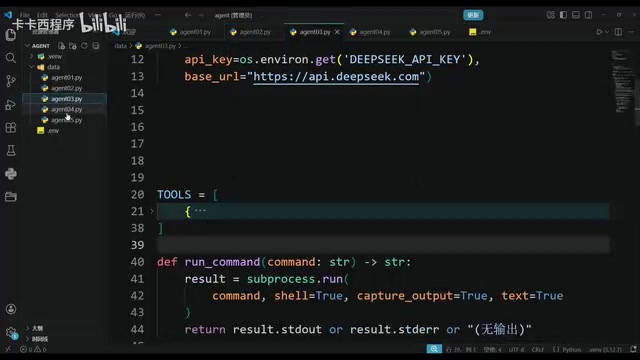
工具调用(Tool Calling)
工具调用赋予Agent行动能力——比如查询数据、调用API、执行计算。没有工具调用的模型只能"说",有了工具调用才能真正"做"。
工具调用在技术实现层面,通常依赖大模型输出结构化的"函数调用请求"(如OpenAI的Function Calling或Tool Use接口),Agent框架解析这段输出后,在本地或远程执行对应函数,再将结果回传给模型继续推理。这种"模型决策→外部执行→结果反馈"的循环,正是Agent区别于普通聊天机器人的根本所在。常见的工具包括:网络搜索、代码执行沙箱、数据库查询、文件读写、第三方API调用等。值得注意的是,工具的设计质量直接影响Agent的可靠性——描述不清的工具定义会导致模型误调用,缺乏错误处理的工具则可能让整个推理链路中断。
RAG增强检索
RAG(检索增强生成)通过外部知识库补充模型的知识盲区,让Agent能够基于最新或专有数据作答,有效缓解幻觉问题。
RAG(Retrieval-Augmented Generation,检索增强生成)的基本流程是:将外部文档切片后转换为向量嵌入(Embedding)并存入向量数据库,用户提问时先在数据库中检索语义最相近的片段,再将这些片段连同问题一起送入大模型生成答案。这套机制使模型无需重新训练就能"读到"新知识,是目前企业落地AI最常用的手段之一。常见的向量数据库包括Chroma、Faiss、Pinecone等。RAG的效果高度依赖切片策略、Embedding模型质量以及检索召回率,在200行的最简实现中通常会做大幅简化,主要用于演示概念流程。
技能(Skill)
技能是近期较为热门的概念,可以理解为将一组能力封装成可复用的模块,让Agent更灵活地组合和调度自身功能。
把这五个组件依次串联起来,就构成了一个具备感知、记忆、行动和知识检索能力的完整智能体骨架。
这条学习路径适合谁
教程明确指出,只要掌握Python最基本的基础,就能听懂全部内容。这意味着它的目标受众是有一定编程入门经验、希望快速理解Agent工作原理的开发者或学生,而非完全零编程背景的人群。
值得提醒的是,虽然标题宣称"七天从小白到大神""学完即就业",这类表述更多是宣传话术。真实情况是:200行代码的项目非常适合建立概念框架和动手信心,但要达到工程级的生产可用水平,仍需在错误处理、并发、安全、成本控制等方面投入大量额外学习。把这个教程当作理解Agent本质的"最小可运行样本",才是更合理的定位。
小结
这套教程的核心价值不在于"748集"的数量,而在于用极简代码拆解了AI Agent的五大要素:提示词、记忆、工具调用、RAG和技能。对于想搞清楚智能体到底如何运作的学习者而言,从一个200行的可运行项目切入,远比一开始就陷入复杂框架更有效。理解了这套骨架,再去使用主流Agent框架时也会更加得心应手。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。