#AI Agent
共 351 篇相关文章
·4 分钟
Sierra 多模态智能体:语音、文字、视觉自由切换的客服 AI
Sierra 推出 Multimodal Agents 多模态智能体,能在语音、文字、视觉三种交互模式间自动切换,专为客户成功场景设计。本文解析其产品理念、应用价值与 AI 智能体多模态融合趋势。
阅读全文 →
Portable Computer登陆Windows:RTX GPU本地跑A…
·2 分钟
Portable Computer登陆Windows:RTX GPU本地跑AI Agent
Portable Computer现已支持搭载NVIDIA RTX GPU的Windows PC,可在本地运行AI harness、agents和模型,无需上传云端即可处理本地文件与连接应用,并在需要时调用前沿云端模型。
阅读全文 →
·4 分钟
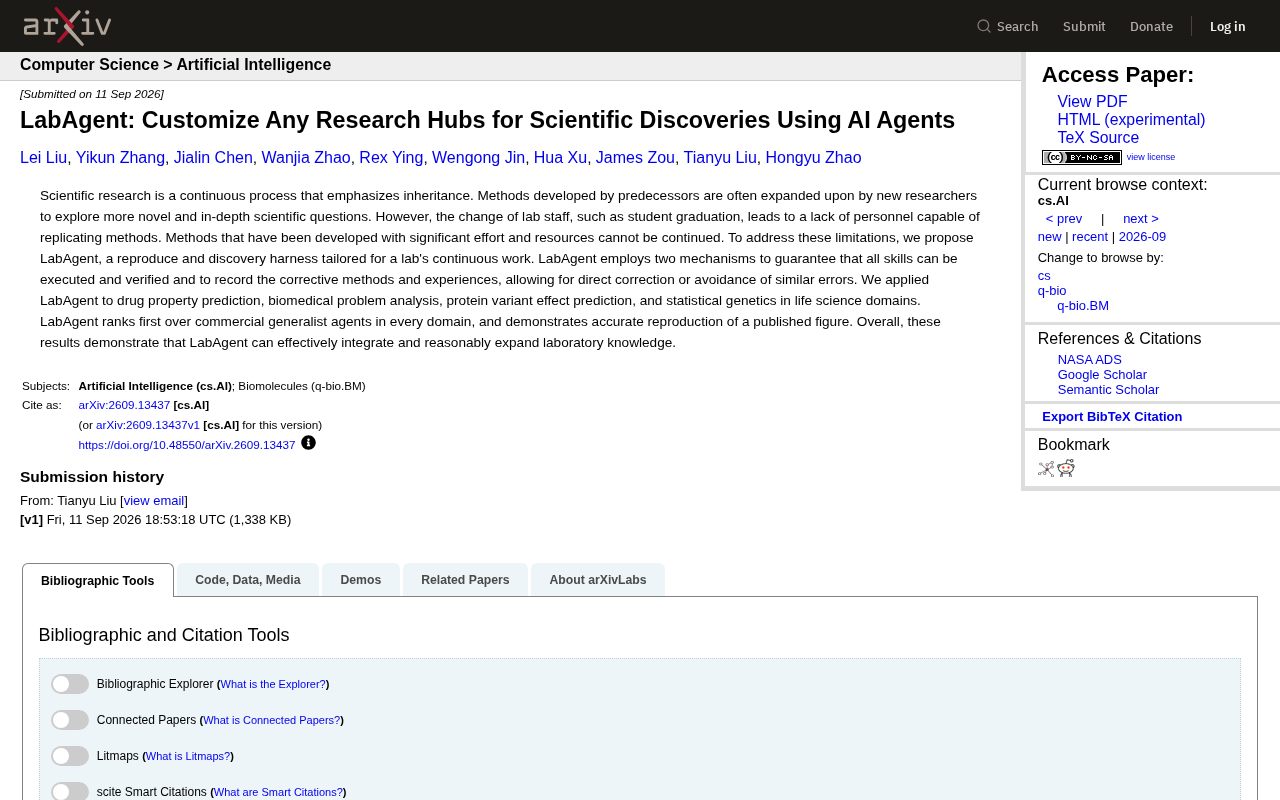
LabAgent:为科研实验室打造可复现的AI智能体系统
arXiv新论文提出LabAgent,一套面向科研实验室的AI智能体系统,通过可执行验证和经验记录两大机制解决科研方法传承难题,在药物预测、蛋白质变异等生命科学领域超越通用智能体。
阅读全文 →

·3 分钟
自适应物理AI探索:LLM智能体能否胜任长周期物理任务?
最新arXiv论文探讨LLM智能体能否管理长周期物理任务。研究通过整合规划、工具调用、观察与验证的多智能体框架,在农业场景中对比零样本LLM与强化学习智能体,发现LLM在环境变化时具备更强的自适应能力。
阅读全文 →
·3 分钟
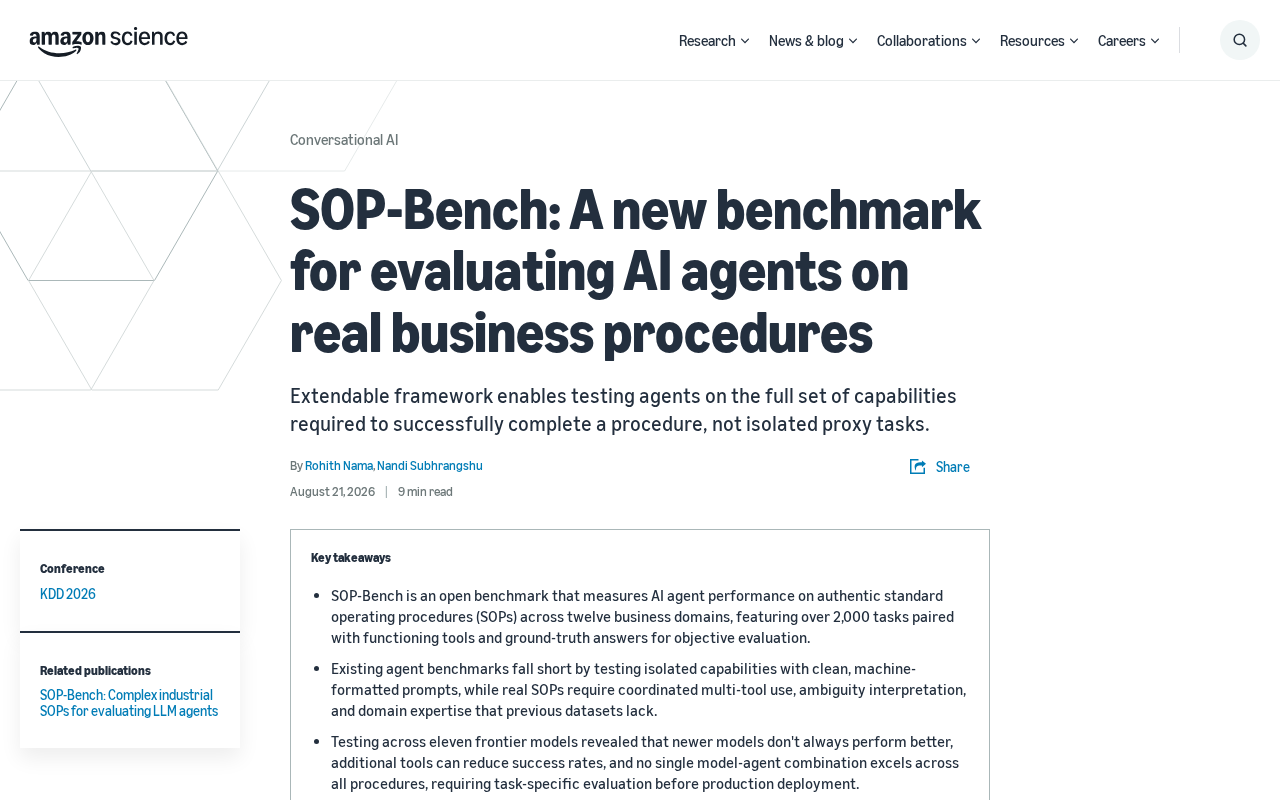
SOP-Bench:评估AI智能体处理真实业务流程的新基准
SOP-Bench 是一个用于评估 AI 智能体处理真实业务流程能力的新基准,采用可扩展框架,测试完成标准作业程序所需的全套能力,而非孤立的代理任务,为企业落地 AI Agent 提供更务实的参考。
阅读全文 →
·5 分钟
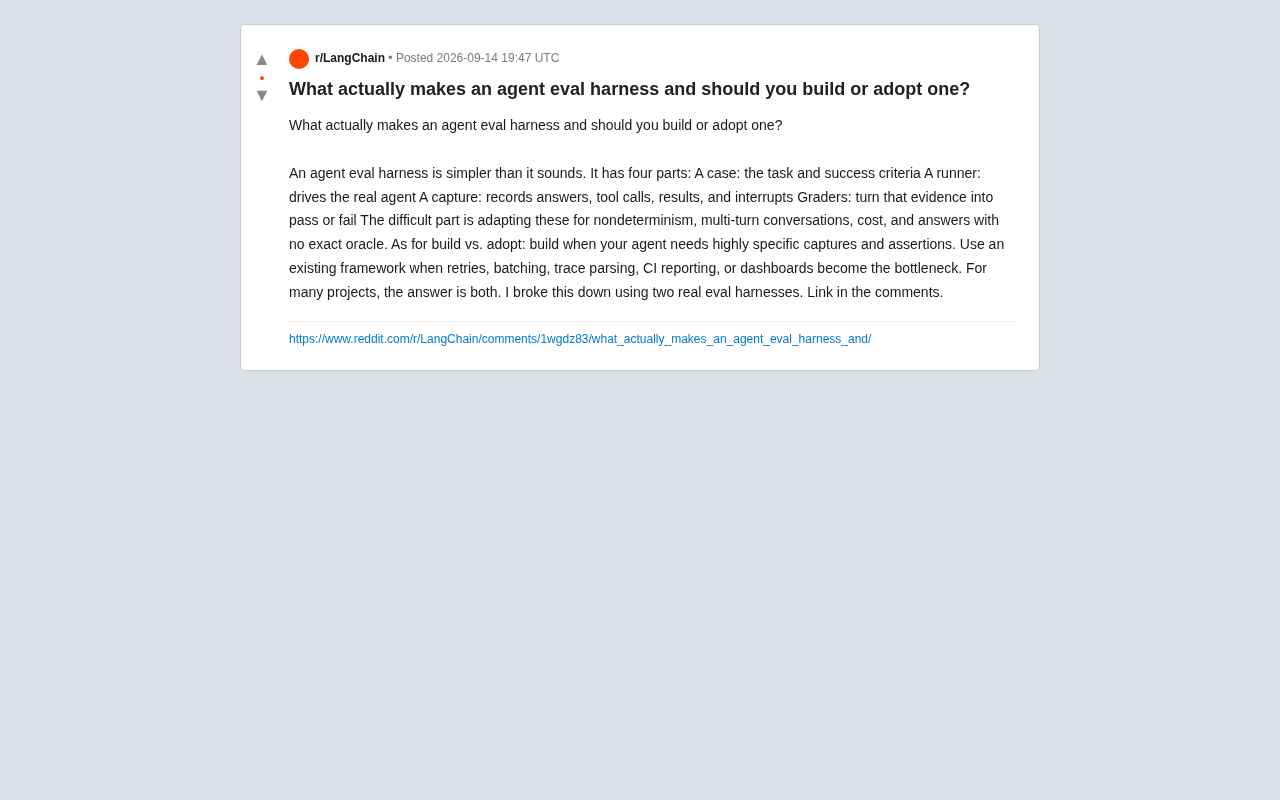
Agent评估框架深度解析:自建还是采用现成工具?
深入解析Agent评估框架(eval harness)的四大核心组件——测试用例、执行器、捕获层与评分器,并探讨自建与采用现成框架的决策标准,助力AI工程团队构建可靠的智能体评估体系。
阅读全文 →

·3 分钟
ProGantt:让AI Agent通过MCP读写甘特图
ProGantt是一个让AI Agent通过MCP协议读写甘特图的项目管理工具。本文解析其核心能力、MCP协议的价值以及AI原生工具的发展趋势。
阅读全文 →

·2 分钟
Otis:开箱即用的本地AI Agent工具解析
Otis是一款主打本地模型开箱即用的极简开源AI Agent工具。本文解析其设计理念、本地运行大模型的价值与挑战,以及极简路线对开发者的意义。
阅读全文 →
·4 分钟
COGEXT:给AI Agent装上"测谎仪"的验证层工具
COGEXT 是一款面向 LangChain 等 AI Agent 的验证层工具,通过提取承诺并对接 Gmail、GitHub 等外部系统独立核验,防止智能体谎报任务完成。本文解析其验证引擎、急停开关、审计凭证等核心能力及其对 AI 可信度的意义。
阅读全文 →
·3 分钟
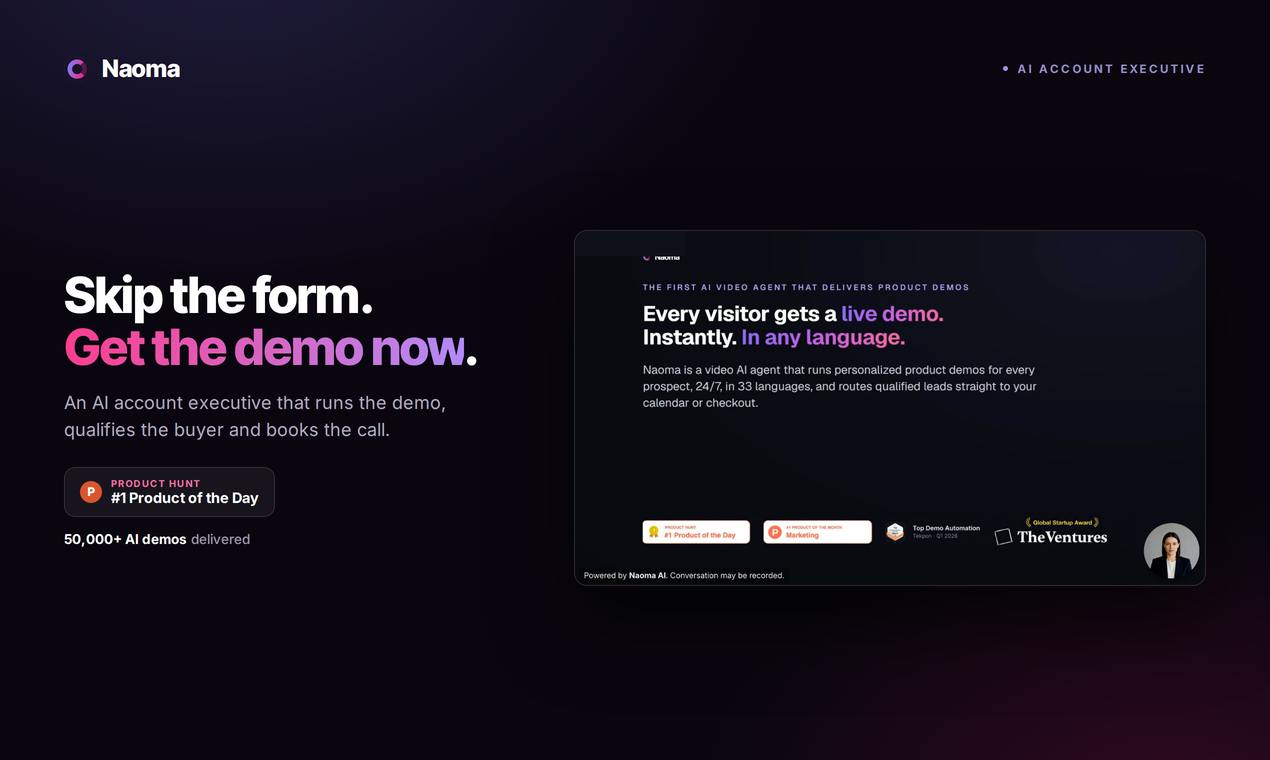
Naoma AI Demo Agent V2:用AI销售把网站流量变成成交会议
Naoma AI Demo Agent V2 用AI销售代表替代传统预约表单,实时为访客演示产品、筛选线索并预约会议,已运行5万+演示并开放自助试用。解析这款登顶Product Hunt的销售自动化工具。
阅读全文 →

·3 分钟
Nimble推出自学习Web搜索智能体:让AI自动完成网络调研
Nimble在Product Hunt发布Web Search Agents自学习网络搜索智能体,可自动完成公司信息补全、法规研究等领域的深度网络调研与检索,为AI应用提供更相关的网络上下文。
阅读全文 →

·3 分钟
Aside:能替你干活的AI浏览器,实测超越Claude Cowork
Aside 是一款主打"替你干活"的AI浏览器,可登录账户、操作网站、完成支付与本地文件任务。官方称在智能体浏览基准上超越 Claude Cowork,全本地加密运行,并支持接入 Claude、ChatGPT 订阅。
阅读全文 →
·3 分钟
Resumate:为LangGraph智能体打造的修复与续跑层解析
开发者为LangGraph智能体打造修复与续跑层Resumate,通过检查点记忆失败、复用有效方案并防止Stripe扣款等副作用重复触发。本文解析其核心机制、坦诚局限与工程价值。
阅读全文 →

·5 分钟
GAUGE研究:何时不能信任LLM-as-a-Judge的智能体评测
GAUGE 研究揭示 LLM-as-a-Judge 在任务型智能体评测中的两大盲区:满意度与任务成功几乎不相关(57.5%满意对话实际失败),且面对势均力敌的强模型时分歧率飙升至31%,并提出「先校准再信任」的补救方案。
阅读全文 →
·2 分钟
BI Visual Advisor:用AI审查你的数据看板设计
BI Visual Advisor 是一款用 AI 审查数据看板的工具,支持 Power BI、Tableau、Looker Studio 和 Excel,上传截图即可识别图表问题并给出优化建议。本文解析其工作原理、价值与局限。
阅读全文 →

·3 分钟
AI助手的失败标志:当它制造了第二份运维工作
一位Reddit用户提出评判AI助手成败的新标准:当它为你制造第二份运维工作时就已失败。本文解析如何让AI工作流端到端可靠,识别连接器失效、重复操作等隐藏维护成本,用净收益而非工具数量衡量Agent价值。
阅读全文 →
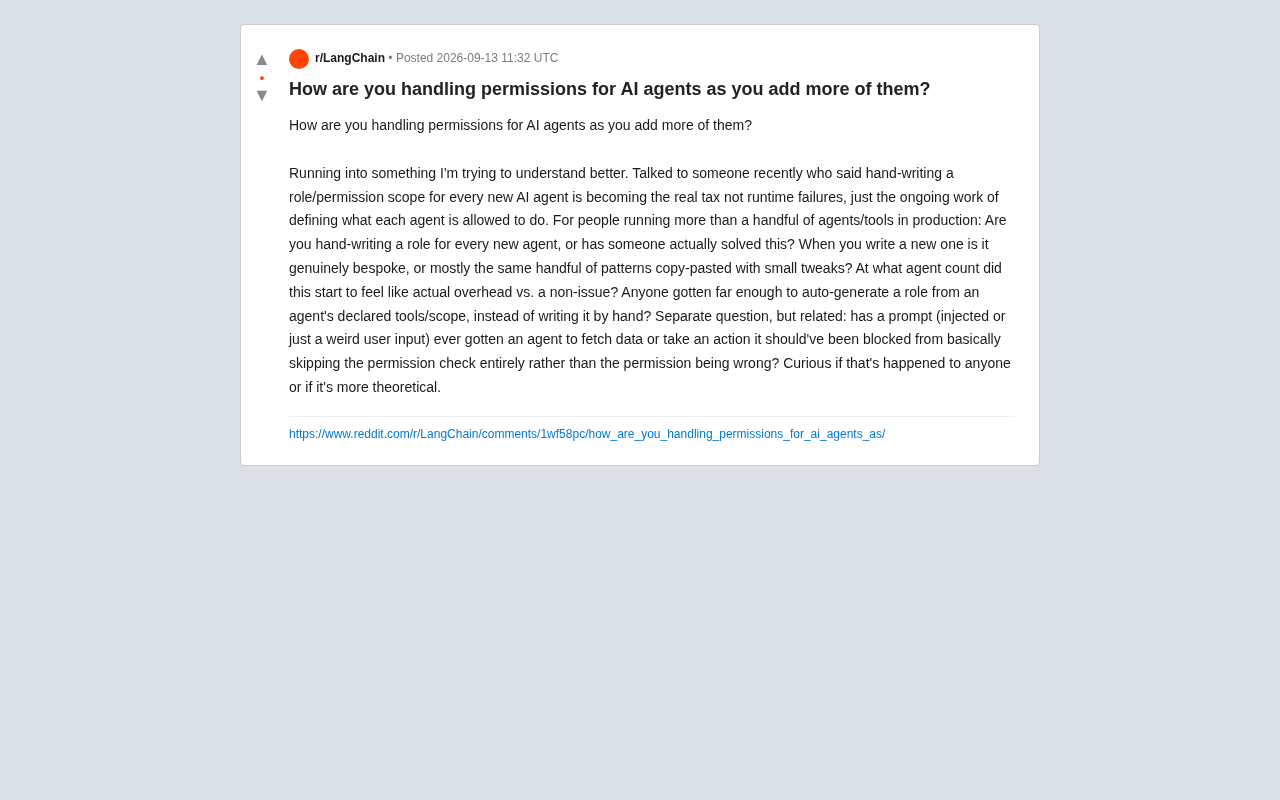
·3 分钟
AI Agent权限管理难题:手写角色成新税负?
随着AI Agent数量增长,手动定义权限角色正成为团队的隐形负担。本文探讨AI Agent权限管理的规模化挑战、自动生成角色的可能性,以及提示注入绕过权限检查的安全风险。
阅读全文 →
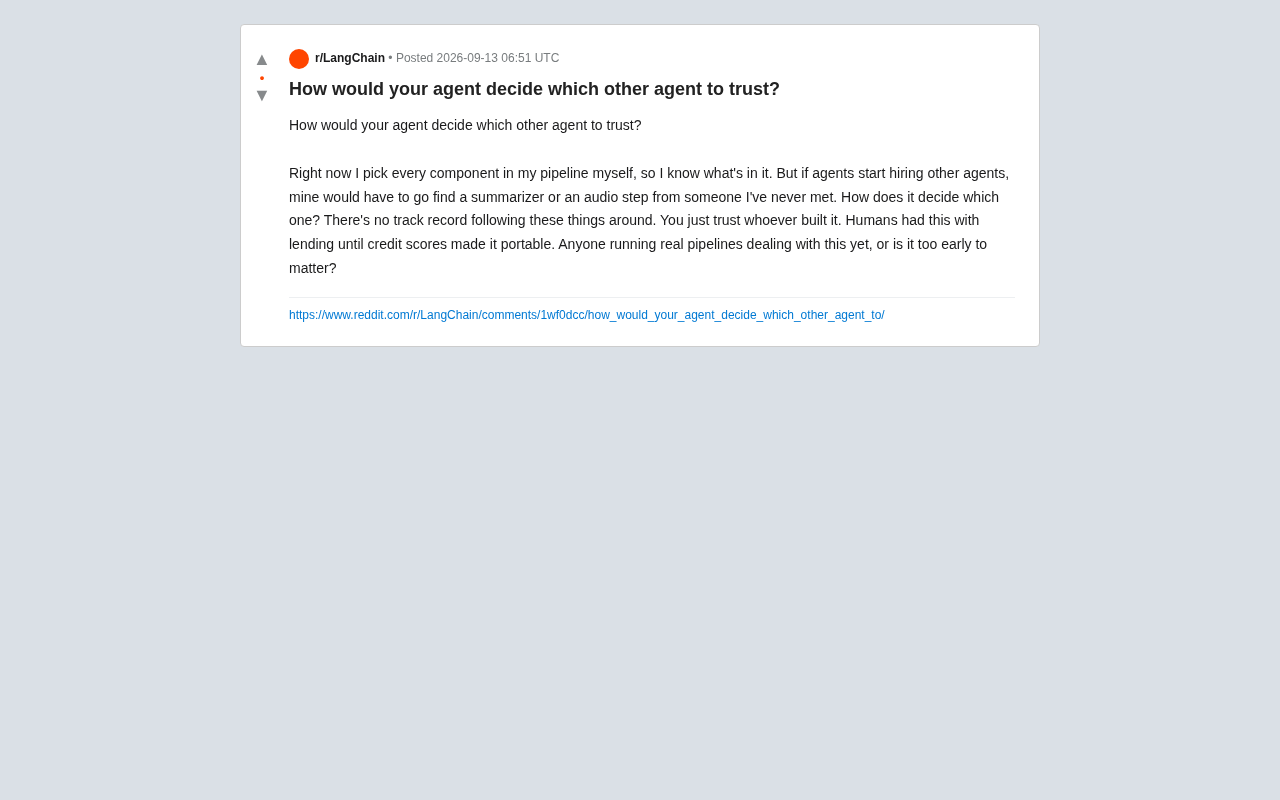
·3 分钟
Agent如何决定信任另一个Agent?多智能体协作的信任难题
当AI Agent开始自主雇佣其他Agent,它该如何决定信任谁?本文从Reddit开发者的真实提问出发,探讨多智能体协作中缺乏可携带信誉体系的核心难题,并类比人类信用评分的演进,展望Agent信任机制的可能解决方向。
阅读全文 →

