2026大模型实测排行:GPT-6、Claude、国产AI差距在哪

八模型四项加权重算,GPT-6 Astra居首,DeepSeek靠成本速度升至第三。
文章对八个受关注的大模型进行二次评分,统一采用 Artificial Analysis 的 Intelligence Index、Terminal Bench、单任务成本和输出速度四项数据,按 60/20/10/10 加权,并把各模型统一到高推理档配置,避免拿省钱档对比满血档。结果显示 GPT-6 Astra 以 82.9 分居首,Claude Fable 5.1 因成本最高屈居第二,DeepSeek V4.1 Flash 凭 0.27 美元成本和每秒 235 Token 冲到第三。国产模型在综合智能上落后约 15%,在长链路 Agent 任务上差距扩大到 17.2 个百分点,但在成本与吞吐上优势明显。作者强调,权重决定座次,单一榜单无法反映真实可用性。
一张榜单看不出真相:为什么综合排名比单项分数更有用
如果你只看一张大模型排行榜,很容易得出结论:分数最高的就是最好用的。但到了2026年,这个判断已经不成立了。一个模型真正好不好用,至少要同时看四件事:能力有多强、Agent和编程能不能把任务做完、一次任务花多少钱、跑得有多快。
B站UP主在这期视频里做了一件更务实的事:把八个最受关注的模型放进同一套规则里重新算分,而不是拼凑各家发布会的成绩表。核心数据统一采用Artificial Analysis截至2026年9月底的Intelligence Index V4.3.2,以及同一套评测里的Terminal Bench 4.0、单任务成本和输出速度。厂商模型卡只用来交叉确认型号、上下文和发布信息,不把自测成绩混进综合分。
这个选择很关键。厂商自测往往使用不同提示词、不同工具链、不同推理档位,甚至同一个Benchmark也不是同一套运行方式。把这些数字横向比较,看起来很丰富,实际很容易制造假精确。
评分规则:四项权重与两个公平性原则
这套二次评分并非Artificial Analysis官方总榜,而是为回答“综合实力和实际使用价值”设计的。四项权重分别是:综合智能占60%,Agent和终端编程能力占20%,成本效率占10%,输出速度占10%。每一项都把八个模型中表现最好的设为100分,其余按相对比例换算,再加权求和。
公平性上有两个原则。第一,推理模型尽量采用公开榜单里的高档或最高档配置:GPT用Max、Claude用Max、Grok用High、DeepSeek广告和Kimi用Max、Gemini用High。这样比的是各家愿意公开给用户的高能力状态,而不是拿省钱档去打满血档。第二,不把上下文窗口和开源与否单独加分。100万上下文不等于100万都能稳定利用,开放权重也不等于推理质量更高,它们是产品特性,不应该偷偷变成能力分。
你可以把这四项理解成真实任务的四个关卡:第一关,模型看不看得懂需求;第二关,能不能调用工具把代码、文件和终端任务做完;第三关,做完这一单花多少钱;第四关,同样100个任务要跑多久。四关全过,才是所谓的综合实力。
Artificial Analysis 是一家独立的大模型评测机构,其 Intelligence Index 并非单一考试分数,而是把数学、科学、编程、指令遵循、长上下文理解等多个基准按统一口径加权合成的综合指数。它的价值在于用同一套运行框架和提示词模板跑所有模型,避免各家拿自测成绩拼表。Terminal Bench 则脱胎于终端环境下的软件工程任务评测,要求模型在真实 shell 里读写文件、执行命令、调试代码并通过测试,考的是多步操作的闭环能力,而非单轮问答的正确率。理解这两个指标的构造方式,才能明白为什么同一模型在两张表上的名次可能相差很大。
综合智能:第一梯队仍是GPT与Claude
先看最核心的综合智能。GPT-6 Astra为53,Claude Fable 5.1也是53,并列第一。接下来是Grok 4.7的46,GLM 5.3和Qwen 3.8 Max都是45,Kimi K3为44,Gemini 3.8 Flash为41,DeepSeek V4.1 Flash为39.5。
只看这一项,第一梯队仍然是GPT和Claude。国产模型最高的GLM和Qwen为45,与53相差8分,换成相对差距大约15%。这个差距不算小,但也不是不可追赶。
Agent与终端编程:差距被放大的地方
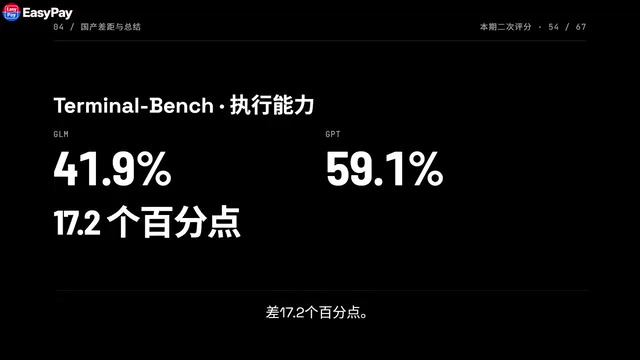
第二张图开始出现变化。Terminal Bench 4.0测试的不是会不会答题,而是模型进入终端后能不能连续完成复杂的软件、机器学习和运维任务。GPT-6 Astra为59.1%,Claude Fable 5.1为52%,GLM 5.3为41.9%,Qwen 3.8 Max为38.9%,DeepSeek为26.8%,Grok大约26%,Gemini为19.7%,Kimi只有13%。
这里能看到一个关键事实:知识很强和真的把复杂任务做完,并不是一回事。举个直观的例子,让模型进入真实代码仓库,先读报错、再定位依赖、再改代码、再跑测试、最后确认没有引入新问题。如果它第一步答得漂亮,却在第三步改错文件,任务仍然失败。这类Agent榜单看的不是回答像不像高手,而是整条链路最后有没有跑通。
成本与速度:国产模型的两张王牌
第三张图是成本。同一套Intelligence Index里完成一个标准任务,DeepSeek V4.1 Flash大约只要0.27美元,Gemini大约1.24美元,Kimi大约2美元,GLM大约2.01美元,GPT-6 Astra为3.26美元,Grok为3.74美元,Qwen为5.41美元,Claude最高约7.63美元。0.27对7.63,差了20多倍。
第四张图更夸张。输出速度上,Gemini 3.8 Flash大约每秒306个Token,DeepSeek大约235个,然后直接掉到GLM的74、Claude的67、GPT的63、Grok大约45、Qwen大约40、Kimi大约35。
单任务成本通常按一次标准评测任务消耗的输入与输出 Token 量,乘以模型官方 API 单价折算,推理档位越高、思考链越长,消耗的 Token 越多,成本随之上升。输出速度则以每秒生成的 Token 数衡量,它直接决定流式交互的体感延迟,也影响批量任务的总耗时。需要注意的是,成本与速度都是随推理档位、并发负载和缓存命中率波动的动态量,榜单给出的只是特定配置下的参考值。对生产环境而言,这两个数字往比几分智能差距更能左右选型决策。
最终排名:能力、成本、速度的三角平衡
四张图叠在一起,最终排名如下:
- 第八名Kimi K3,综合分56.7。综合智能44分其实不低,长上下文和开放权重也很有吸引力,但Terminal Bench只有13%,速度偏慢,两项一起把总分拉了下来。
- 第七名Grok 4.7,63.1分。智能指数46比多数国产模型都高,但Terminal Bench只有约26%,高推理档单任务成本接近3.74美元,输出速度也不快。
- 第六名Gemini 3.8 Flash,65.3分。智能指数只有41,Terminal Bench也只有19.7%,但速度冲到每秒306个Token,成本只有1.24美元。它不是最强的重推理选手,却是最明显的高吞吐选手。
- 第五名Qwen 3.8 Max,65.9分。综合智能45,Terminal Bench 38.9%,能力结构均衡,但每秒约40个Token、单任务成本5.41美元,效率把综合分压住了。
- 第四名GLM 5.3,68.9分。智能指数45,Terminal Bench 41.9%,成本2.01美元,速度74。没有某一项夸张地冲到第一,但四个维度都没有明显短板。
- 第三名DeepSeek V4.1 Flash,71.5分。这个第三名最容易被误解:它的智能指数只有39.5,并不是能力第三。真正把它抬上来的是0.27美元的单任务成本和每秒235个Token的速度。如果你只比最难题谁更强,DeepSeek进不了前三;但把成本和吞吐算进生产环境,它会突然冲到第一梯队。
- 第二名Claude Fable 5.1,80.1分。综合智能53与GPT并列第一,Terminal Bench 52%也明显领先大多数模型。它输掉第一名主要不是因为能力,而是7.63美元的成本在八个模型里最高。
- 第一名GPT-6 Astra,82.9分。综合智能53并列第一,Terminal Bench 59.1%最高,单任务成本3.26美元虽然不便宜,但不到Claude的一半,速度约每秒63个Token。在能力优先但同时考虑真实使用成本的规则下,它拿到第一。
国产AI到底差多少:三个问题的转向
如果只看综合智能,国产最高的GLM和Qwen是45,GPT和Claude是53,差8分,相对差距约15%。再看更考验执行能力的Terminal Bench,GLM是41.9%,GPT是59.1%,差17.2个百分点,这里的差距明显更大。
但把成本和速度放进来,情况又反过来。DeepSeek的综合分71.5,距离GPT的82.9只差11.4分,而它完成同一套指数任务的测算成本只有GPT的一小部分,输出速度却高出数倍。
两年前谈国产模型,大家常问的是基础能力能不能用。现在这个问题已经变了,今天更应该问的是:遇到最难的任务,连续跑10步20步以后它还能不能保持正确;同时跑1000个任务,每完成一单要花多少钱;如果要自己部署权重,是不是能拿到。这三个问题分别对应能力上限、工程效率和部署自由度。
所以2026年的真正结论不再是国产模型能不能追上。在很多任务上它们已经进入同一个竞争区间。最大的差距是最难任务、长链路Agent和复杂终端操作里的成功率;最明显的优势是成本、吞吐以及部分模型的开放权重。
长链路 Agent 任务是当前评测中区分度最高的场景:模型需要在多轮工具调用之间维持状态,处理报错回传、依赖冲突和中间结果校验,任何一步的偏差都会在后续步骤中被放大。这也是为什么综合智能接近的模型,在 Terminal Bench 上可以拉开十几个百分点,误差累积效应远快于单题正确率。开放权重则指模型参数可下载、可本地部署或微调,它对数据合规、私有化部署和二次蒸馏意义重大,但与模型本身的推理水平没有直接因果关系,因此不宜混入能力评分。
排名不是终点,权重决定座次
追求绝对综合能力,第一梯队还是GPT-6 Astra和Claude Fable 5.1。追求能力、成本、速度三者平衡,DeepSeek V4.1 Flash和GLM 5.3已经非常接近第一梯队。真正值得关注的不是谁今天多两分少三分,而是这条差距还在以多快的速度缩小。
这个排名也不是永恒答案。把成本权重拿掉,Claude会更接近第一;把速度和价格继续加大,DeepSeek和Gemini会继续往前冲。所以有价值的不只是记住第一名,而是看懂每个模型为什么站在这个位置。
相关推荐

beacon.sh:为AI编程助手装上自我进化记忆
beacon.sh 是一款开源、可自我进化的 AI 编程代理记忆层,支持 Claude Code、Cursor、Codex 等 20 多个 harness,把代理会话转化为复利式知识层,解决跨工具记忆断层问题。

Xmind 2027发布:思维导图进化为AI思考伙伴
Xmind 2027 在 Product Hunt 发布,主打「AI 思考伙伴」定位。新增 Xmind Agent 支持基于本地文档与导图做研究,并通过 MCP 将导图上下文接入 ChatGPT、Claude 等 AI 工作流。本文解析其产品逻辑、差异化优势与待验证的问题。

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。