beacon.sh:为AI编程助手装上自我进化记忆

beacon.sh 以开源记忆层打通多个 AI 编程工具,让代理经验可累积。
beacon.sh 是一款在 Product Hunt 上线当天冲到榜首的开源工具,定位为「可自我进化的 AI 编程代理记忆层」。它针对的痛点是 AI 编程助手每次会话都从零开始,且 Claude Code、Cursor、Codex、OpenCode 等 20 多个 harness 之间互不相通,项目约定和代码风格需要反复交代。beacon.sh 抓取环境中的代理轨迹,将其沉淀为跨工具的「复利式知识层」,并额外提供运营可见性,把代理活动转化为可观测信号。开源加 SDK 的组合为数据控制和二次开发留出空间。文章同时指出记忆质量控制、多工具格式兼容等仍待验证的问题。
AI 编程助手已经成为许多开发者的日常搭档,但它们有一个共同的短板:每次会话都像失忆一样从头开始。你在 Claude Code 里调教好的项目约定,换到 Cursor 就得重新解释一遍;昨天刚纠正过的代码风格,今天它又忘得一干二净。beacon.sh 想解决的就是这个问题——它把自己定位为「开源、可自我进化的 AI 编程代理记忆层」,在 Product Hunt 上线当天拿下 140 票、19 条评论,冲到当日榜首。
跨工具的记忆断层,才是真正的痛点
beacon.sh 的产品描述里有一句关键表述:它能把跨 Claude Code、Cursor、Codex、OpenCode 以及 20 多个其他 harness 的代理会话,转化为一个「复利式知识层」。这句话点破了当前 AI 编程工具的核心矛盾——每个工具都在强化自己的会话能力,却没有人为你在不同工具之间保留上下文。
对开发者来说,这意味着重复劳动。同一个项目的技术栈约定、命名习惯、测试策略,你得在每个新工具、每次新会话里反复交代。beacon.sh 的做法是抓取你环境中的每一条代理轨迹(agent trace),把这些活动沉淀成可复用的知识,让「每一个代理都比上一个更聪明」。这个「compounding」的提法值得注意:它不是简单的聊天记录存储,而是强调记忆的累积与叠加效应。
从会话记录到运营可见性
除了记忆层,beacon.sh 还强调「运营可见性」(operational visibility)。它捕获代理轨迹后,不只是存起来喂给下一个会话,还把活动本身转化为可观测的信号。对于团队来说,这一点可能比个人记忆更有价值——你能看到代理在你的环境里到底做了什么、在哪些环节卡住、哪些提示词反复被修正。
不过补充一点,原始发布信息对「可见性」的具体形态着墨不多,是仪表盘、日志流还是分析报告,目前无法从素材中确认。这也是评价这类早期工具时需要保留的地方。
「harness」在 AI 编程代理的语境里,指的是包裹在大语言模型外层的运行框架——它负责管理上下文窗口、注入系统提示、调度工具调用、处理多轮对话与权限边界。Claude Code、Cursor、Codex、OpenCode 本质上都是不同形态的 harness,它们共享底层模型能力,却在指令格式、工具接口和会话状态管理上各有一套实现。正因为 harness 层互不兼容,同一份项目约定无法在它们之间直接迁移,记忆也就无法自然延续。beacon.sh 要做的「跨 harness 记忆层」,本质上是在这些运行框架之外再抽象出一层独立于具体 harness 的存储与检索接口,从而让知识不随工具切换而丢失。
「agent trace」(代理轨迹)指的是代理在一次任务中产生的完整执行记录,通常包括模型收到的提示、生成的思考与工具调用、工具的返回结果、文件改动以及最终输出。它比单纯的聊天记录信息量大得多,因为其中保留了代理「怎么想、怎么做、在哪一步失败」的链路。正是基于 trace,记忆层才能提炼出可复用的项目知识,运营可见性也才有原始素材去还原代理的真实行为。不过 trace 通常冗长且噪声密集,如何压缩、去重、标注可信度,是把它转化为有效记忆的前置工程问题。
开源与多 harness 支持意味着什么
beacon.sh 归类为开源、开发者工具、GitHub、SDK,由 Justin D'Souza 发布。开源加上 SDK 的组合,暗示它可能提供可编程的接入方式,而不是一个封闭的黑盒产品。对于关心数据隐私的团队,自托管或本地控制的记忆层显然比把全部代理轨迹交给第三方更有吸引力。
支持 20 多个 harness 是另一个差异化点。当前 AI 编程工具市场高度碎片化,能在多个工具之间搭桥的产品,天然具备网络效应:接入的工具越多,记忆层的价值越大。这也是它能在 Product Hunt 上引起关注的原因之一——开发者苦于工具割裂久矣。
值得观察的几个问题
第一,记忆的质量控制。代理轨迹里既有有价值的项目知识,也有大量试错噪音和错误提示,如何区分并避免把错误记忆带入下一个会话,是这类「自我进化」系统的关键难题。
第二,多工具之间的冲突。不同 harness 的交互格式、上下文窗口、指令风格各不相同,把它们的轨迹统一成一份知识层,工程复杂度不低。
第三,140 票和 19 条评论说明它获得了早期关注,但社区讨论的具体反馈在素材中并未展开,实际使用体验还需要更多用户验证。
对于正在同时使用多个 AI 编程工具的开发者,beacon.sh 提出的思路值得跟进:与其让每个代理各自为战,不如给它们一个共享的记忆底座。至于这个底座能否真正实现「复利」,还要看它在真实项目里的表现。
背景补充
「复利式知识层」(compounding knowledge layer)借用了金融里的复利隐喻:每一次代理会话产生的经验都被存入共享记忆,下一次会话在此基础上起步,于是知识随时间呈叠加式增长,而非每次归零重来。它与传统「聊天历史」的区别在于,复利强调的是筛选与结构化——只有被验证为有效的约定、模式与修正才会沉淀下来,错误和试错噪音应被剔除,否则复利会变成误差的累积。这也是这类系统最考验设计的地方:记忆的写入策略、置信度衰减与冲突消解机制,直接决定了「越用越聪明」还是「越用越偏」。
相关推荐
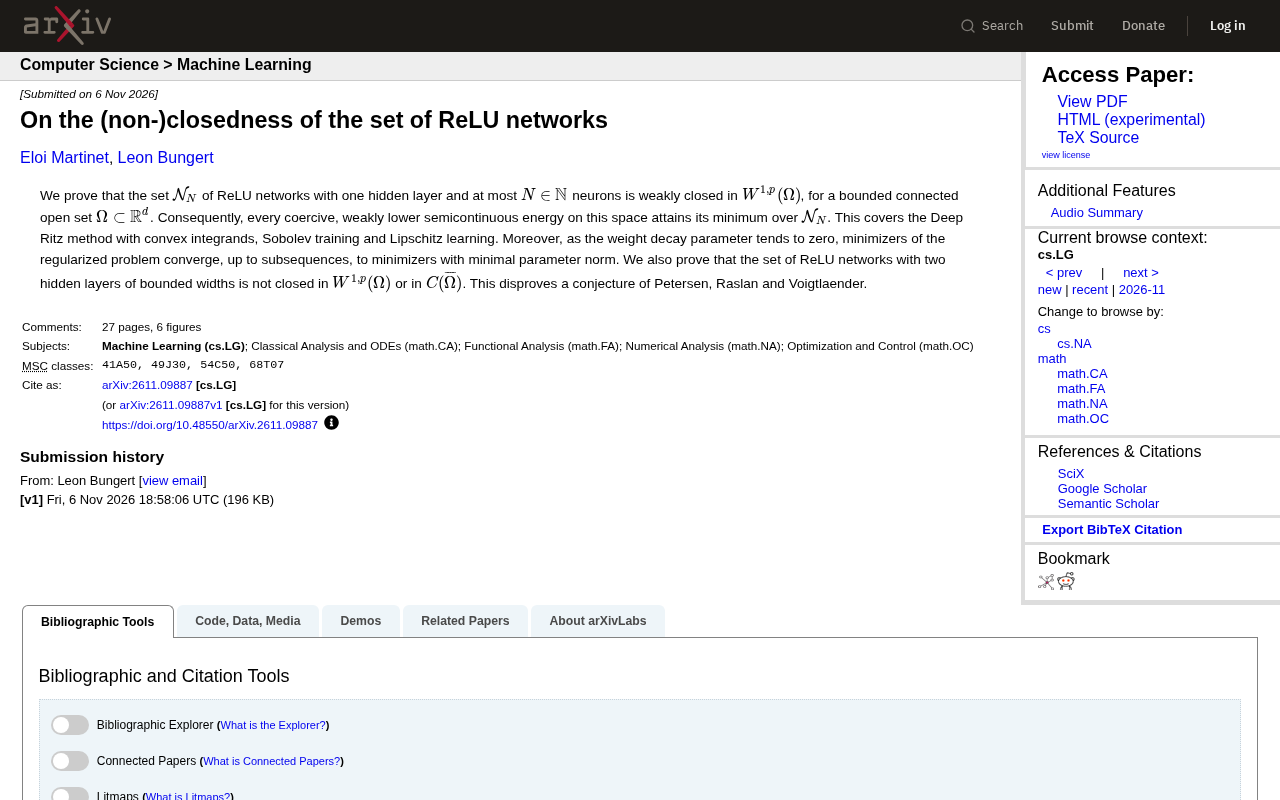
ReLU网络集合的闭性新证:单隐层弱闭,双隐层非闭
新研究证明单隐层ReLU网络集合在W^{1,p}中弱闭,保证Deep Ritz等方法解的存在性;而双隐层网络集合非闭,推翻已有猜想。
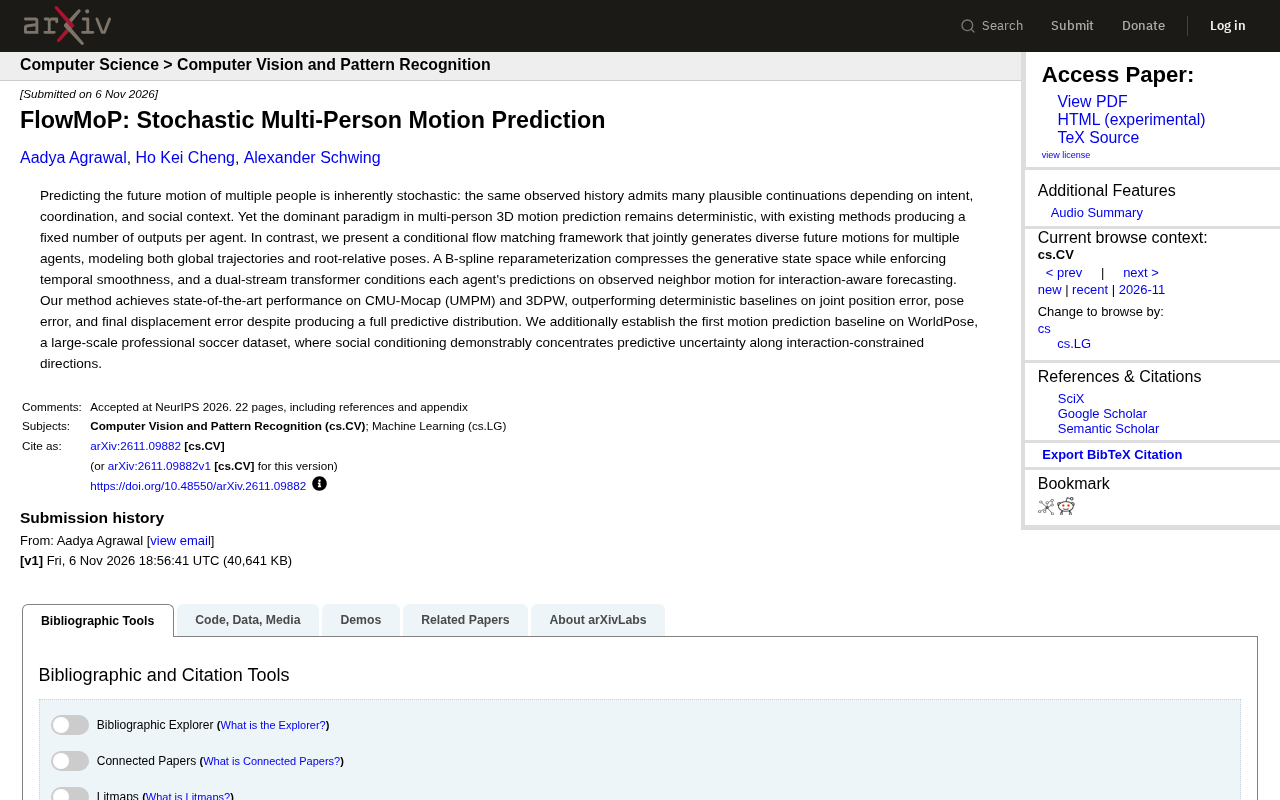
FlowMoP:随机多人运动预测新框架
FlowMoP提出条件流匹配框架,联合生成多个智能体的多样化未来运动,通过B样条重参数化与双流Transformer实现交互感知预测,在CMU-Mocap和3DPW上超越确定性基线,并建立WorldPose首个运动预测基线。
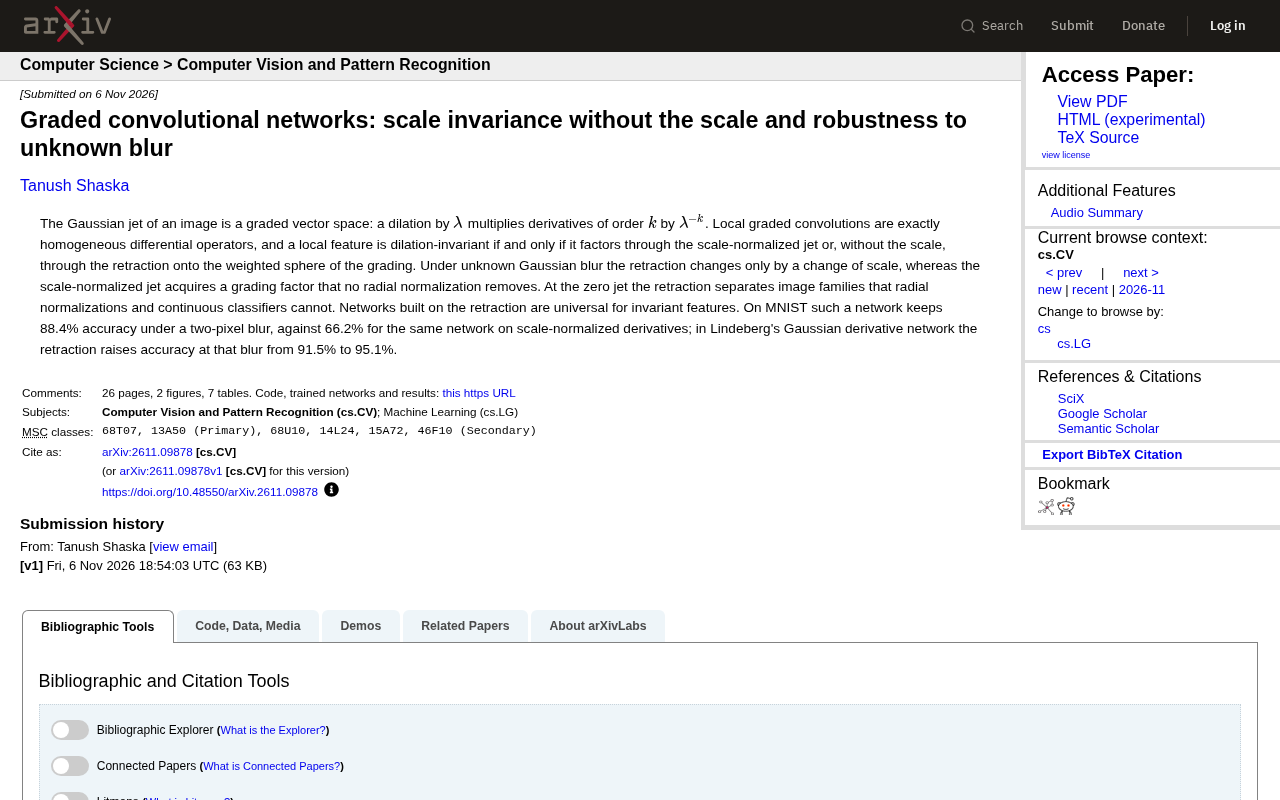
分级卷积网络:无需尺度参数的尺度不变性与抗模糊鲁棒性
分级卷积网络利用图像高斯射流的分级向量空间结构,通过回缩操作实现无需尺度参数的尺度不变性,并在未知高斯模糊下显著提升鲁棒性。MNIST实验显示,两像素模糊下准确率保持88.4%,优于尺度归一化导数的66.2%。